qwen3.8-flash-next可能因为模型是实验性质,各推理引擎优化程度不高;其参数量不上不下,个人部署太大不如27B,企业部署又嫌太flash;同时其协议不是apache或者mit,对第三方部署卖api有限制,阿里自己的api又很贵,所以用的人不多。但是我在实际使用中发现这个模型有很多可取之处,可能是最被低估的3.8-flash。
这边因为保密要求,模型都是内网自己部署的开源模型。单个开源模型的能力比不上闭源sota,所以我一直在想让多个模型高效协作的方案,目前采用的是受@ribbons-digital/pi-advisor启发的advisor范式,在dsh上自己实现了一个多席位的版本。这个advisor是被动式,主agent(executor)不知道advisor的存在,advisor作为后台continuable subagent持续观察用户和executor的输出以及工具调用,在executor跑偏时发出note,作为steer插入executor上下文。和另一个advisor插件@juicesharp/rpiv-advisor的主动式(executor显式通过工具调用给advisor发全量上下文及等待评价)设计完全相反。被动式的好处是executor不需要等待advisor,可以按照自己最大速度运行,也更好支持多个advisor席位。
ds4p蛆了所以ds4.1f上了以后就把ds4p下了,空出来一台H200部署点新模型。目前部署的是:
- B300:kimi-k3,executor,单请求约120t/s
- H200:glm-5.3,单请求约110t/s
- 半台H200(4卡):glm-5.3-flash,单请求约180t/s
- 半台H200(4卡):qwen3.8-flash-next,yarn到了1M上下文,单请求约300t/s
- H800:deepseek-v4.1-flash,单请求约300t/s
实际开发了几个项目和做了一些数据分析,以C++和python为主,也包括这个advisor插件(ts),然后我让dsh自己分析了一下:
根据现在所有的advisor session, 评估glm-5.3、glm-5.3-flash、qwen3.8-flash-next、deepseek-flash在作为kimi-k3 executor的advisor时的价值,包括:
- 提出的advise的质量,被executor确认接受的比例;
- 提出的advise是否足够独立,还是总是和别的advisor一起发现同一个问题;
- 提出的advise的数量与实效性(advisor本身的速度),是否能在executor犯错前阻止还是通常在executor完成后才弥补。
评估结果:
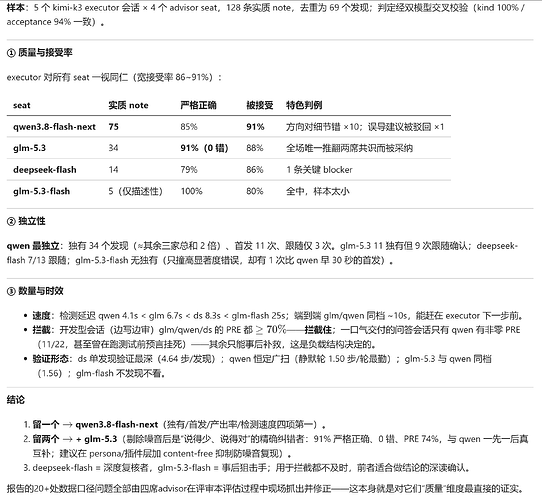
结果发现qwen3.8-flash-next可以说是又快又好,能以最快的速度独立发现问题,正确率也不低,甚至kimi写完测试跑之前就能断言这个测试会挂。在使用中经常看到qwen指导kimi干活的奇观。我一开始怀疑是qwen幻觉比较多,怕把kimi带歪,但是实际检查发现qwen提的基本上是正确的,kimi收到note后自行复核也承认。glm-5.3是最准的,能抓到最细微的错误。反而是glm-5.3-flash在已经有glm-5.3在场的情况下额外价值非常低,其输出与glm-5.3高度重合,速度甚至也没有快多少。deepseek在审查方面表现中规中矩。
我问kimi-k3为什么能被advisor找到那么多错误,是不是应该换个模型来当executor,它思考了半天说:“advisor只需要专心挑人毛病,executor需要考虑的东西就多了 ^-^”

 匿名者 09-15 13:291楼
 shyrock 09-15 14:483楼