前言:很多佬问我之前的文章的图片是怎么做的
先说背景,某互联网金融大厂,参与预测模型的训练,现负责 FDE 团队,说背景是不想花很多功夫证明自己技术能力(好像也没有啥技术能力)
分享实操过程中我个人基于经验构建的思维框架,不是正经的学术讨论,各位当小说看就好了,也好完善自己的思考体系来指导实际工程架构的搭建,科研佬手下留情
Changelog:
● init
├───╮
│ ● A…
经常看到朋友和同事在 Vibe Coding 时吐槽 AI “听不懂人话”: “高级感”、“眼前一亮”,“再改改”,结果页面越改越乱。可能并非 AI 能力不够,更多是因为我们采取了“玄学抽卡”的策略。我们无法将思考外包给模型,但是 AI 时代的学习范式也得改变。
LLM 在 Pre-training 与 RL 阶段均基于海量代码数据训练,对英文专业术语的语义锚点远强于中文(且中文语义信息熵过高,…
…
整理技巧的时候感觉会触及更深的哲学层面的思考
GPT 现在的多模态能力已经很强,随手一张截图贴进对话框就能代替大段的文字描述
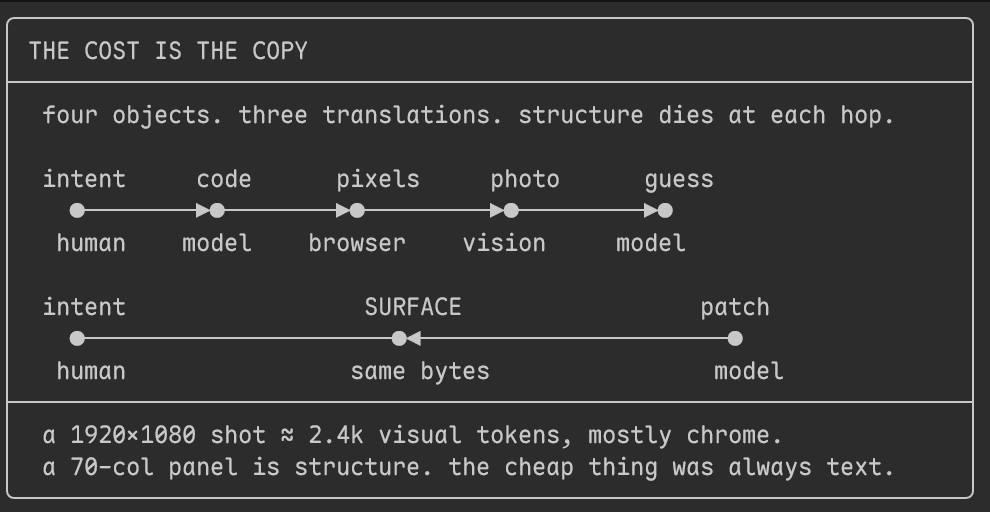
但对模型而言,一张截图往往意味着几百甚至数千视觉 token ,其中包含大量和任务无关的颜色、样式和像素,使用非常方便,但在长程、工业级场景下会成为推理负担,以 OpenAI 一张 1920 × 1080 截图为例:
模型与模式 |
处理方式 |
约占 |
|---|
GPT-5.6 low |
缩放到 512×288,再按 32px patch 计算 |
173 tokens |
GPT-5.6 high |
60×34 个 32px patches,再乘 1.2 |
2,448 tokens |
如果代码报错时面对几百行报错日志,你会:
1.截图甩给模型
2.复制原本文本给模型
3.自己修复
没有理由不选 2,截图反而要求模型额外处理颜色、边框、排版等与问题无关的噪声
一种理想的多模态交互模式是让图片成为持续对话的载体: 人类在上面圈圈点点,模型理解意图后执行并更新图片
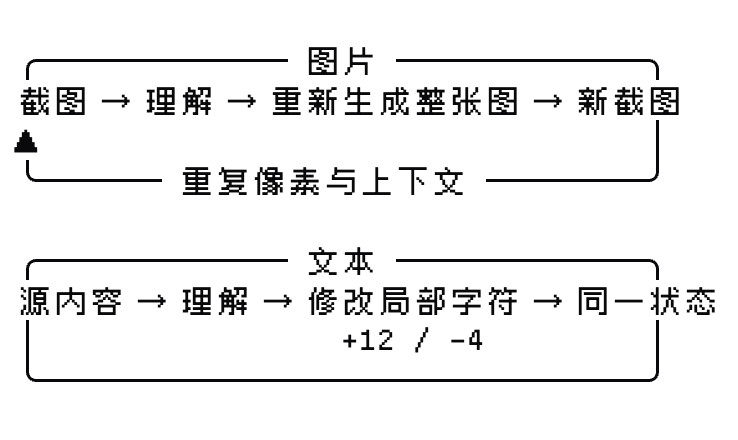
但模型能力距离这个目标还很远,当图片在多轮对话被反复传递时,相同的视觉内容会被重复处理,并持续占用上下文;图片适合一次性传递信息,但不适合充当人和模型之间长期共享、持续修改的状态
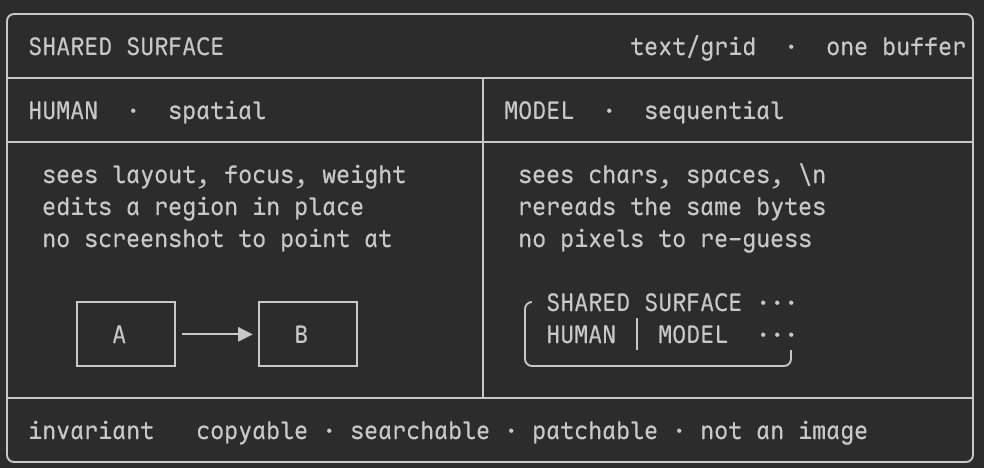
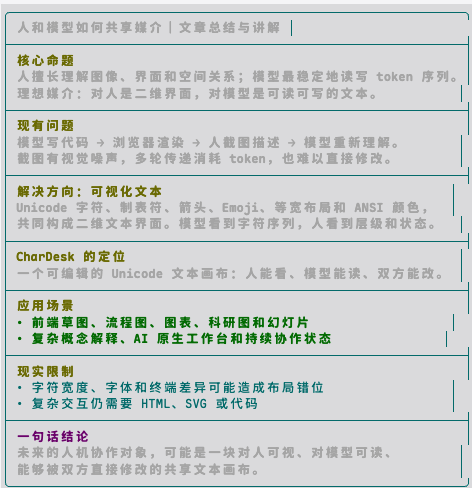
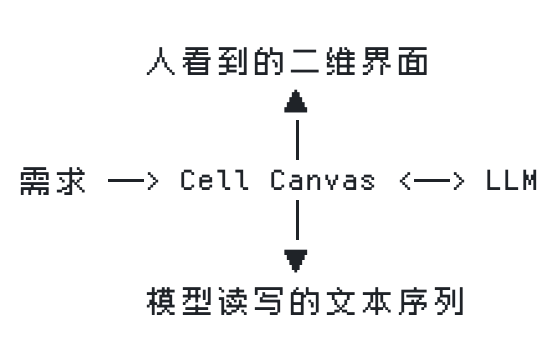
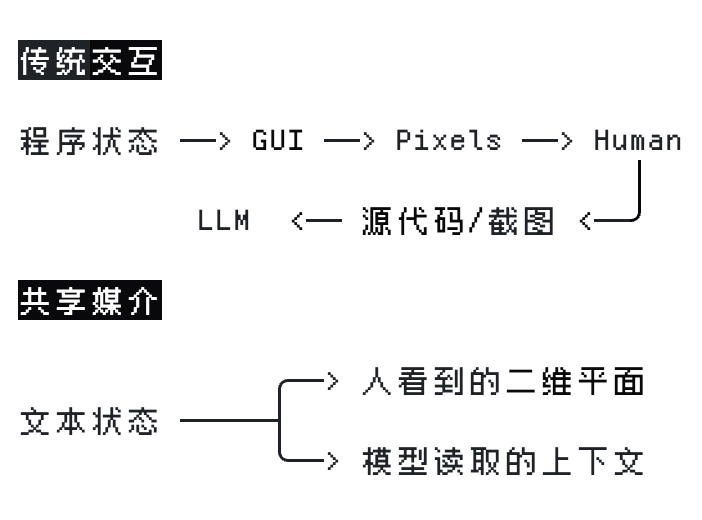
人和 LLM 擅长的信息形态并不同:人擅长从二维场景快速捕捉关系: 图像、GUI 和图标让层级与状态一目了然;而 LLM 稳定的读写接口是 token 序列,无论内部计算多复杂,语言最终以线性符号序列进出上下文
过去我们不断提升多模态能力,让 LLM 能适应 GUI;另一边,我们也只能消费 LLM 大量生产的纯文本
Markdown 等标记让纯文本有了层级与强调,HTML 进一步证明结构化文本可以被渲染成人类易读的视觉界面.可对于几十轮的持久对话来说,每轮都重新生成一套页面太重了
理想的媒介是让模型直接生成,人可以就地消费
我们需要找到一个更轻、更稳定、并且可以直接进入模型上下文的二维媒介——
对人类呈现空间、层级和视觉重点;而对模型却仍然只是一段可读、可写的文本序列
GPT-4o 发布时很爱输出 Emoji
这种表达被过度使用后变成了典型的 ai 味
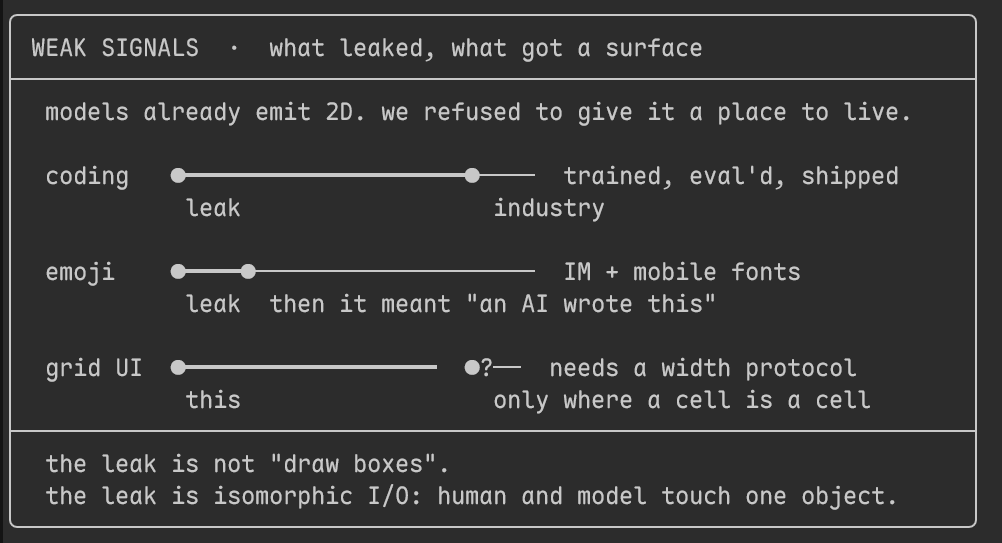
模型的偶发行为会泄露其潜在能力的形状; 人类能否识别这些弱信号,并为它们找到合适载体,决定了潜力能否成为真正的能力
coding 本来只是预训练语料的一部分,早期 LLM 偶尔表现出的补全和代码生成能力让人们发现可能存在的独立的道路,随着代码语料、指令训练、评测不断聚集,最终将潜力放大成了如今的 coding agent
Emoji 揭示的一种更普遍的能力: 字符可以同时具备语言和图形属性;对模型仍以文本 token 序列进入上下文,对人却可以显现为表情、方向、结构和状态
LLM 的能力很大程度上来自网页、代码、文档等互联网数字语料; 而这些语料最终又是建立在计算机的文本协议底座:Unicode
我们通常说模型掌握了语言、代码、数学,从更底层来看,这些内容都是通过字符作为载体进入训练语料,这些字符都被编码在 Unicode 中,而 Emoji 只是很小的一片区域
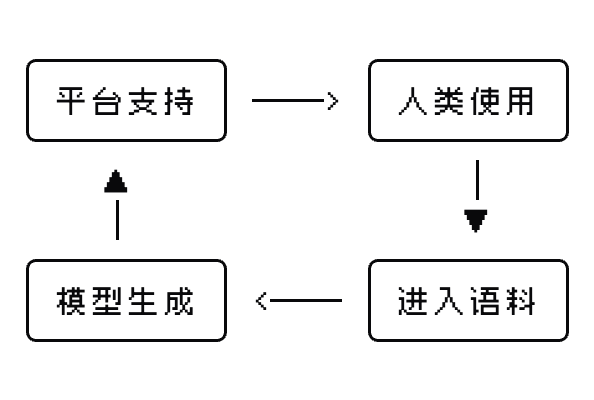
它之所以被我们熟知是因为抽中了平台彩票: 移动设备时代,Apple、Android 和主流应用为 Emoji 提供了稳定的字体、输入法和渲染支持
平台不仅承载能力,也在选择哪些能力能够被看见
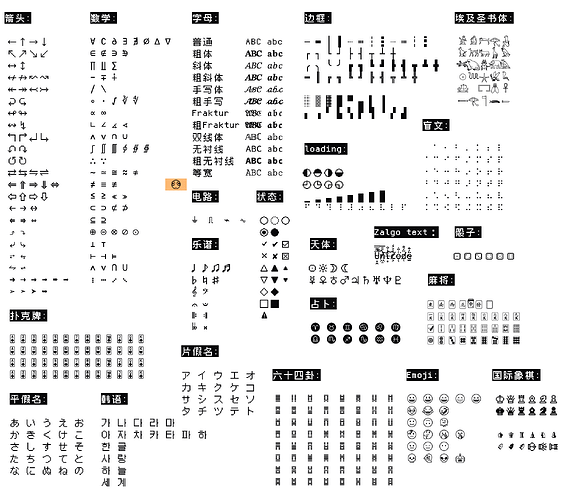
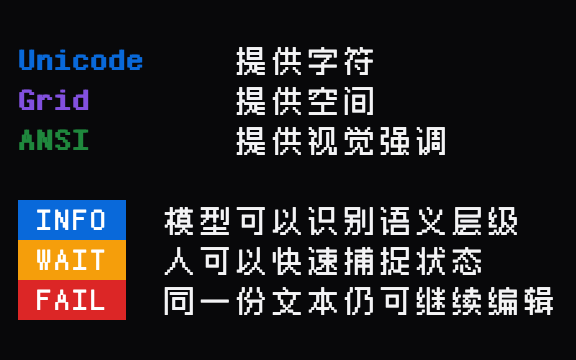
而在 Emoji 之外,Unicode 还保存着箭头、数学符号、制表符号、盲文、音乐记号、埃及圣书体等大量视觉原子:
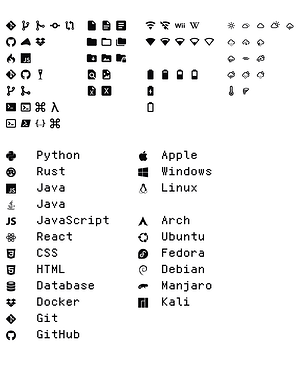
以及丰富的私有选区,nerd font:
可是,模型能够输出字符,不代表人类的设备能够稳定显示它;字符能够显示,也不代表它们可以组成可靠的二维结构
要把这种潜能真正释放出来,还缺乏稳定的显示,比如
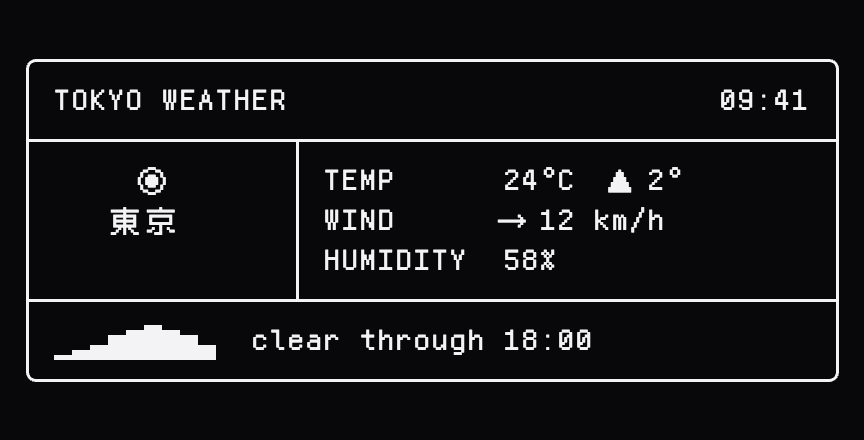
人会自然地把它理解成一个完整界面: 左侧是天气,右侧是数据,底部是一条温度趋势
在模型的上下文里,并不存在图形对象,它接眼中只是一条线性的字符序列:
╭────────────────────────────────────────────╮\n│ TOKYO WEATHER 09:41 │\n├──────────────┬─────────────────────────────┤\n│ ◉ │ TEMP 24°C ▲ 2° │\n│ 東京 │ WIND → 12 km/h │\n│ │ HUMIDITY 58% │\n├──────────────┴─────────────────────────────┤\n│ ▁▂▃▅▆▇▆▅▃ clear through 18:00 │\n╰────────────────────────────────────────────╯
同一份内容,对模型是字符和换行组成的序列,经过稳定显示以后,对人却成为了二维界面
文本天然只保证字符的先后顺序,并不保证每个字符在屏幕上占据相同空间
如果不规范显示协议,它可能会变成这样:
╭────────────────────────────────────────────╮

│ TOKYO WEATHER                       09:41 │

├──────────────┬─────────────────────────────┤

│      ◉     │ TEMP      24°C  ▲ 2°        │

│    東京      │ WIND      → 12 km/h         │

│              │ HUMIDITY  58%               │

├──────────────┴─────────────────────────────┤

│ ▁▂▃▅▆▇▆▅▃  clear through 18:00            │

╰────────────────────────────────────────────╯
英文、中文、符号和空格各自占据不同宽度,原本相连的边框会断开,分栏和数据也会逐渐偏离
模型表达的字符没有发生变化,人看到的内容却已经不是同一张图
我们会让 LLM 使用 加粗、斜体 和 删除线,这些符号没有改变文字的内容,却改变了我们消费的习惯
颜色其实也是 LLM 参数的一部分: 早期计算机使用 ANSI 为终端文字附加颜色
它同样广泛存在于互联网和代码语料中,因此不需要重新发明一种模型从未见过的表达方式
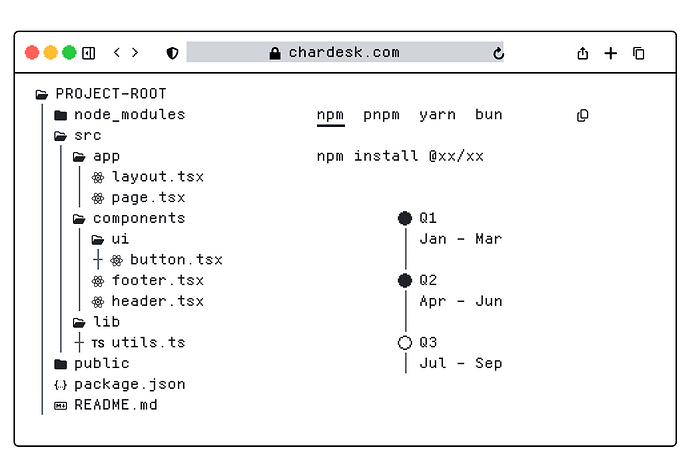
到了这里,文字仍然是文字,却已经可以拥有方向、边界、位置、颜色和状态
它不是图片,仍然可以被复制、搜索、修改,可以直接进入模型上下文; 但对人而言,它也不再只是一条需要从头读到尾的文本流
协议稳定后我们可以做到什么?
消费链路转变
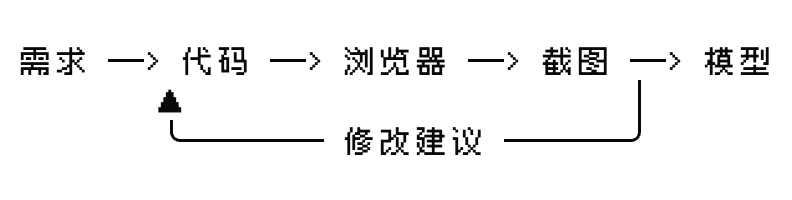
今天让模型参与前端设计,通常需要在几种媒介之间反复转换
模型生成代码,通过浏览器查看效果; 人指出问题时,又要把界面重新截图、描述或转换回代码
界面与模型理解的内容始终不是同一件东西
如果二维界面本身就是文本,这条链路可以缩短为:
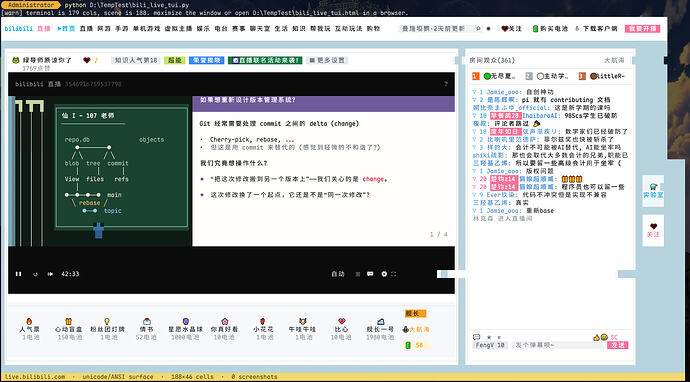
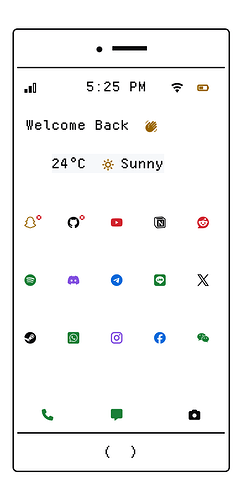
模型可以直接生成一张前端草图:
人看到的是产品形态,而模型看到的则仍然是字符、空格、换行和 ANSI 状态
它不需要通过截图重新识别自己刚刚生成的界面,也不需要从像素中猜测哪个区域是按钮、哪个数字发生了变化
人修改这张草图,也是在修改模型能够直接继续读取的内容
传统交互中,看到界面,模型读取截图、描述或转换后的代码.双方接触的是同一对象的不同副本,每轮交互都需要重新翻译
一些使用场景(纯文本生成):
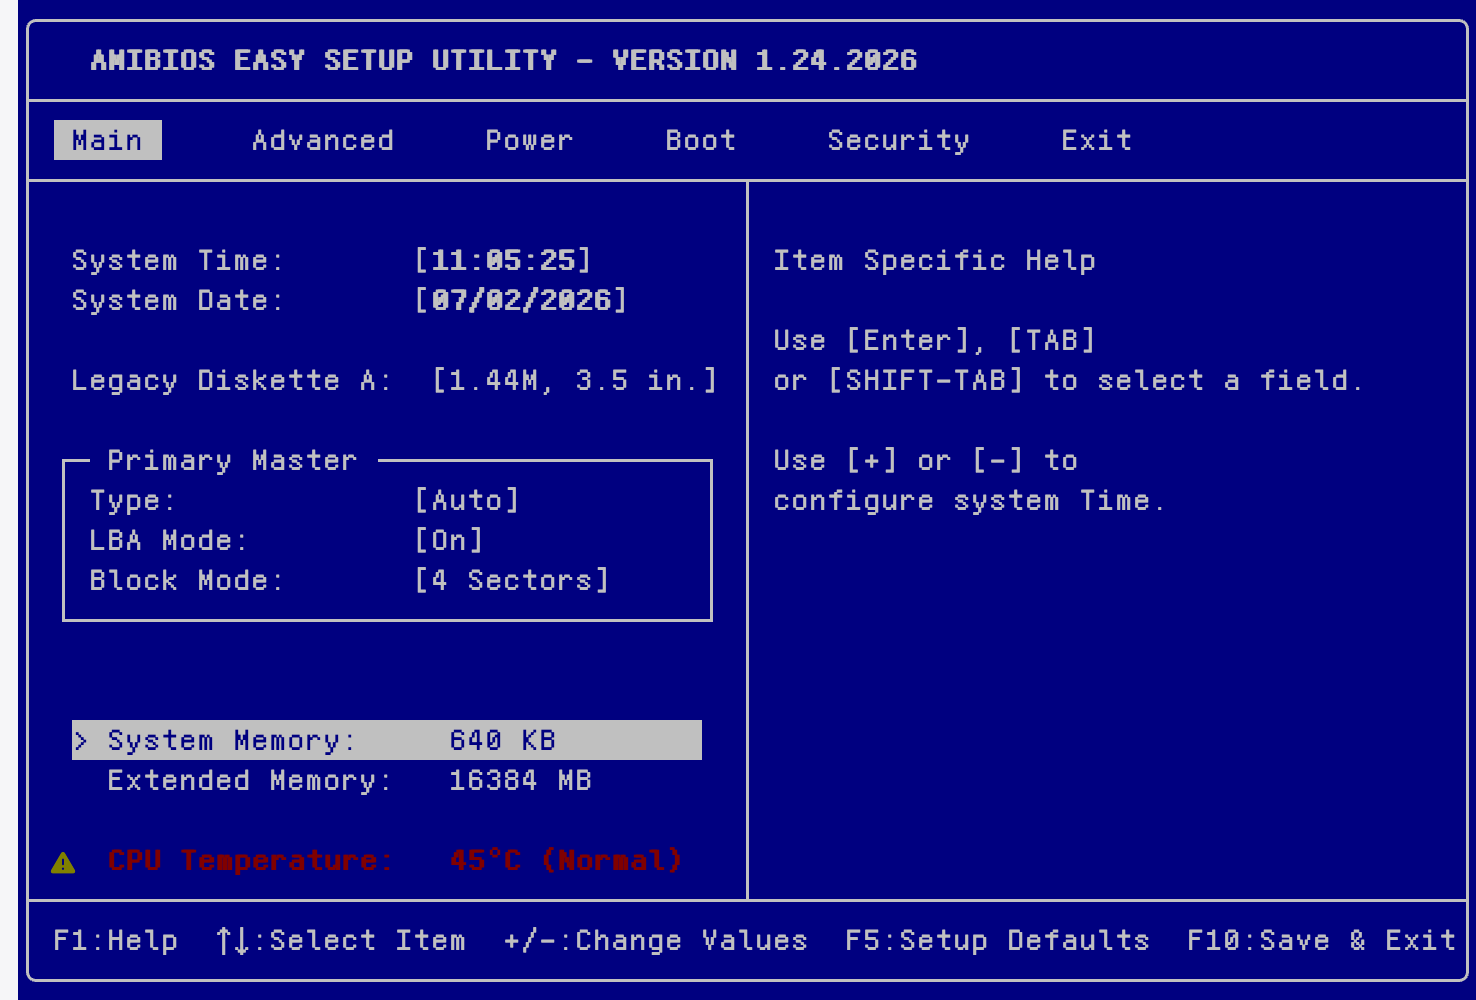
前端设计:
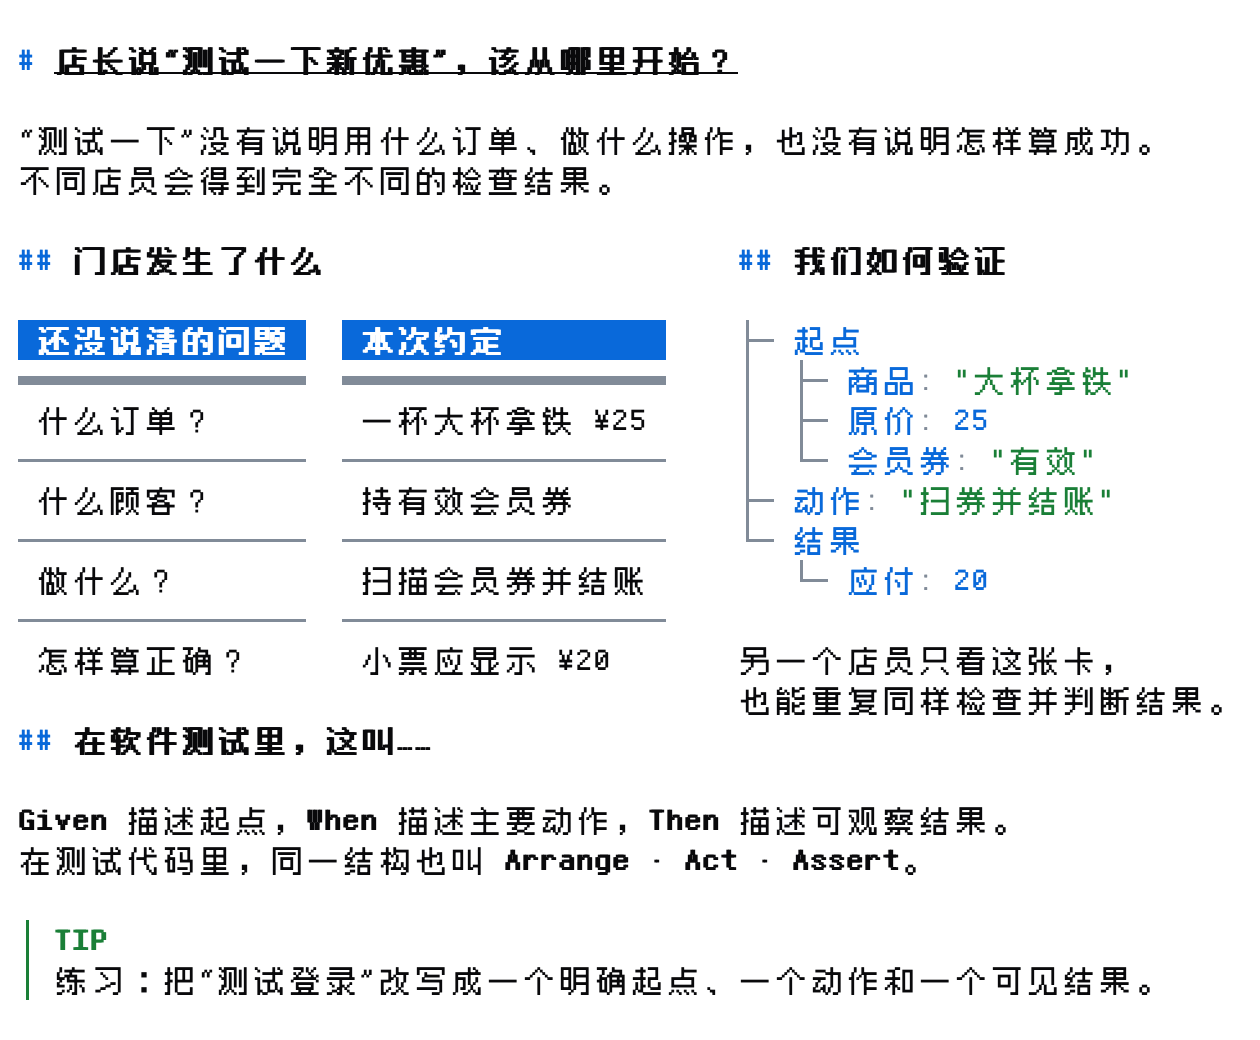
人可以直接看到设计界面;模型不需要读取截图或者源代码.人调整文字或布局以后,同一份文本又可以直接回到下一轮上下文
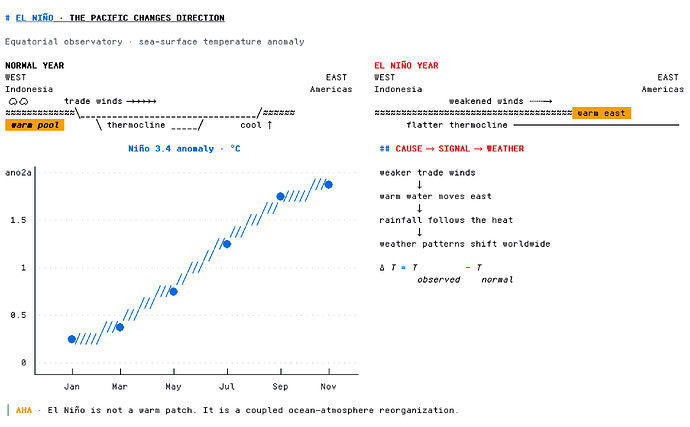
解释复杂概念:
生成插图:
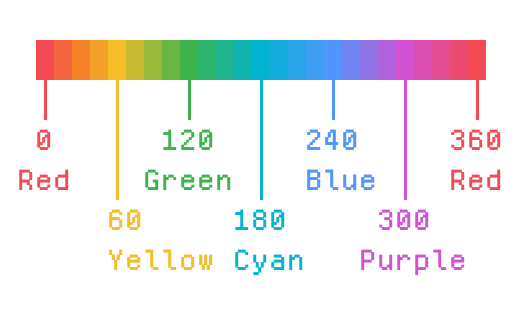
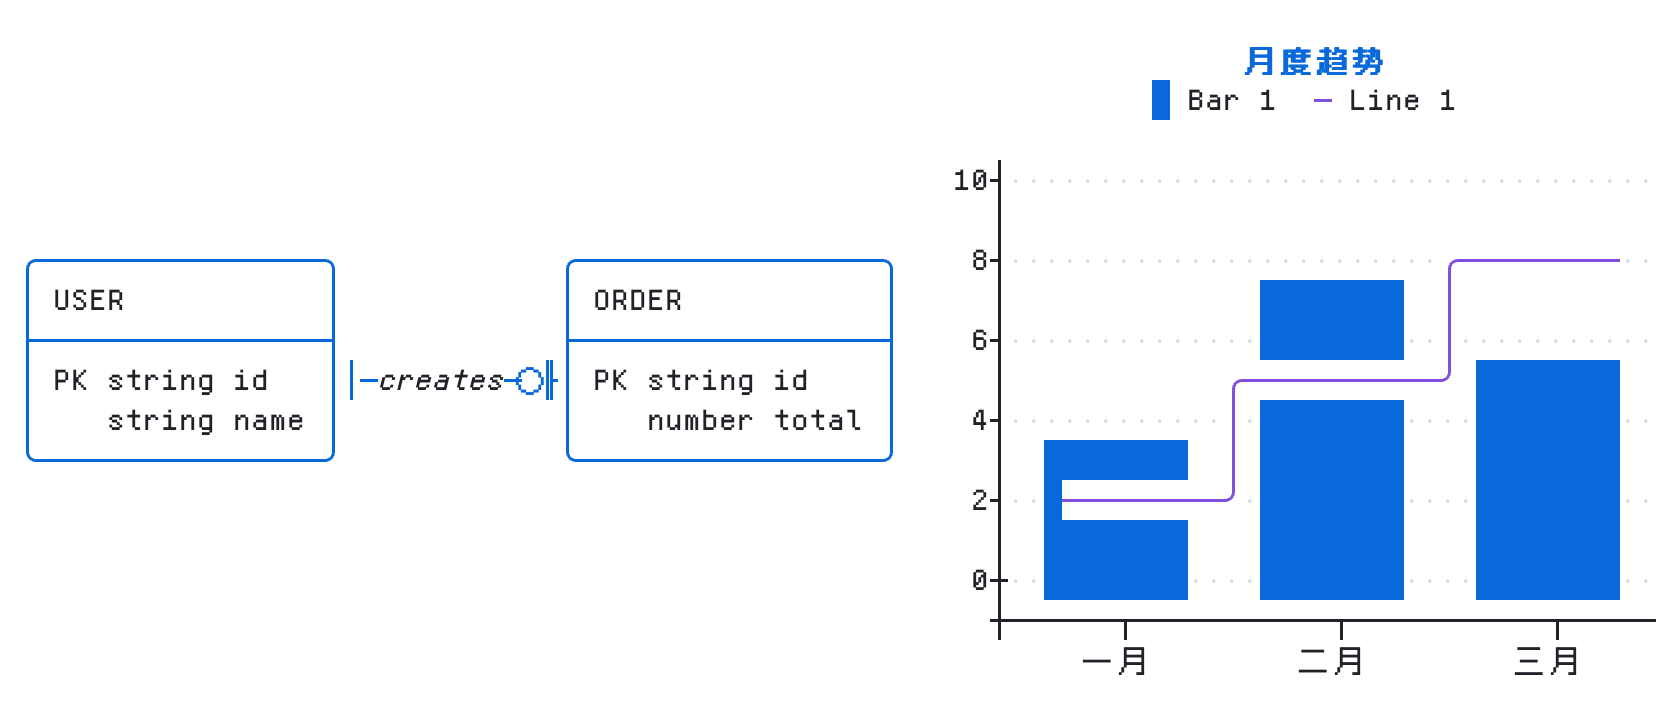
流程图和图表:
科研图/slide:
甚至ai时代原生的llmos:
对人是界面,对模型是文本,而它们是同一个对象


 十元 09-15 10:271楼
 ShakaQAQ 09-15 10:333楼
 myspeedon 09-15 10:454楼
 phaseddd 09-15 11:045楼
 老文 09-15 11:286楼
 conger 09-15 11:407楼
 路人甲 09-15 11:468楼
 safuhaba 09-15 19:2415楼