上次发过一篇 [完全免费] 在 Reddit 发帖老被删?我做了个工具帮你找社区、读规则,介绍了 Karmit(https://karmit.co)的两个功能:
Reddit 社区地图,和社区分析。
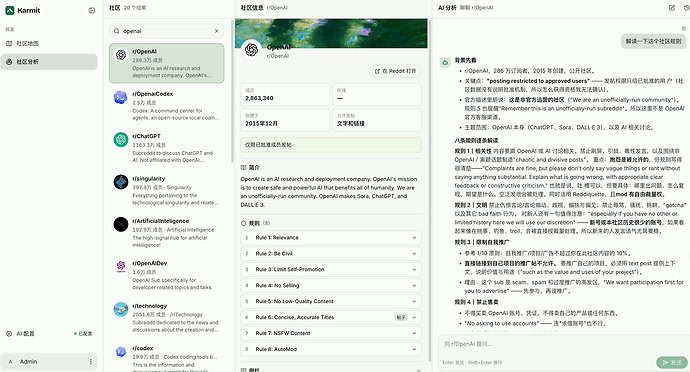
那之后收到几条反馈,指向同一个问题。
原来的搜索有个前提:你得先知道社区叫什么
地图也好,社区分析也好,本质都是已知社区名去查。你输入 saas,它给你 r/SaaS。
但真实情况往往是反过来的:我知道自己要干嘛,不知道该去哪儿。
“我做了个给独立开发者用的效率工具,想找早期用户,该发哪儿?”
这句话里没有任何一个 subreddit 的名字。拿它去关键词搜索,Reddit 只会拿整句去做字面匹配,什么都搜不到。
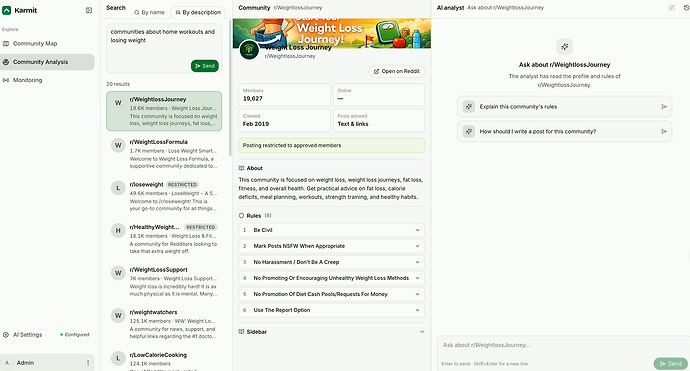
所以这次加的是第三个功能:按描述搜社区。你写一句需求,它找出该去的地方。
第一步:把 11.5 万个社区的描述抠出来
地图那份数据里有一个subreddit表,1.5 MB,11.5 万行,每行一个 subreddit 名字。名字有了,但没有任何描述——地图上只有点,没有文字。
于是先做了一轮补充,给每个社区补上简介:
- 115,817 个社区名,
- 1,159 次请求,
- 耗时 57 分钟,
- 总共 30 MB 语料
下面是数据补充完的统计,这些数字我觉得挺有意思:
指标 |
数值 |
|---|
有公开简介的 |
107,332 个(92.7%) |
简介长度中位数 |
115 字符 |
订阅数中位数 |
3,844 人 |
一万人以上的 |
43,105 个 |
最大的社区 |
6,759 万人 |
92.7% 这个覆盖率比我预期高不少——本来担心一堆社区简介是空的,那样语义搜索就没东西可匹配。实际只有 4.9% 的社区简介是空的。
订阅数中位数只有 3,844,说明这 11.5 万里绝大多数是小社区。
这其实正是语义搜索该发光的地方:大社区你搜关键词也能找到,小而精准的那些才是价值所在。
第二步:灌进向量库
- 嵌入模型:
@cf/baai/bge-m3。选它主要因为多语言——你用中文描述需求,能直接匹配英文的社区简介,不需要先翻译一遍。
- 向量库:115,813 条向量,合计 1.186 亿个维度。
第三步:发现纯向量搜索不够用
建完库一测,发现一个很明显的分界线。
"找一个讨论 X 的社区"这类问法,效果很好:
我在找讨论居家健身和减脂的社区
→ bodyweightfitness · GYM · loseit · xxfitness · homegym
我想找二手机械键盘的交易社区
→ mechmarket · MechanicalKeyboards · hardwareswap · keycaps
中文进、英文语料出,bge-m3 的跨语言能力完全够。
但"我想推广我的 X"这类问法,直接崩:
我想给我的 B2B SaaS 工具找早期付费用户
→ INeedMoneyNow · SaaS · hotdommes · SwagBucks · TheGoodPlace
六条里只有一条对的。
原因不难想:这句话的主语是"推广"“找用户”“付费”,向量就被拖到了求助和赚钱类社区去,而不是 SaaS 领域。
解法是加一步改写:先让模型把"我的目的"翻译成"社区的自我介绍",再拿改写后的文本去检索。
原文:我想给我的 B2B SaaS 工具找早期付费用户
↓
改写:A community for SaaS founders and indie hackers discussing
building, launching and growing software products…
↓
结果:SaaS(0.681) · Entrepreneur · startups · indianstartups
六条对五条。相似度分数也从 0.55 一档跳到 0.68。
还有个我没料到的坑:措辞风格比内容更重要。
「想找讨论 Rust 编程语言的地方」
堆术语的改写(“systems programming, cargo, borrow checker, async”)
→ r/rust 连前 50 都进不去,全是游戏 Rust 的社区
平实口吻的改写(“a community about the Rust programming language,
where developers share crates and ask questions”)
→ r/rust 排第 1
术语堆砌反而让模型抓不住重点。
第四步:用 jev 做重排
jev — 最新比较火的一个专门做分类判断的模型,很多人拿他做量化,做computer use,做意图识别,这里我用它来做重排。不仅是价格很合适,速度也非常快。
索引里有三十多个关于游戏 Rust 的社区,关于 Rust 语言的只有一个。它们的简介用词几乎一样——“A community for Rust…”。余弦相似度分不出哪个是编程语言、哪个是生存游戏,它只知道这些文本像。
结果就是 r/RustPc(1.6 万人)排在 r/rust(42 万人)前面。
这种判断需要的不是"像不像",是"是不是"。所以接了流行的 jev — 给它一个问题和若干选项,它返回概率分布。
用法很直白,一次请求搞定:
{

  "state": { "need": "我想给我的 B2B SaaS 工具找早期付费用户" },

  "model": "jev-latest",

  "questions": {

    "answer": {

      "type": "choice",

      "instructions": "这些社区里,哪个最适合 need 描述的这个人?

                       只看每个选项自己的描述说它是关于什么的、谁在那发帖。

                       一个只是碰巧和需求共用了同一个词、

                       但说的是另一回事的社区,不算匹配。",

      "criteria": {

        "SaaS":         "r/SaaS — Discussions and useful links for...",

        "startups":     "r/startups — ...",

        "Entrepreneur": "r/Entrepreneur — ..."

      }

    }

  }

}
最后那句 instructions 是专门为 Rust 这个 case 写的,效果立竿见影。
成本也低得出乎意料:一次请求约 810 token,jev 是 $0.042 / 百万输入 token(输出免费),算下来 $0.000034 一次搜索,3 万次搜索一个月 $1。
最终的链路
用户:“我想给我的 B2B SaaS 工具找早期付费用户”
│
├─ 改写成社区简介口吻(英文)
├─ bge-m3 编码
├─ 向量检索
├─ jev 重排
└─ 按概率排序,相似度和社区规模做同分时的次级排序
现在的状态:
最新的功能在 Subreddit Analysis — rules, hot posts and AI insights | Karmit ,还是完全免费,不需要登录就能用(AI 对话那部分需要登录)。
- ^-^ 社区地图 — 11.5 万个社区按"用户重合度"铺开
- ^-^ 社区分析 — 查简介、成员数、完整版规
- ^-^ 按描述搜社区 — 说需求,找地方

 多宝星君 09-22 15:351楼
 旧寂新城 09-22 16:333楼