
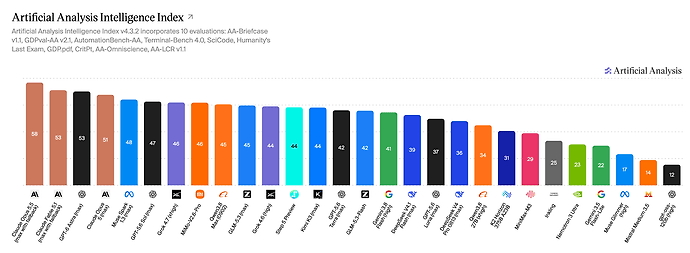
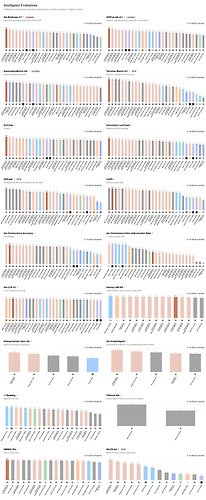
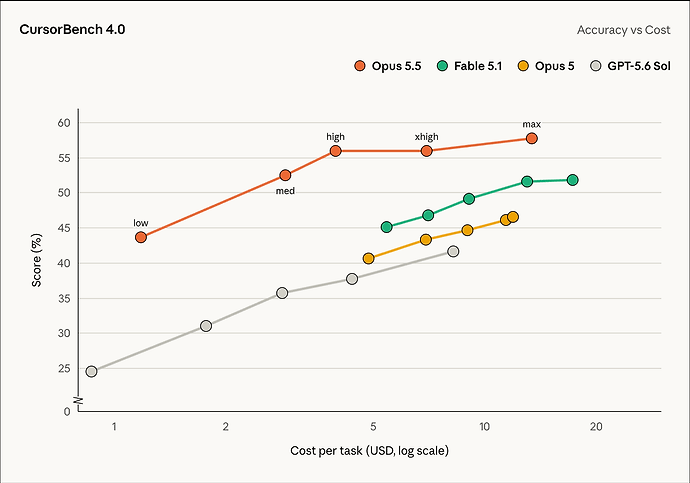
震惊瘫坐!Opus 5.5的AAII比Fable 5.1以及Astra高出了整整5分!!!巨幅提升!!!
VrianCao
2026-09-23 01:06
1
最新回复 (19)
-
 咸鱼 09-23 01:081楼
-
VrianCao 楼主 09-23 01:082楼
-
 996 09-23 01:103楼
-
 ZRainbow 09-23 01:134楼
-
 维维亚米利欧 09-23 01:135楼
-
 Coeus 09-23 01:136楼
-
 OneDingZ 09-23 01:157楼
-
VrianCao 楼主 09-23 01:158楼
-
 同学,能吃一口你的泡面吗 09-23 01:159楼
-
ZRainbow 09-23 01:1610楼
-
VrianCao 楼主 09-23 01:1711楼
-
 瑞克 09-23 01:2012楼
-
 YGYOOO 09-23 01:2013楼
-
 fjhorn 09-23 01:2114楼
-
VrianCao 楼主 09-23 01:2215楼
-
 Doori Kiss 09-23 01:2316楼
-
VrianCao 楼主 09-23 01:2417楼
-
Doori Kiss 09-23 01:2718楼
-
VrianCao 楼主 09-23 01:2819楼
* 帖子来源Linux.do
附近帖子
- ↑cursor性价比好低
- ↑:fire:【大模型百科52】关于Opus 5.5, 你想知道的一切【AA反超Astra/Fable5分,挤爆牙膏】
- ↑据目前办理页面信息,中国银行哔哩哔哩2233联名借记卡另有横版,需线下申请。
- ↑你这模型系列版本能不能对齐了😂
- ↑Opus 5.5 High 鹈鹕测试, 说真的我觉得挺牛逼的
- 📍 震惊瘫坐!Opus 5.5的AAII比Fable 5.1以及Astra高出了整整5分!!!巨幅提升!!!
- ↓我这是咋回事,谷歌账号被风控了?
- ↓大赦天下了么?tibo
- ↓:fire:【省钱系列11】关于L站跳蚤市场, 你想知道的一切【扫盲贴202609】
- ↓Claude 也有重置了,并且五小时额度又加了 20%
- ↓Opus 5.5 鹈鹕大赛