自动鹈鹕测试:一条命令让 Codex / Claude Code / OpenCode 画「鹈鹕骑自行车」动画并自动打分

Hao 2026-09-23 15:58 1
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:


  • 我的帖子已经打上 开源推广 标签:

  • 我的开源项目完整开源,无未开源部分:

  • 我的开源项目已链接认可 LINUX DO 社区:

  • 我帖子内的项目介绍,AI生成、润色内容部分已截图发出:

  • 以上选择我承诺是永久有效的,接受社区和佬友监督:


以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出


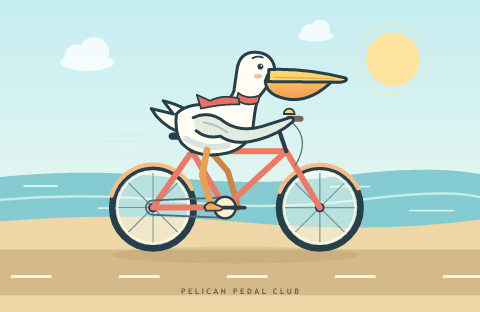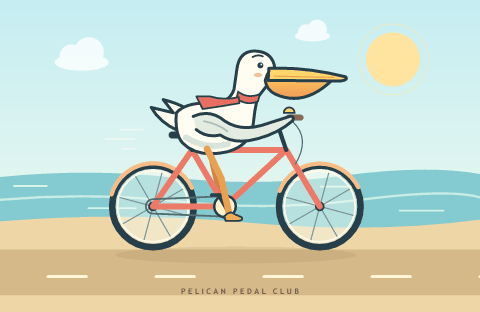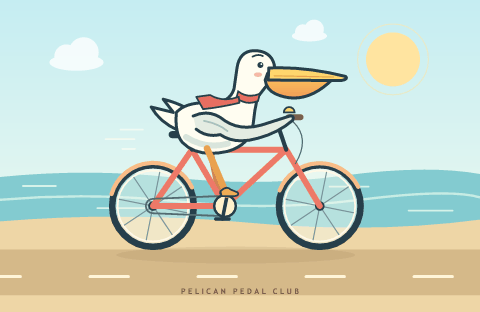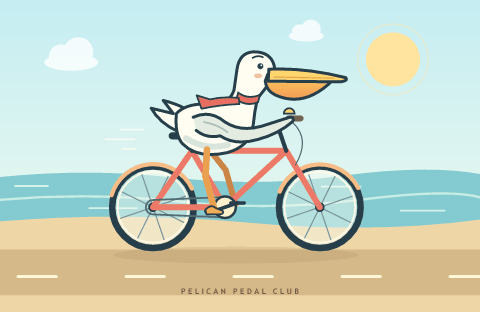
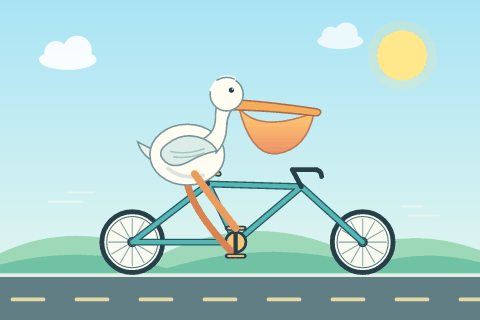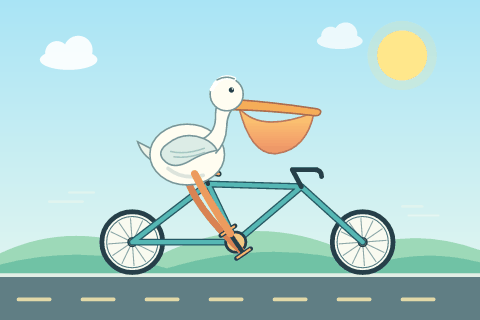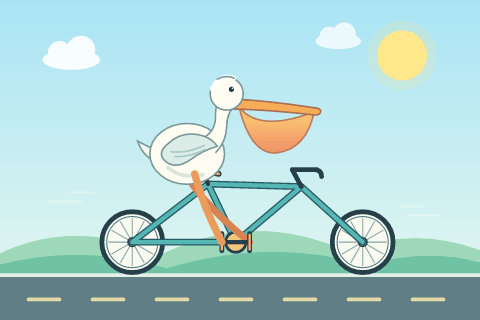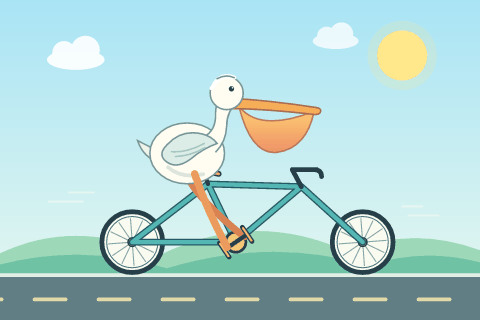
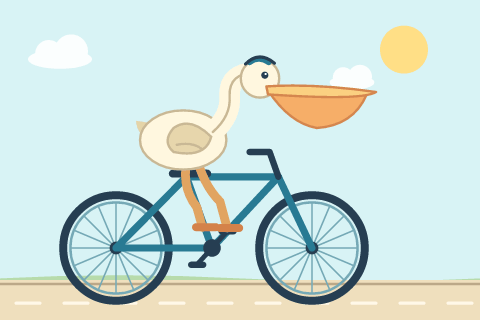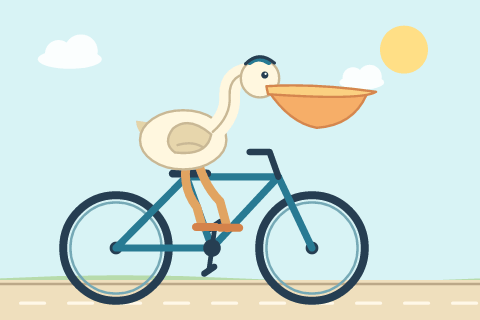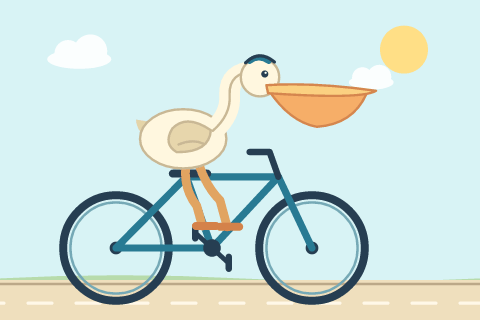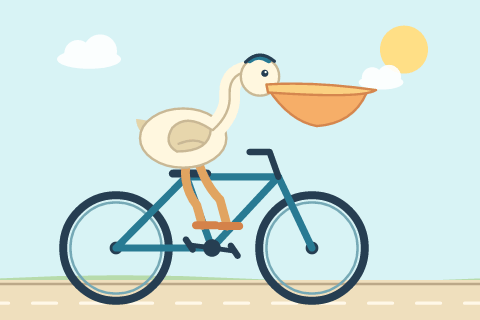
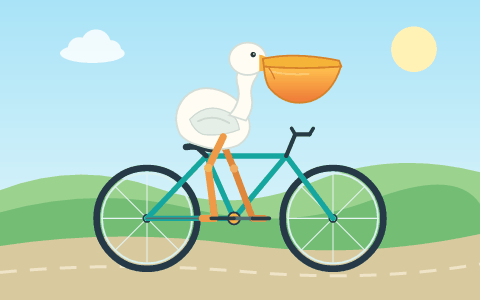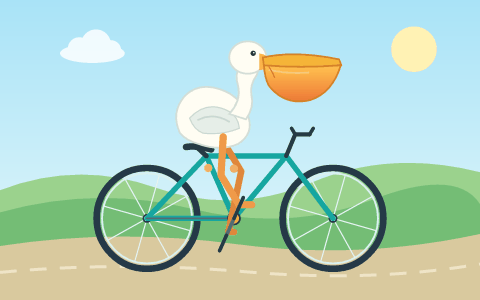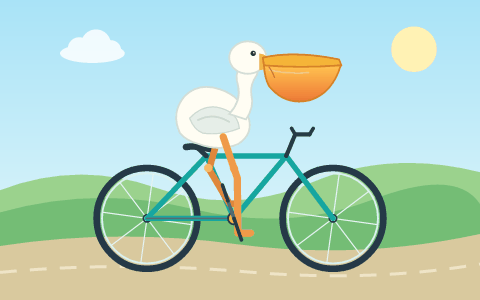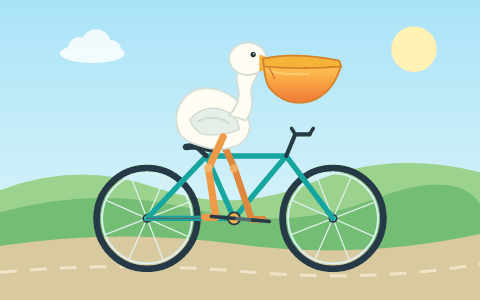
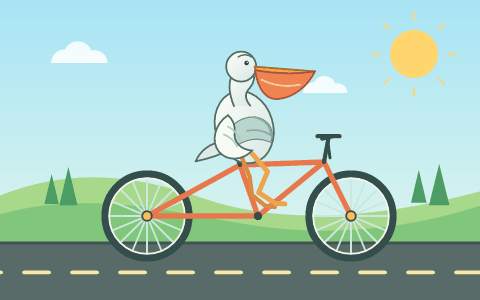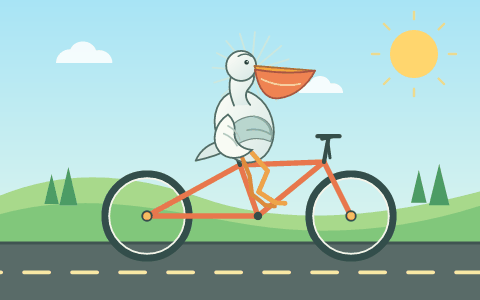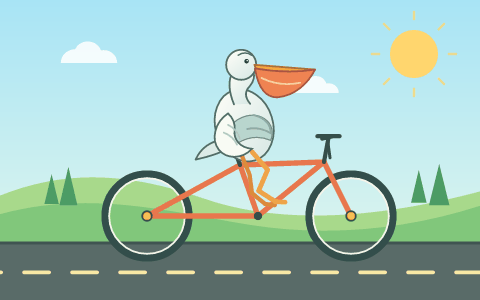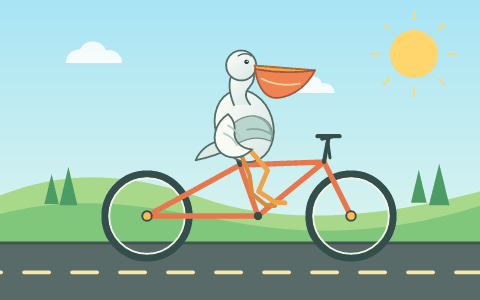
鹈鹕骑自行车测试大模型降智挺好用的。但是手动测太麻烦,也不方便进行对比,于是做了个自动化脚本:让本地 agent 画一段 2D SVG 动画,自动渲染、打分。


功能


  • 支持 Codex / Claude Code / OpenCode,可指定模型和推理强度

  • 自动渲染 SVG 动画,生成帧序列和 GIF

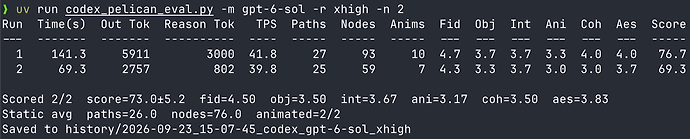
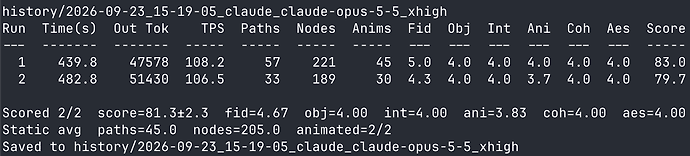
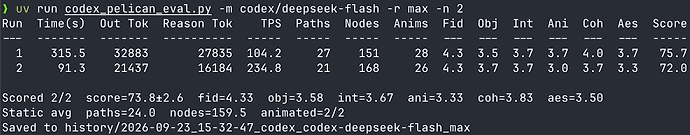
  • 多模态 LLM 盲评打分(0–100),统计 path 数、DOM 节点数、tokens、TPS


用法


git clone https://github.com/haowang02/auto-pelican && cd auto-pelican
cp .env.example .env # 配置评委 API
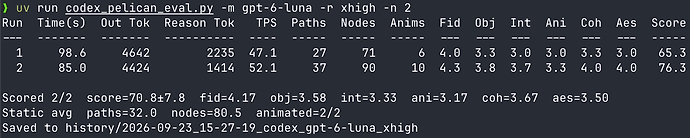
uv run claude_pelican_eval.py -m opus -r high -n 3

示例结果


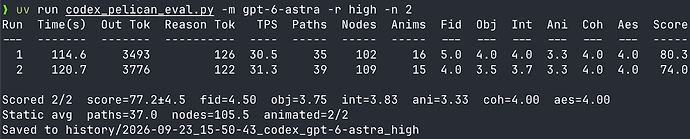
codex gpt-6-astra high


80.3 分 74.0分


codex gpt-6-sol xhigh


76.7 分 69.3分


codex gpt-6-luna xhigh


65.3 分 76.3分


claude claude-opus-5.5 xhigh


83.0 分 79.7分


codex deepseek-flash max


75.7 分 72.0分

项目地址:


欢迎跑跑自己常用的模型,晒晒结果。

最新回复 (3)
  • batu 09-23 16:00
    1

    这打分感觉不太准啊,质量差的反而分数高。

  • Hao 楼主 09-23 16:03
    2

    整体趋势上还是直观的,比如 astra 和 opus-5.5 就明显比别的模型好,分数也更高。


    deepseek-flash 视觉能力可能不太够,换成 gpt 或者 claude 打分应该会更有一致性。另外我打分求均值的次数比较少,可以把次数调高一点,让打分更稳定

  • freesit H 09-24 12:33
    3

    鹈鹕骑自行车测试大模型降智挺好用的。 ^-^

* 帖子来源Linux.do
返回