前段时间,我和一些人讨论哪类工具好用,发现大家的看法不太一样。比如,我之前回复别人时认为 Pi 的 Token 非常浪费,利用率很低,但有人反驳说 Pi 非常好用。为什么会有这种情况呢?于是我去研究了一下,翻了各家的 Harness 评测,发现了一个很神奇的问题:即便是基于 Pi 的 Oh My Pi,和 Pi 本身也有很大差别。
所以,我看了六七家评测 Harness 的网站,做了一个非常简单的总结。当然,这个总结是 Codex 帮我整理的。
Critique V2 固定 GLM-5.3-Flash
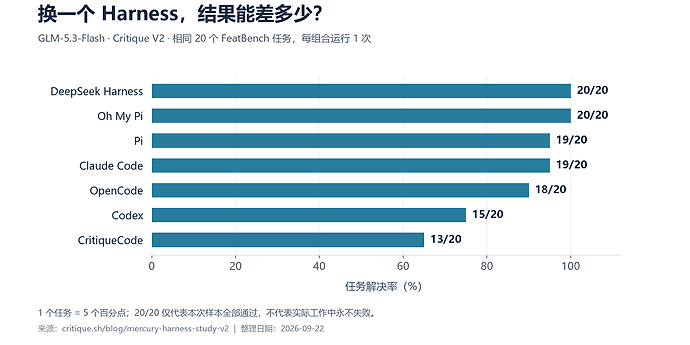
使用 GLM-5.3-Flash的话,你会发现 DeepSeek Harness 和 Oh My Pi 的效果都非常好,使用 Codex 的效果则有点令人失望。
来源:Critique — One Model, Seven Harnesses, 140 Trials
那么,这是否说明 DeepSeek Harness 就是最好的 Harness,大家都应该使用它呢?其实也不是。换了一个网站,它用的是 Kimi K3。
FrontierHarness v1.0 用的是 Kimi K3,共 30 道软件工程和终端任务,9 个 Harness、12 种配置。
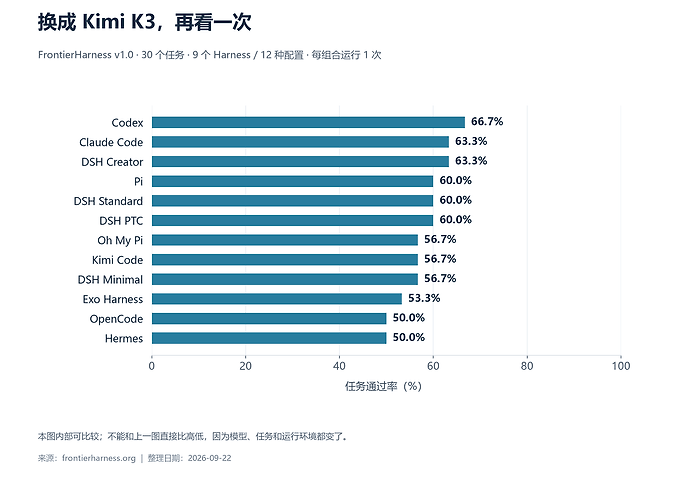
然后,这次测试的结果又反过来了:在 Kimi K3 下,Codex 和 Cloud Code 的效果最好。
是不是有点奇怪?在我的印象里,Kimi 的模型是最像 Anthropic 的,结果它在 Codex 里的使用效果最好。
来源:FrontierHarness 原始榜单
然后又到了经典的成本环节。我个人比较在意 Harness 的成本,那么谁最便宜呢? HarnessTax 的设计补上了另一个角度:7 个模型分别搭配 Claude Code、Codex CLI、Pi,在两个 benchmark 各抽取相同的 30 道题,每题重复 3 次。
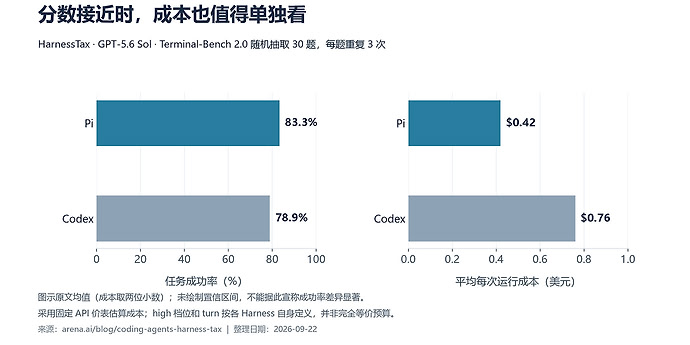
来源:Arena / HarnessTax 原文
反正原文也都给出来了嘛。这一次比较让我惊奇的是,PI 在它的测试里面任务成功率高,而且花费比 Codex 更少,这是真的把我吓到了。GPT 这种模型应该是针对 Codex 训练的,但是 PI 做到了更好的成绩。
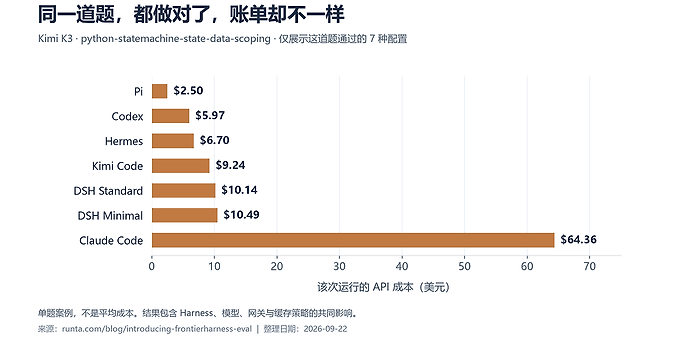
这张图用的是 K3。在这个测试中,Cloud Code 的表现比较差;这是另一家厂商的测试。同样,PI 的表现非常好,Codex 也不错。不过,K3 在 Cloud Code 上的表现又和上面提到的模型不一样。这个测试由几家不同的厂商进行,来源链接我也会放在下面。Cloud Code 这时候的成本就很吓人了。
Pi 花了 $2.50,Codex 花了 $5.97,Claude Code 这一次花了 $64.36。对应的轮数分别是 90、187、381。
来源:Runta 原文 — An example task
刚才我们一直指定某个模型。你会发现,不同模型对每个 Harness 的适配程度不一样。那么,有没有网站做过这样的实验呢?当然是有的。
Joel Niklaus 的实验更适合看这个问题
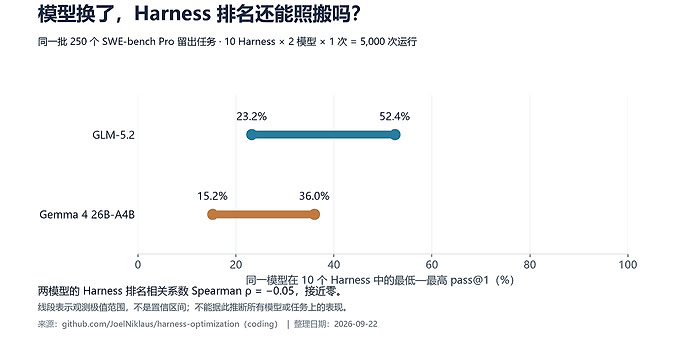
来源:Joel Niklaus — harness-optimization · Coding 实验说明
另外,还有其他的实验数据
HarnessRank 固定 GPT-5.5 / medium,跑完整的 89 道 Terminal-Bench 2.1 任务。Pi、Oh My Pi 各重复 5 轮,OpenCode、Codex 各 3 轮。
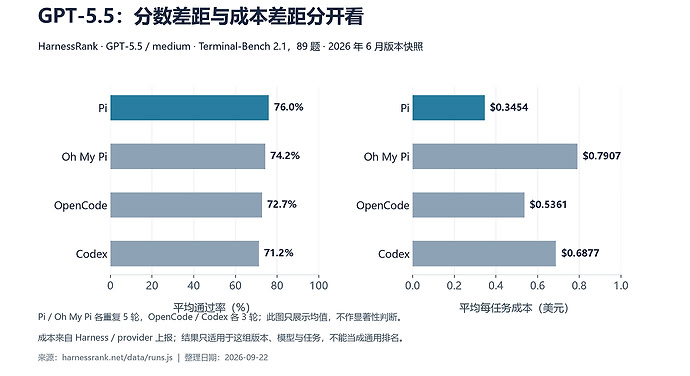
来源:HarnessRank 与方法说明 · 原始汇总数据 runs.js
做个数据总结:
把上面的来源和另外两组放在一起,按用途挑着看就行。
评测 / 原始来源 |
主要测什么 |
阅读时要留意 |
|---|
HarnessTax |
7 模型 × 3 Harness;两个任务集,每题重复 3 次 |
重复运行有助于观察波动,但每个任务集仅抽取 30 题 |
Critique V2 |
GLM-5.3-Flash;7 Harness × 20 个功能开发任务 |
单次运行,样本小;有配置偏差和验证恢复记录 |
FrontierHarness |
Kimi K3;9 Harness / 12 配置 × 30 题 |
具体版本快照;网关、缓存适配也会影响结果 |
Joel Niklaus |
两模型 × 10 Harness × 250 题 |
适合看模型适配差异;每格仍只有一次运行 |
HarnessRank |
GPT-5.5 / medium;89 题,4 Harness 各重复 3~5 轮 |
6 月版本快照;成本为上报值,重复次数不完全一致 |
AIMultiple A-Code Bench |
17 个工具、10 个全栈开发任务 |
CLI 组用 Sonnet 4.6,编辑器组用 Opus 4.6,不能把全部工具当成同模型横评 |
Kimchi |
GLM-5.2、完整 89 个 Terminal-Bench 2.1 任务 |
厂商自测;OpenCode 数据来自不同时期,原文明确只作方向性参考 |
所以说我是 Oh My Pi、 Codex、 Cloud Code、 Open Code 的这些用户。然后呢由于 Pi 和 Oh My Pi 看似是同一个这个 harness 工具。但实际上呢,Oh My Pi经是完全独立的一个工具了。
我看了非常详细的报告,很多测试中,Oh My Pi 的 Token 消耗是 Pi 的两倍以上,但效果可能只提升了一点,有时甚至还不如最原始的 Pi。这也给了我一些提醒。
我经常使用 Open Code 的 Oh My Open Code,现在好像改名叫 Oh My Open Agent 了。我以前认为,自己是不计 Token 损耗的用户:Subagent 的种类越多、分类越详细,效果就会越好,无非是多消耗一点 Token。但看了这些 Harness 评测后,我发现,消耗更多 Token 不一定效果更好。有可能最节省 Token 的 Pi,效果反而比消耗两三倍 Token 的 Oh My Pi 更好。
各家的harness似乎都还行,你看不出来哪家是最好的,但是你能看出来哪家是最拉的。
如果让我推荐的话,那可能会去尝试一下pi,然后正好站内呢也有一位大佬做了一个工具叫pidesktop 这个我也用了,感觉非常的不错,可以推荐一下。

 夜语者 09-24 16:291楼
 Evan399 09-24 17:233楼
 BEIDEX 09-24 17:514楼