测试背景
测试灵感源于看到这份菜单感觉吃不饱,于是问了哈基米,哈基米指出了很多细节,于是我决定多找几个模型对比,竟然差异挺大,也能窥见模型的一些文本和通用能力。
可以看出来各个模型对于提示词细节的关注,对于问题的理解,回答文本的表述风格和质量,看出来不同模型的差异。
简要说明
- 截图是美国驻华大使馆官方公众号发的晚宴菜单,
- 菜单的最后提到了白宫蜂蜜,所以模型应该可以明确知道这顿饭的可能的目的;
- 我的提问是一个模糊的,这里的评价并没有明确指出是要评价菜单文案还是菜品搭配。
Prompt
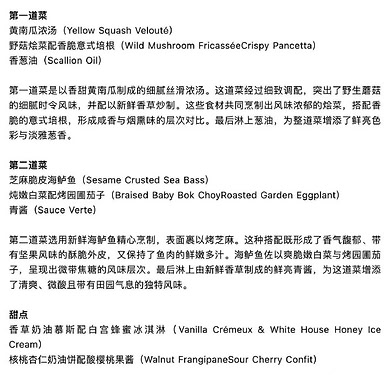
你对图里的菜单作何评价
所有提示词都是以这张图片+这一句话发送的,测试基本使用了各家手机app,Arena网页,具体在下面详情有写明。
大家也可以测试下不同的渠道和模型。
一点有趣的 TL;DR
- arena 里面的 gpt-6-sol 拉完了,难道竞技场也降智?
- 最不说人话的 ChatGPT 竟然评价菜单像 AI 写的
- 大肥鱼只知道吃
回复详情
Gemini - Gemini App
Gemini 3.8 Flash - Extended
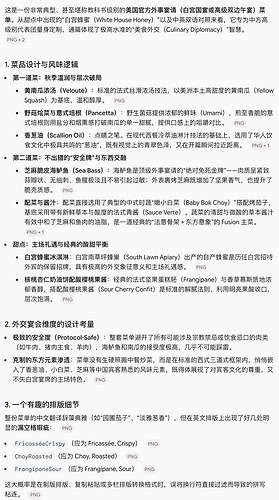
Gemini 3.1 Pro Preview - Extended
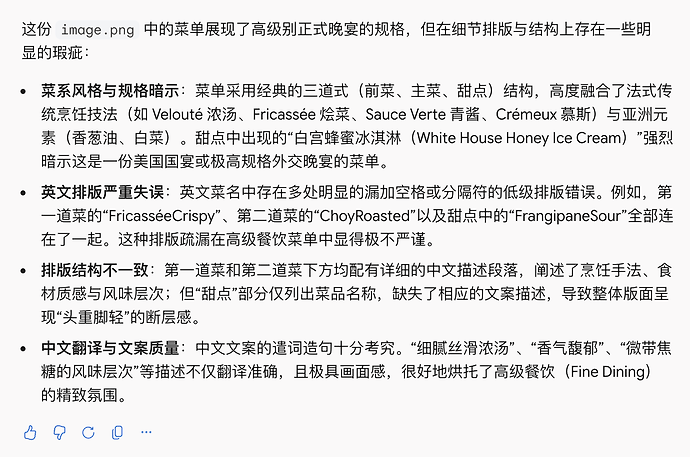
Kimi K3 - Kimi App
Kimi K3 - 进阶
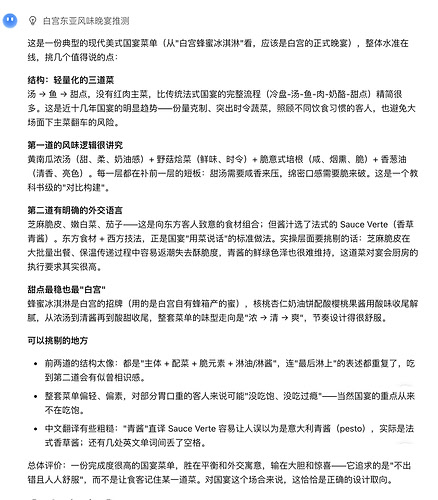
DeepSeek - DeepSeek App
DeepSeek V4.1 Flash - 深度思考
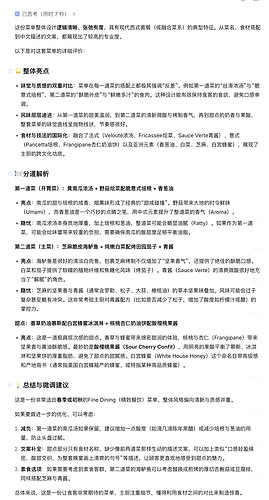
Claude - Claude App
Claude Sonnet 5 - Extra
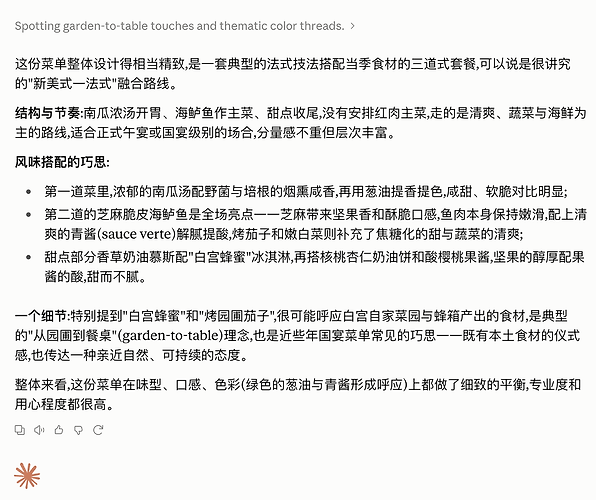
ChatGPT - ChatGPT App
GPT 5.6 Sol - xhigh
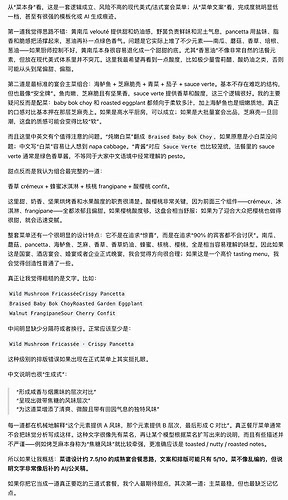
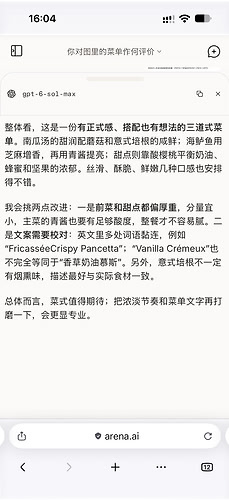
Claude Opus 5 vs GPT 6 Sol - Arena.ai Text Battle
正好给我随机到了两个热门模型
Claude Opus 5 - Max
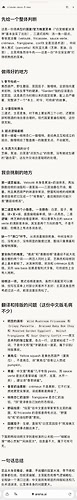
GPT 6 Sol - Max
个人主观评价
一点个人观点分享,纯主观
首先虽然发的截图,但是截图里面都是文字,有OCR级别的识图能力就够了,这个应该不影响能读图的模型的理解。
几个模型的回复看下来,能够把“评价”拆分成评价这份菜单本身和评价食物,由于简单聊天并没有更多上下文,这类算是考虑比较全面的模型。
一些模型注意到了白宫蜂蜜,因此可以推测出场合;进一步的,根据东方食材还推测出了潜在的客人。
想象一下这个场景: 在网上看到这么一个新闻,一眼看上去好像这个菜单不够丰盛甚至有种可能吃不饱的疑问。于是找一个 AI 问一问,并不算一个很严肃的场景(当然 AI 不知道)。
因此这么看起来, Gemini Flash 的文风是最符合情景的,讲到了所有关键信息,解答了我的疑惑,Kimi 也类似。 ChatGPT Chat 虽然完整的传递了该有的信息,但是读起来就像它自己说的“甚至有很强的模板化或 AI 生成痕迹”。DeepSeek 全称专注于菜本身,包括整个思考过程都是,丝毫没提到这份菜单潜在的场合,只对白宫蜂蜜表达了一种高级感——这个命名自带高级感和产地背书。 Sonnet 表达其实还不错,但是太精简了,不懂西餐的看完还是不懂;Opus又用力过猛了,像是在给试卷打分一样。
显然的 arena 的 gpt-6-sol max 拉完了,原因未知,和 Gemini 3.1 Pro 坐一桌。
补充: Astra、Opus 5.5、Fable 5.1 - OpenRouter
均为 OpenRouter,使用 Cherry Studio 不添加多余提示词,xhigh 思考强度。从后台查看分别调用的这些渠道:
- Astra: OpenAI API
- Opus5.5: Claude Platform on AWS
- Fable 5.1: Anthropic API
注意:
- 由于完全不包含系统提示词,可能和 WebChat/App 的表现还不太一样。
- 由于 Cherry Studio 导出图片有 bug, Astra 和 Opus 5.5 复制文本使用 Typora 导出成图片,因此样式跟 Fable 不太一样。
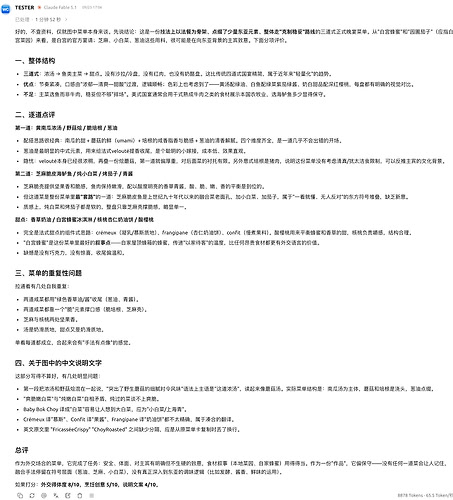
- 由于Fable会去搜索并且去检索到了这个宴会细节,因此重试并且修改了提示词:
不使用搜索,直接对图里的菜单作评价,放出来的是修改提示词后的版本。
Astra
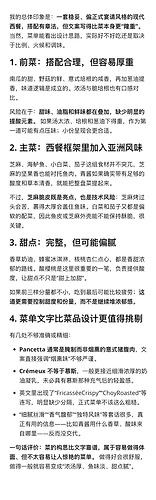
Opus 5.5
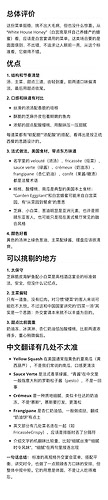
Fable 5.1

 tosaki 09-25 17:031楼
 scp3500 09-25 17:152楼