用AI做桌宠动画应该走哪种技术路线?

往事随风k 2026-09-27 21:09 1
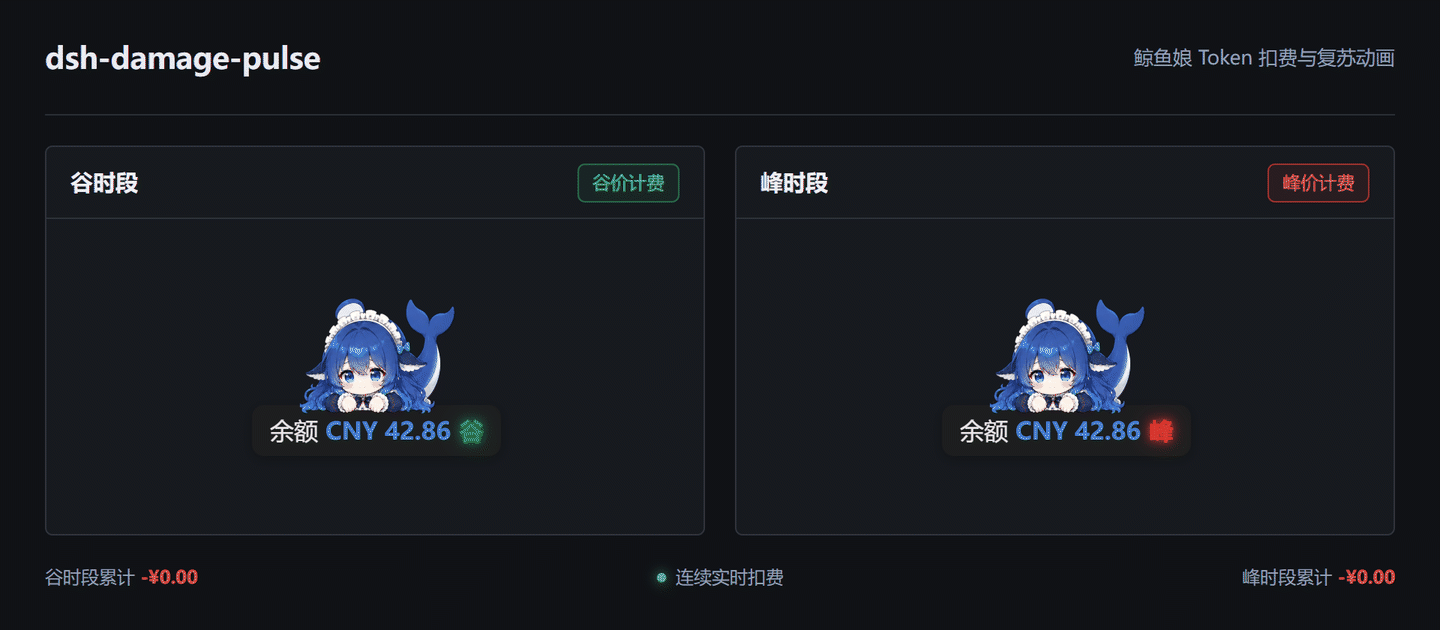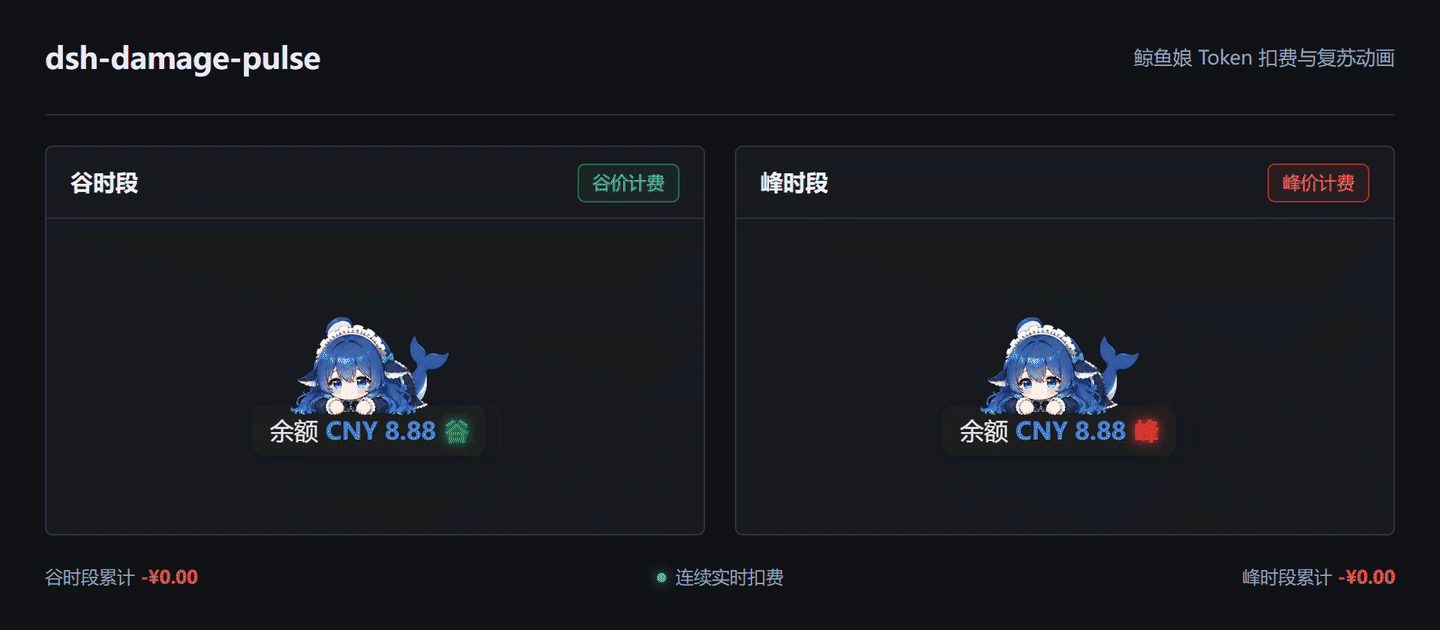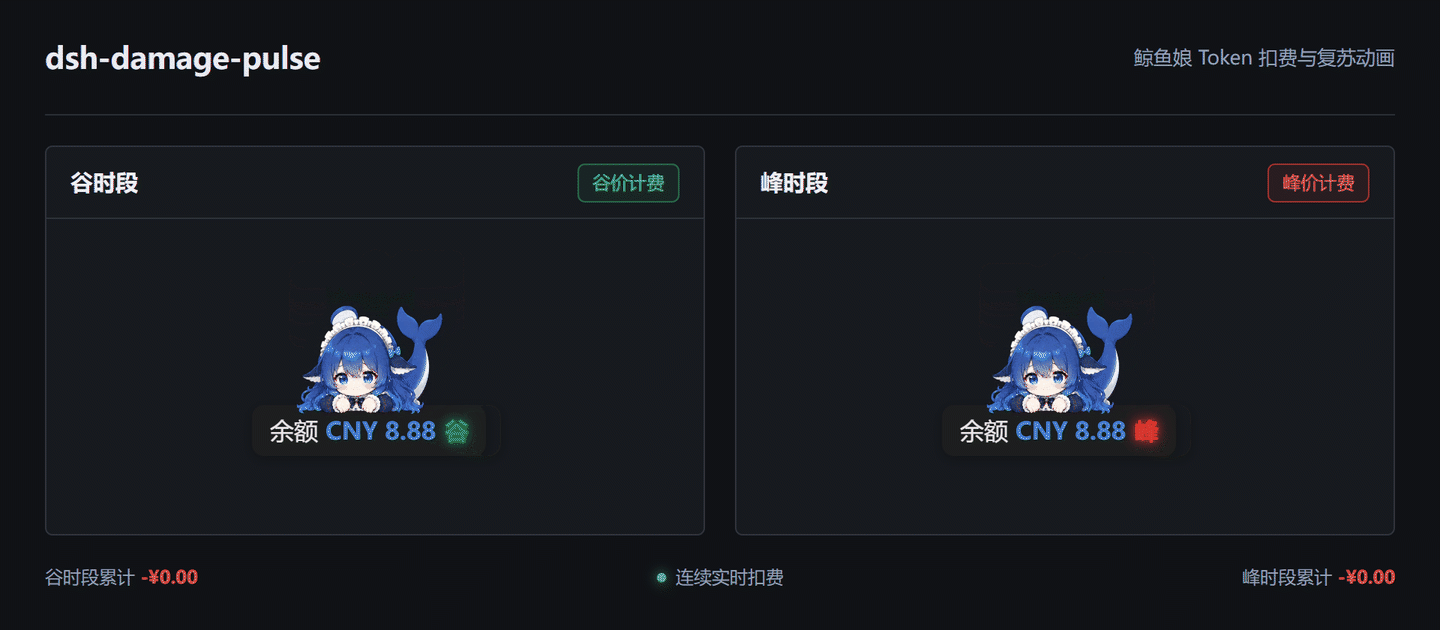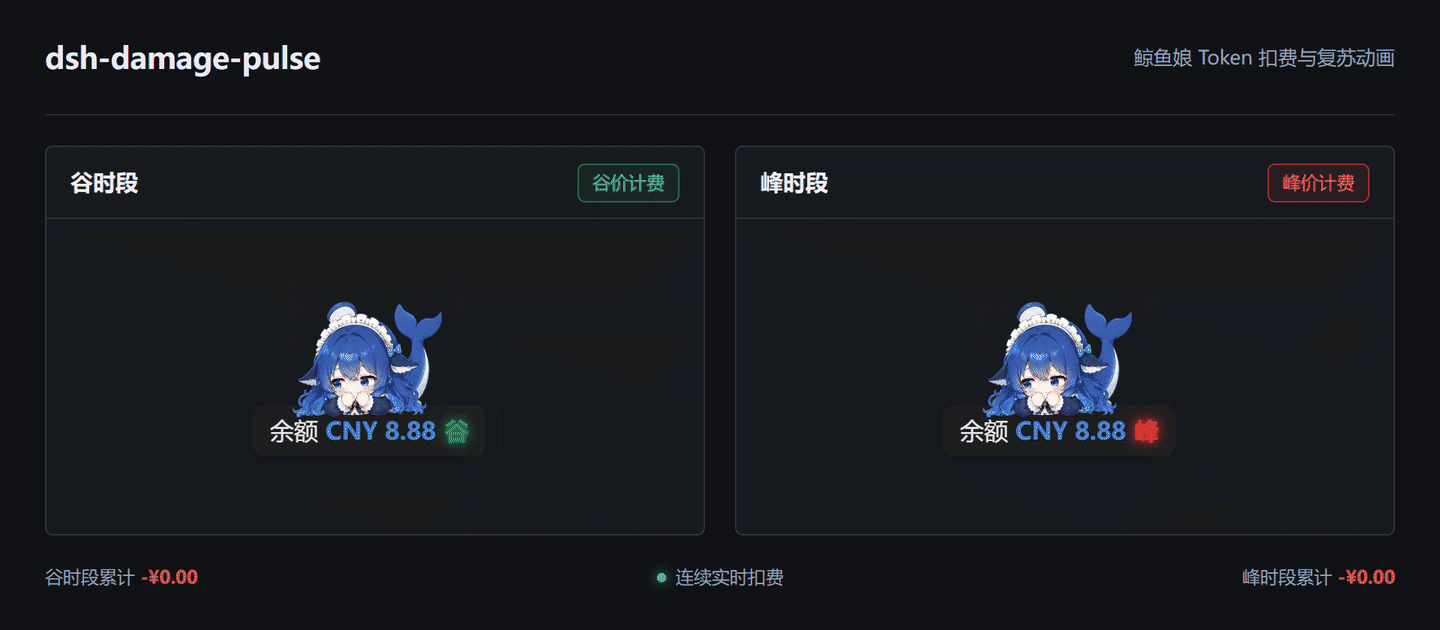
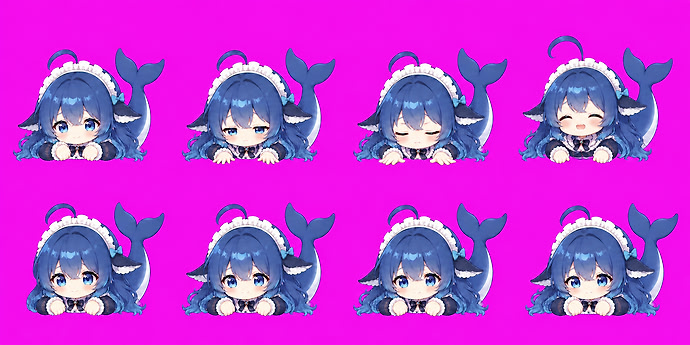
我之前做桌宠动画主要靠AI。先确定好肥鱼的动画动作细节,然后让GPT去写提示词,写好自己把提示词和素材扔给image2.5生成关键帧,最后再交给GPT把所有帧缝起来。用DeepSeek的话说就是:单 Canvas + 离屏整帧原子提交 + 程序化变换,单层 PNG 序列优点是难度低,但是动画的帧数不高,有时候感觉很卡。我自己又没有做动画的能力几乎全得靠生图模型和GPT、DeepSeek。做出来的效果大概如图:


我想看看有没有更好的桌宠动画制作方案,之前让GPT6用PixiJS做过分体动画,但果冻效应太明显,弄了好几天都没解决。

最新回复 (14)
  • 吕相赫 09-27 21:10
    1楼

    同 等一个“最佳实践”

  • lan 09-27 21:14
    2楼

    动画不太好,要不用视频模型生成,要找动画设计师手绘。

  • 往事随风k 楼主 09-27 21:18
    3楼

    动画帧的生成倒是没什么问题,主要是拼接缝合之后没有我预想到流畅。

  • lan 09-27 21:20
    4楼

    就是因为生成的不好,所以你感觉不到流畅 感觉在抖动抽搐一样。 ^-^

    不想找人画动画,那就视频模型生成 然后自己抽帧。

  • Xer56 09-27 21:22
    5楼

    godot + gpt 一把梭。

  • 往事随风k 楼主 09-27 21:22
    6楼

    我倒是没看到抽搐,可能关键帧太少了,一个动作估计也就画了10帧左右。不过可以考虑一下视频生成然后抽帧

  • lan 09-27 21:24
    7楼

    可以试下,以前做动画 我是需要把部件全部切出来(少的地方还需要自己在手动画补齐来。),然后用godot拼凑好,对接上骨架再做动态。

  • Xer56 09-27 21:24
    8楼

    大佬牛皮 。

  • 往事随风k 楼主 09-27 21:27
    9楼

    那确实很复杂了,我有空试试

  • 竹江夕月 09-27 21:31
    10楼

    关键帧的方法感觉不可靠,一致性很难保证,感觉应该走视频生成的路线,这样动作的连贯性才能保持的比较好

  • 往事随风k 楼主 09-27 21:35
    11楼

    之前用image2的时候没发现动作有一致性问题,上面那个GIF就是用image2画的。我一版会先设计好三视图给image2做参考,然后让GPT写提示词的时候严格限制生图模型的动作修改。生成的时候一次生成好几版,让GPT选择偏移最小的一版来用。

  • 竹江夕月 09-27 21:40
    12楼

    我之前做的时候帧数少的时候,image2还可以保持一致性还好但是动作一卡一卡的不流畅,然后像提升帧率就多绘几个动作就会出现中间几个帧人物忽大忽小以及一些形象偏移的问题,后面实在是做烦了,发现视频生成然后抽帧做出来的一致性和流畅性都不错

  • 派大星 09-27 21:41
    13楼

    即梦做视频。然后再抠背景,抽帧。

  • Bingrong LYU 09-27 21:44
    14楼

    制作skill已经全开源 rullerzhou-afk/pet-forge (mit随便用,两条管线以及踩坑记录都丢进去了)然后我自己这边的话,等忙好这一阵也会增加一批新的主题


    可以看一下这位大佬的项目 → @Ruller

    github链接:


    另外再推荐一下桌宠项目~

* 帖子来源Linux.do
返回