字幕提取这个领域,Gemini 还是太超模了

Mozi 2026-09-29 01:56 1
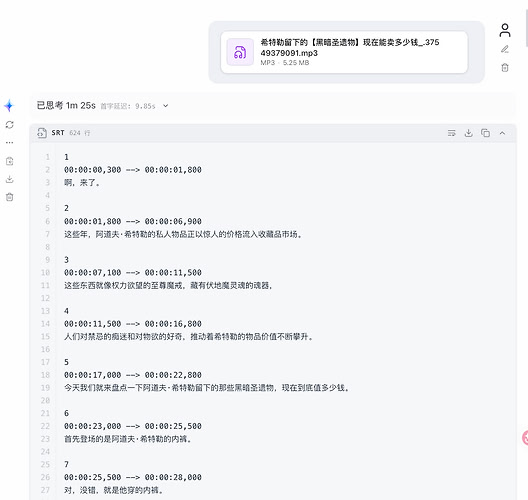
好久没有测试 Gemini 提取字幕的能力了,对 3.8 Flash 这个模型也进行测试

视频时长11分半,不对视频进行切片,一次性导入上下文,多模态分析

一次 API 调用完成字幕提取


测试一:音频转字幕

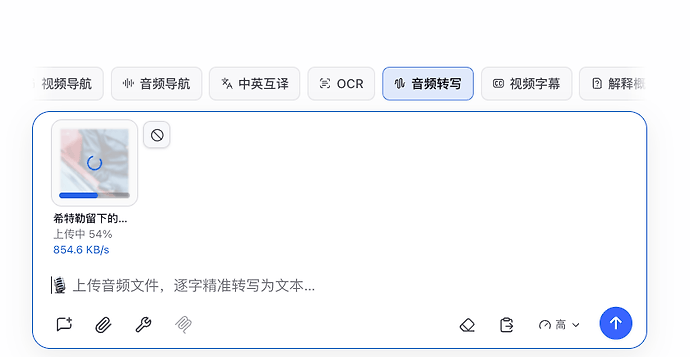
拖入音频文件,获取字幕


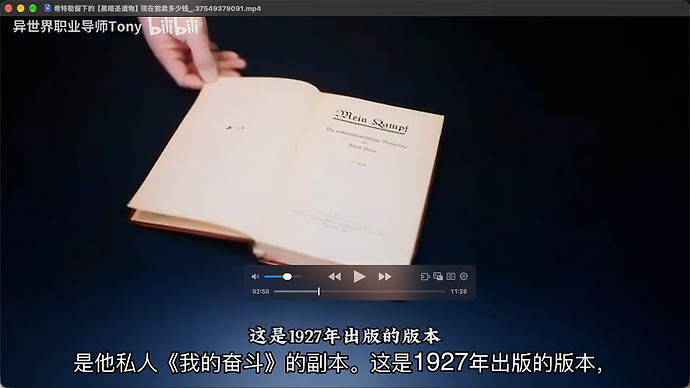
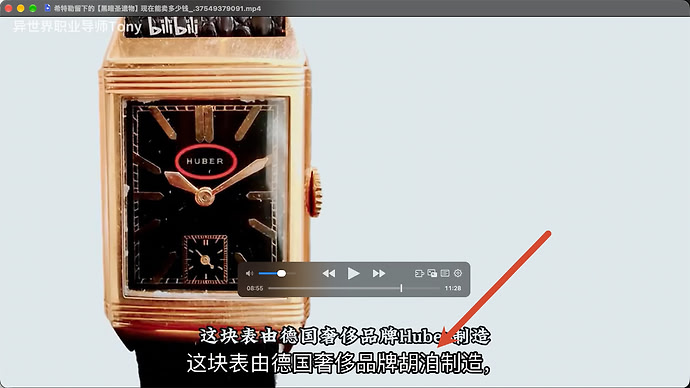
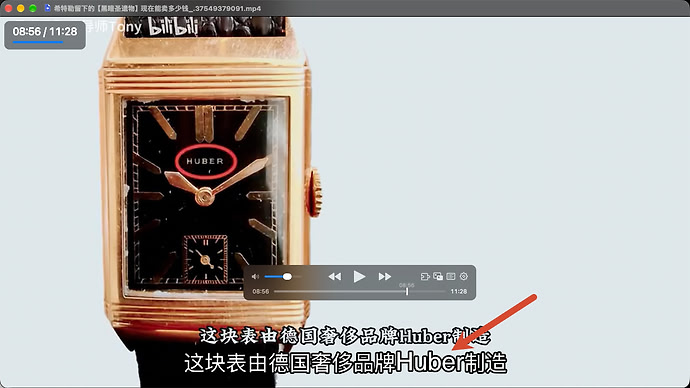
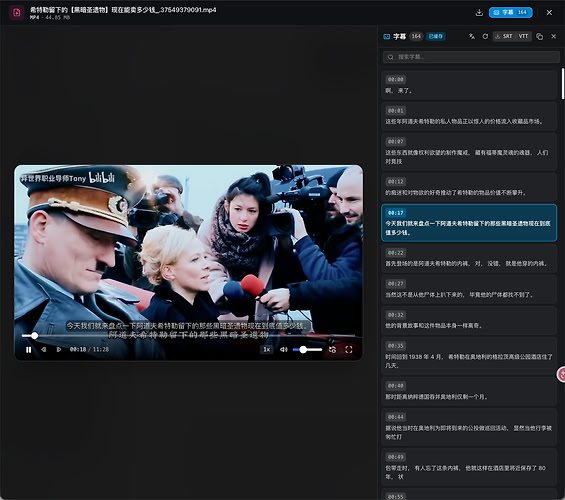
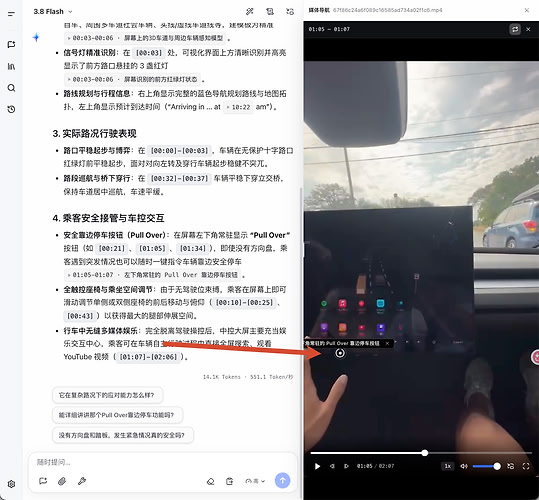
镜头这个位置是AI识别出的字幕

完成该操作时使用了17K的输入和8K的输出

只调用一次API

所有时间戳均准确无误


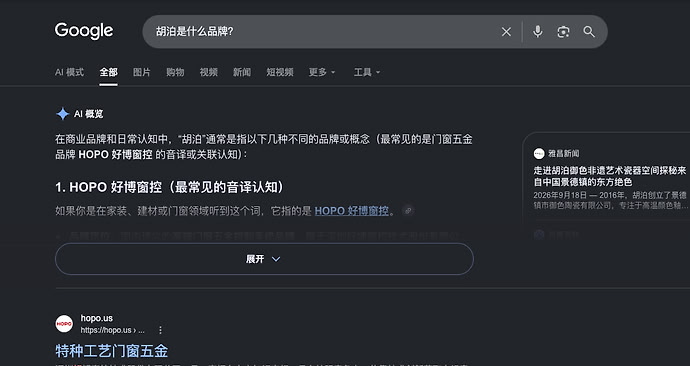
唯一缺点是该专有品牌采用了中文名称,这个中文名在互联网上均无法查询到


测试二:视频转字幕


直接把视频文件拖入聊天框,可以通过视觉能力理解视频中的内容,这对字幕的提取更有帮助


时间戳依然准确,时间戳比视频内嵌的字幕更准

这就更加牛逼了,可以通过画面内容来进行修正


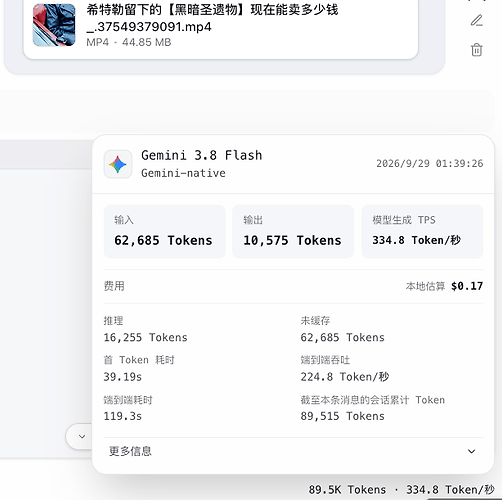
携带视频的情况下,Token 就需要多很多, 62K 输入,10K 输出


如果我是视频创作者,需要为视频添加字幕,那么 Gemini 就是我的唯一选择

靠多模态能力,AI 甚至可以一次性给出字幕,根据画面内容,针对性显示在画面的对应位置

最新回复 (18)
  • 美帝码工 09-29 01:59
    1楼

    其实 gemini 不是有一个专门的 Transcribe 模型吗?便宜一点。

  • Mozi 楼主 09-29 01:59
    2楼

    但是精准度要差很多

    我也有适配


    这就是用3.5 Transcribe识别的

    时间戳和文字长度这些做的不太好

  • FizzBuzz 09-29 02:01
    3楼

    佬友,agy能用吗?agy上面没有专门的音频转写功能可选,在哪用呢

  • Lisang233 09-29 02:03
    4楼

    agy的3.8flash也能用,效果也不错,我是CPA反代的,好像上传的文件大小有限制,我是用分片的方式做的。

  • Mozi 楼主 09-29 02:07
    5楼

    用 AI Studio 的免费 API 就能使用,或者你直接在 AI Studio 里面聊天也可以

    我的 Web UI 里面自带了这个提示词


    https://linux.do/t/topic/2871240/6?u=yeahhe

  • 黯绛 09-29 02:09
    6楼

    如果有硬字幕可以直接提取的,没必要给gemini吧 ^-^

  • Mozi 楼主 09-29 02:10
    7楼

    只是一个例子而已

    我的使用场景,都是从没有字幕到提取字幕

    大部分人都是从没有硬字幕的情况提取的

    我换一个没有硬字幕的视频文件,一样的效果

  • fablia 09-29 02:11
    8楼

    Gemini多模态强的一批,没有对手的

  • Mozi 楼主 09-29 02:13
    9楼

    硬字幕的提取过程也很容易出错

    作者自身的读音和画面也可能会出错

    而模型是都可以从画面和音频修正的

    还可以通过 GEMINI 自己的世界知识来修复

  • 黯绛 09-29 02:14
    10楼

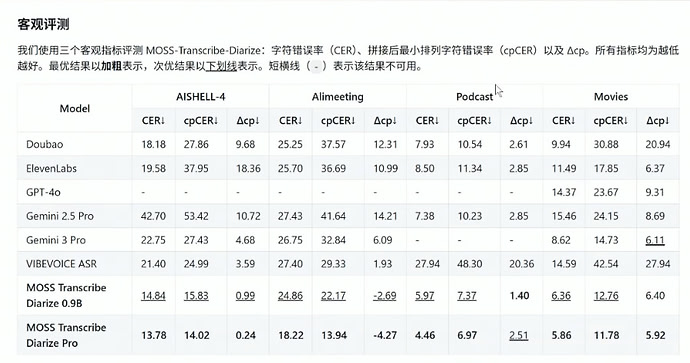
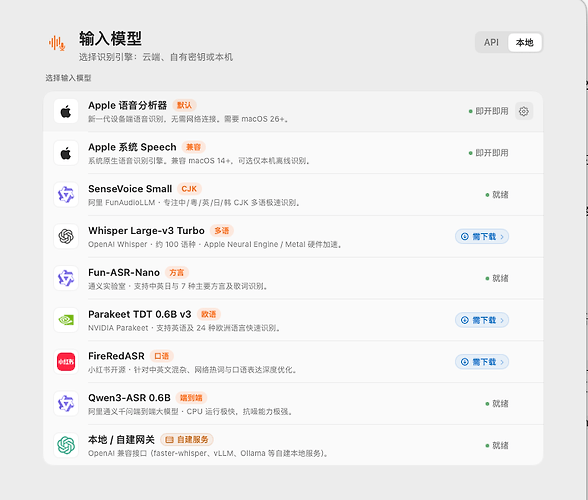
    Qwen3-asr 的准确度和实时率也足够高,我本地用这个和moss-0.9b-asr 本地跑同传。

    https://linux.do/t/topic/2425506

  • Mozi 楼主 09-29 02:18
    11楼

    不考虑实时率和本地离线的话,Gemini 是最好的选择

    甚至可以在视频画面中标出对应的内容显示字幕

  • 黯绛 09-29 02:19
    12楼


    我觉得和gemini打也不差了

  • Mozi 楼主 09-29 02:20
    13楼

    传统语音识别模型,我要实现高准确度的话,那我还是会选择千问云端的 Audio 3 ASR Flash

    Gemini和这些传统模型根本不在一个层级,Gemini 是直接对整个上下文理解,加上画面理解

    纯音频转字幕的话,传统语音识别部分情况会比Gemini优秀,但是视频转字幕,这就是降维打击了,那些模型只能输入语音,不能输入视频

  • 黯绛 09-29 02:25
    14楼

    确实是,用起来很舒服,不过本地这些小模型我认为基本上能力都足够了还有剩下的。

    特别是英文一个0.6B的模型就能通杀了。中文的特性在这要上个几B的也足够本地跑了。

    视频转字幕要带图像理解Gemini是最好,但是时间和价格上如果没有免费pro的话我就觉得不划算了。


    本地再让一个带视觉的模型去做更正可能效果也不错,毕竟gemma-12B带视觉层视觉理解足够这种场景,就是太麻烦了。

  • RobinDai 09-29 02:29
    15楼

    请问这个是什么工具?


    我最近也在找类似的,一个是录下来的视频音频生成带演讲者划分的字幕,一个是实时的语音转文字字幕+翻译。用apple本地ai的项目不少,用gemini的倒是感觉很少

  • Mozi 楼主 09-29 02:29
    16楼

    使用 Gemini 做字幕提取,只要两个条件:翻墙和谷歌账号,你甚至不用会员

    用AI Studio就行了


    你那个方案我也看一下,因为我现在也在折腾本地的音频转字幕

  • 黯绛 09-29 02:31
    17楼

    GitHub搜livetranslate

    事实上这个还没有做说话人区分,每家的ASR都不太一样处理挺麻烦。

  • 黯绛 09-29 02:34
    18楼

    小红书的VAD效果最好,0.6Bv3英语能力可以达到准即刻出词的程度,moss-0.9b-asr中文最佳还有说话人划分也挺准。如果只是本地音频转选小红书的demo用就行。


    原来不需要pro吗 ^-^

* 帖子来源Linux.do
返回