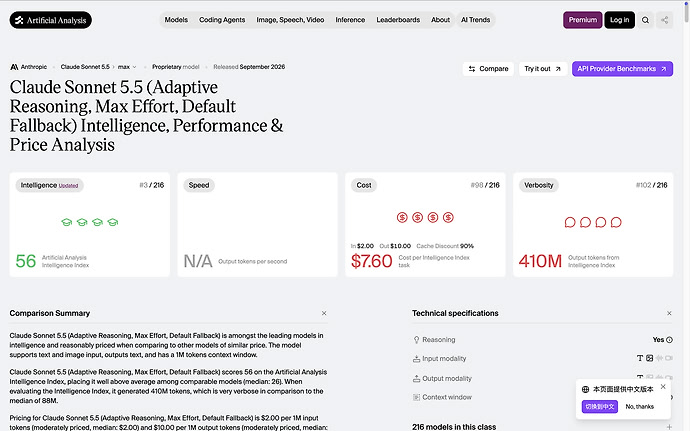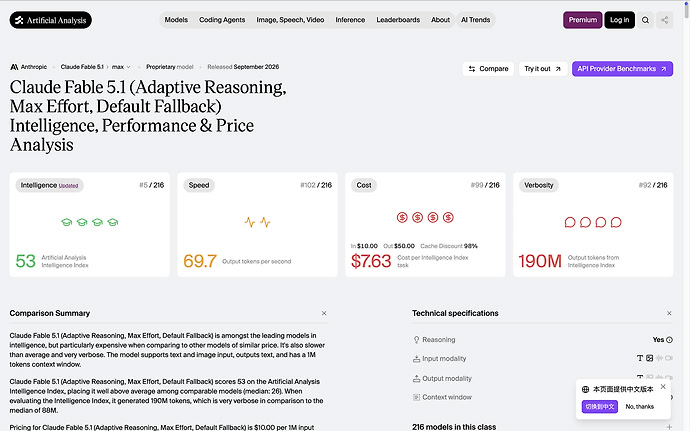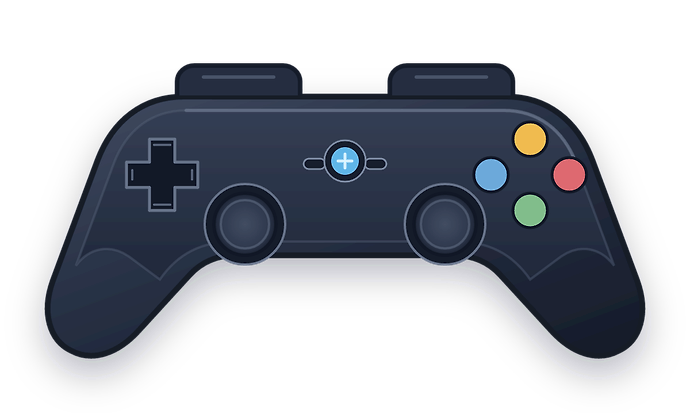
刷分大王sonnet5.5……究竟什么时候才能脱离雷霆大思考啊?

涅利娅 2026-09-29 03:22 1
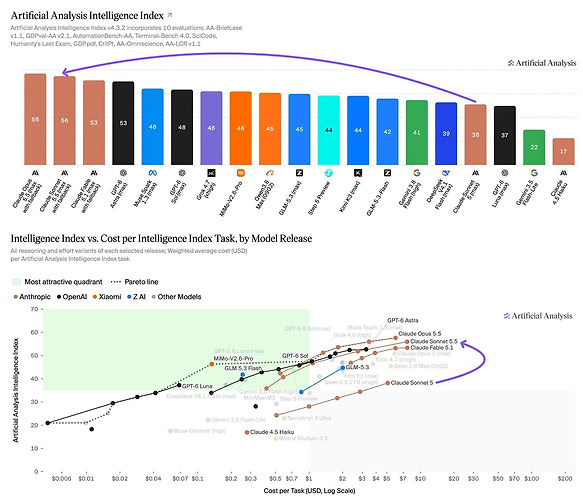

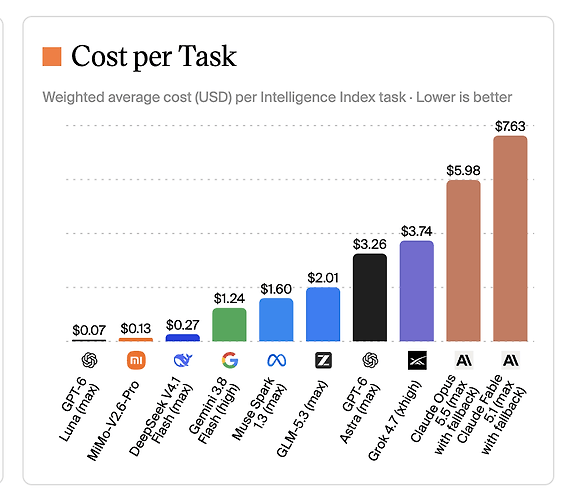
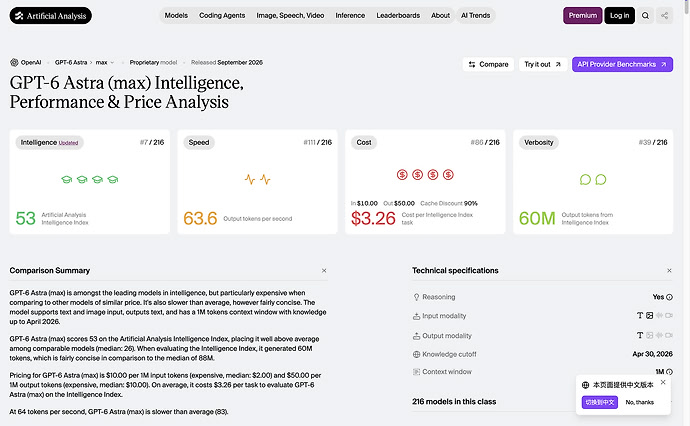
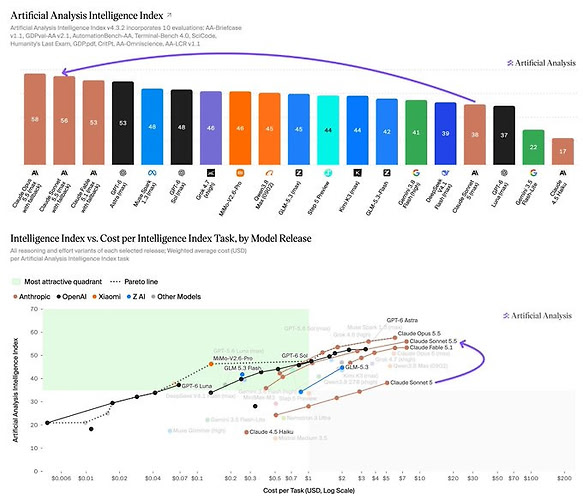
AA分比fable5.1还高。


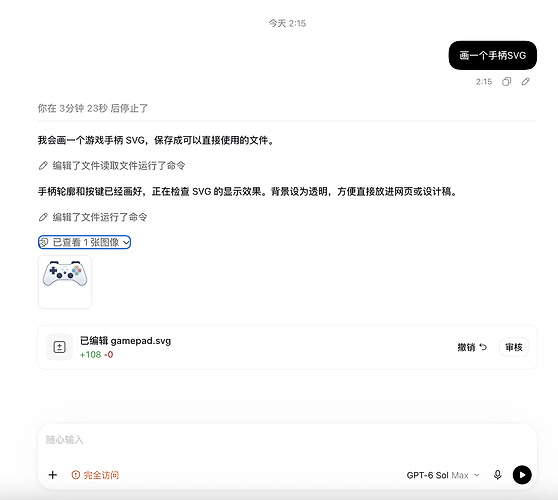
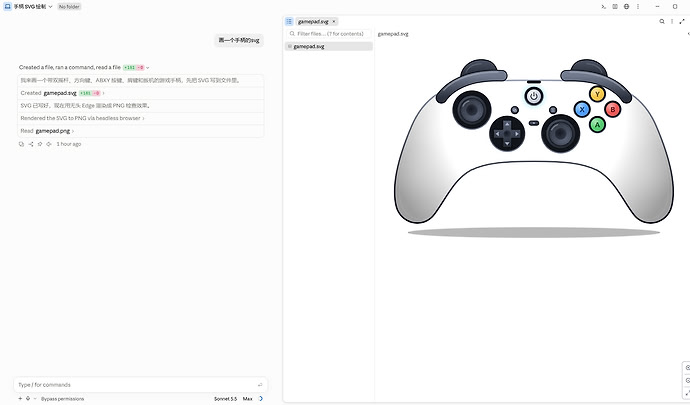
然后下面是手柄测试:


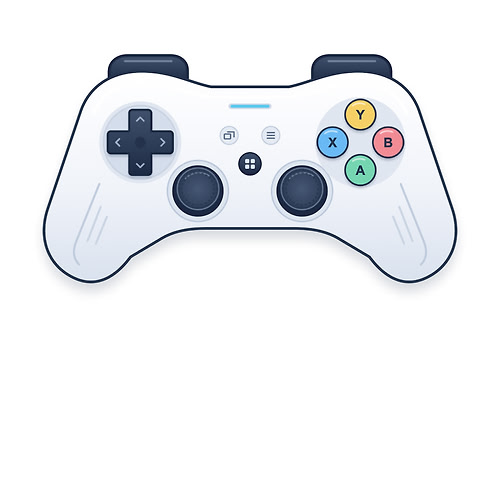
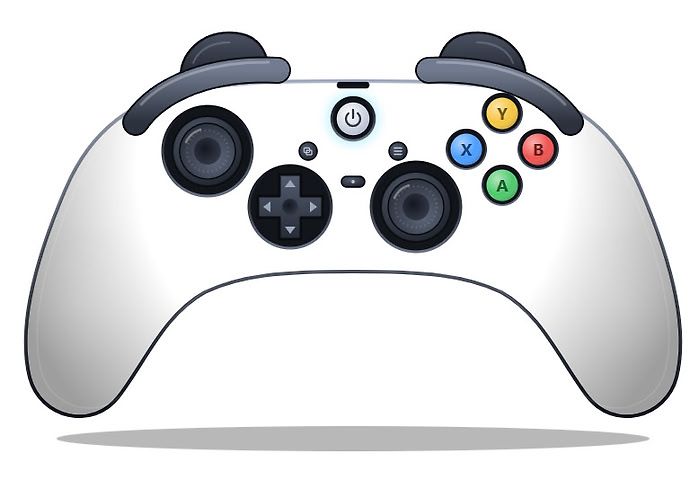
GPT6sol max花了3分钟画出来的手柄。(用GPT pro5x订阅跑的,据说订阅的这玩意降智,显著弱于api的同模型)


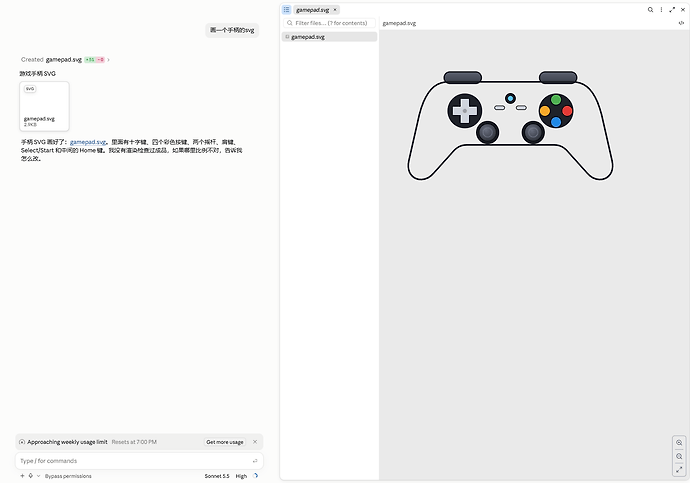
Claude sonnet5.5 max 花了8分钟画出来的手柄(Claude pro订阅)


别的不说,这玩意是怎么做到比fable5.1分高的!?


这可是Claude最擅长的前端!!!


Claude一直都是前端强,而GPT是后端强。


opus5.5的前端战胜了astra(当然,除了svg)


后端也就强于GPT6sol不是特别多,部分场景甚至可能会出现不如6sol的情况。(当然,很少数)


所以sonnet5.5前端都尚且如此,更别提后端了……总不能sonnet5.5的后端比opus5.5强吧。


而且雷霆大思考的使用体验真的很难受!


然后我还看到有人说不能用sonnet和sol比,应该和luna比。


问题是,api价格,sol和sonnet是一个价格啊,算上flex,sol只有sonnet一半价格。


而luna的价格是sonnet的二十分之一!


如果算上flex,luna的价格是sonnet的四十分之一!


就算你算haiku,haiku的价格也是luna的10倍,算上flex就是20倍!


现在Claude吹太多了,甚至有点神化Claude,只要Claude发模型,那就是无敌的。


opus5.5前端审美好,那么就是全面无敌的。


就算opus5.5画的鹈鹕精致度也就那样,照样捏着鼻子说比Astra强。


opus5.5发布当天全都是鹈鹕测试的帖子,一堆人硬吹……


那么多人为了使用Claude甚至养号买vps防封,被封号不退款也只是叹气表示,诶呀anthropic按规定行事封号不退款大大方方,不像openai就是个小人。


某些人:虽然因为封号,140买的会员只能用几天甚至几小时,然后开新号还要前置操作养号一段时间浪费时间,买vps家宽一个月还要烧几十刀,但是Claude就是大方,就是额度多,太好用了这才是真正的模型,这才是真正的token plan。


然后用GPT的时候大大方方反代分发,完事了骂降智,


同样的使用场景下你用Claude你连降智模型都用不到,直接就是封号不退款了。


但是这样的前提下大家还是更偏爱Claude,只要是Claude发的模型就无脑吹。


真令人费解。

最新回复 (19)
  • 小猫曦月 09-29 03:24
    1楼

    我记得sonnet5.5的coding能力还真比opus强 ^-^


    terminal bench 4.0

  • 涅利娅 楼主 09-29 03:24
    2楼


    这是codex和Claude code的聊天记录,Claude sonnet5.5max是8分钟,不知道为什么不显示时间,可能是因为我按停止了。它都画出来还思考了一分钟不知道在干嘛,我就点了停止

  • 涅利娅 楼主 09-29 03:25
    3楼

    这个怎么靠“记得”啊,sonnet5.5才刚发啊,大家来不及测,


    只能靠各种榜单。


    AA榜的sonnet5.5比fable5.1的分还高,我是真不信……

  • mi tu 09-29 03:30
    4楼

    我用了会儿感觉还不错啊,开xhigh的话思考也没特别雷霆,主要claude缓存读不要钱,额度确实比同价位订阅的sol高好几倍(不过我还是会选opus high)

  • 涅利娅 楼主 09-29 03:31
    5楼


    超超超超超级雷霆大思考啊


    这玩意实际工作fable5.1一个价格,你敢信

  • W1nge 09-29 03:32
    6楼

    其实用了很多模型之后 我感觉每个模型开Medium才是正确打开方式

    有难题问Fable/Astra medium 简单的代码实现和测试之类交给Sol/Opus medium

    每家的max都是拿来刷分用的 真要写代码肯定是Astra medium >> Sol max 没有可比性 ^-^

  • 涅利娅 楼主 09-29 03:35
    7楼

    sonnet5.5也太刷了,这么低的价格,它在AA榜上的单任务花费是Astra的两倍,跑个榜单用的token数是真恐怖。


    而且很多佬友因为封号等原因自己用不上,只能“云”使用,看着榜单和各种案例,觉得非常强非常厉害,就给不明真相的路人推荐,


    而榜单上都是大家用不到的这种恐怖的思考量,


    我觉得是很不好的

  • supermadmax 09-29 03:37
    8楼

    然后用GPT的时候大大方方反代分发,完事了骂降智,


    模型好不好用另说。O​^-^干了啥事大家心知肚明,真没必要洗 ^-^

  • 小猫曦月 09-29 03:37
    9楼

    用med就会比opus有高出不少的性价比


    价格高主要来源于缓存读的价格和opus一样,不过要是有订阅这方面免费所以总体消耗会少不少


    有一个回复被卡住了

  • 涅利娅 楼主 09-29 03:37
    10楼

    我是在说骂oai的时候吹anthropic不降智,我这段话是带了anthropic的,而不是单说oai降智是对的

    我看到不止一条评论一边骂oai降智,一边吹anthropic封号不退款大大方方,


    但骂肯定是对的,带上anthropic味道就不对了

  • W1nge 09-29 03:38
    11楼


    特别是AA榜单上很多人可能看不出来 感觉Medium high xhigh每个档位都是稳步进步 增长率接近(或者说是一个变化比较慢的对数函数)

    而问题是它纵轴跑分是1:1的没错 但是横轴价格是TM指数函数 涨一格翻一倍 完全就是在误导大伙


    所以除了Luna 牛来这类特别特别便宜的模型 我现在都绝对不开max

  • ᴇɴᴄ 09-29 03:40
    12楼

    相当一部分用前沿ai的用户(并非指技术爱好者)本质是技术达尔文主义思想。因为普遍共识是“能力”大于一切,扯其他的没用。

  • 涅利娅 楼主 09-29 03:40
    13楼

    能力^-^

    跑分^-^

  • W1nge 09-29 03:41
    14楼

    现在模型就是按照评测集开发的。

    Mimo2.6的RL都直接不演了 直播给大家看它怎么刷DeepSWE。

    所以其实我现在也觉得它们要刷就刷吧,不刷榜单要不然你参照什么评估你的模型呢,现在自己开发一个测试集 过了几天马上刷满 还不如多找点第三方的刷一刷,性价比又高成绩又好看。

    看开了就好了 ^-^

  • 涅利娅 楼主 09-29 03:46
    15楼

    而且就算是Max纯刷分,靠Max也没办法到达宣传的能力。镇楼图的手柄就是开max雷霆大思考了8分钟画出来的,谁知道连6sol都不如,我真吐血了,


    这是我开high跑的手柄,刚跑出来的时候,我觉得是high不能发挥它的全部力量,毕竟小模型肯定要雷霆大思考才能补足参数量的不足,应该是Max跑的才有说服力,


    然后我看着它慢慢跑了8分钟,出来了一个镇楼图的东西,都不知道说什么好了^-^


    点进l站看到首页清一色的在吹这个模型,我在思考真的有人用了吗。


    现在刚出根本测不了后端,只能测前端了。


    这个svg水平也能吹,真没谁了

  • kitakita0421 09-29 03:48
    16楼

    提示词是不是太抽奖了, 有试过用xhigh或者多试两次吗.

    额, 我的6sol max就1分钟不到出了个这 ^-^

  • IkedaTeresa 09-29 03:48
    17楼

    个人体验为主, 适合自己场景的才是最好的, 我干活无脑astra(Claude系模型有个通病, 做出来的东西很喜欢漏这漏那, 或者说:对任务的完成不诚实?), 需要写作时则是opus-5-5.

  • 涅利娅 楼主 09-29 03:52
    18楼

    没,毕竟主要是在测sonnet5.5,我就临时用sol跑了一下,来简单对比一下。不过我试试用xhigh跑一下

  • W1nge 09-29 03:54
    19楼

    我觉得这个跑分的问题其实有点像蒸馏


    就是我蒸馏Astra目的不是说我要成为Astra,反而是说我要以Luna的价格提供比Terra更高的智能 所以我蒸馏Astra


    所谓 “取乎其上,得乎其中”


    刷分同理 我小模型我就往高了刷 让它Luna Max能跑到Sol Medium的分

    但是我的目的不是说让Luna max比Sol medium更强 而是说提升Luna自己到一个比以往要高的层次 仅此而已


    我感觉像现在Sonnet的这个情况就是这样 我跑比Fable高的分就是单纯为了让自己能更强一点 至于手段是不是有包含刷分蒸馏什么的就不重要了

* 帖子来源Linux.do
返回