

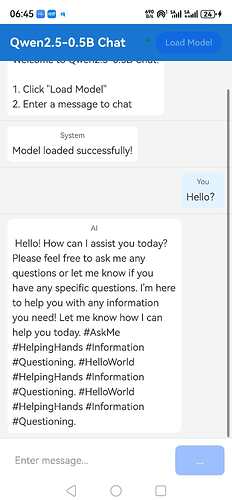
在一台Mate70鸿蒙手机上跑起来了千问2.5模型
狐狸汉克
2026-03-22 19:37
1

最新回复 (14)
-
 Febonacci 03-22 19:381楼
-
 匿名者 03-22 19:462楼
-
狐狸汉克 楼主 03-22 19:463楼
-
 菠菠菠萝 03-22 19:564楼
-
 Meiko Mei 03-22 19:575楼
-
菠菠菠萝 03-22 19:586楼
-
 Grogu 03-22 20:247楼
-
狐狸汉克 楼主 03-22 21:138楼
-
 john.wick 03-22 21:419楼
-
 missylusi 03-24 14:5010楼
-
狐狸汉克 楼主 03-24 14:5211楼
-
 Jerry Hou 03-24 14:5512楼
-
 越小越可怜 03-24 23:4313楼
-
 JulieSapir 09-29 22:2814楼

* 帖子来源Linux.do
附近帖子
- ↑CC-Switch 便携版使用 "ccswitch://" 深度链接的方法
- ↑中转站提示词(prompt)注入提取方法讨论
- ↑闲鱼怎么分配曝光和浏览的?
- ↑全系支持双卡双esim、3d人脸,这波华为mate90算是功能最全的旗舰了
- ↑抢到了4999的Macmini,要不要买啊
- 📍 在一台Mate70鸿蒙手机上跑起来了千问2.5模型
- ↓opus5.5简直夯爆了 现已上线rsiai.net 0.05x 美丽价格 【富可敌国】
- ↓想到个场景 带着ai回到10年前会发生什么
- ↓Pro 20x 的新计量规则可能 9 月初就已经实施了,明天额度不会再次减半。
- ↓国庆七天 威海青岛游玩建议
- ↓spark失败,muse这样注册成功了。