前段日子,我公开了我们的27b推理服务给大家免费用(实际现在也开着): 自部署qwen 3.8 27b,欢迎大家来玩(免费)【上线了新的调度策略并已恢复服务】 - 福利羊毛 / 福利羊毛, Lv2 - LINUX DO
在里面我承诺了要给大家介绍我是怎么优化的,今天终于有时间在国庆加班摸鱼之际鞭策AI搓出来啦。由于推理Infra是个不简单的活,很难一次性从头讲到尾。因此我计划分开多个帖子分别介绍优化的各个部分。今天这个帖子是这个系列的第一个: 前置知识
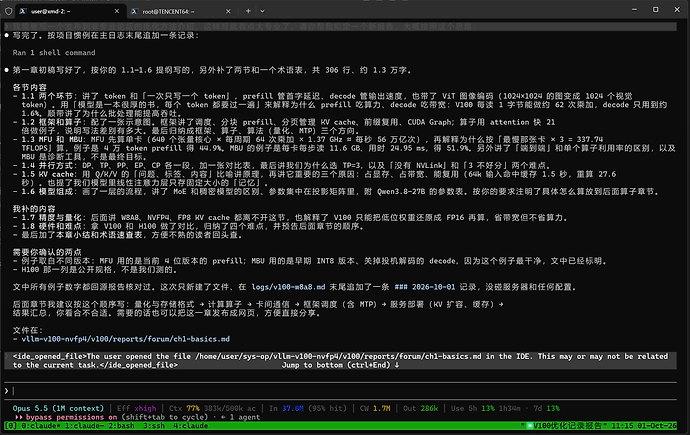
本文是AI生成+人工润色出来的,相关聊天记录已放到文章最末尾~
碎碎话就说到这,让我们开始吧^-^
写在前面
这个系列记录我们怎样把 Qwen3.8-27B 部署在三张 2017 年发布的 NVIDIA V100 显卡上,目前优化成果为:最多 3 个请求同时处理,260k上下文,40k冷输入下大概15s后开始吐token,回答速度每秒 110 多个 token(单用户,双用户总共220 token/s,三用户约240 token/s)。
V100 已经是好几代以前的显卡,主流推理软件对它的支持越来越少,很多优化只能自己从头做。如果你对LLM推理优化不太了解,我们得首先在第一章了解一些基础概念。
第一章 前置知识
1.1 大模型推理的两个环节
首先,我们得了解一个概念:token:模型不是一个字一个字地处理文字,而是先把文字切成 token。一个 token 大致相当于一个英文单词,或者一两个汉字。模型的输入是一串 token,输出也是一个一个的 token。
大模型生成回答的方式叫自回归:每次只预测下一个 token,把它接到末尾,再预测下一个,直到写完。所以一个请求在模型内部分成两个阶段:
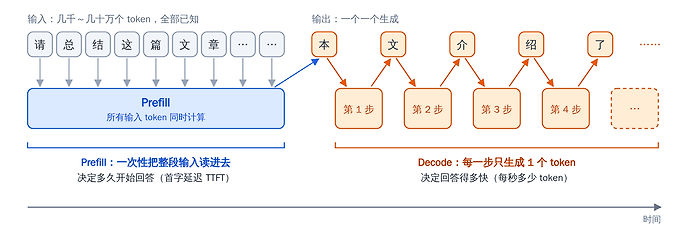
- Prefill(预填充):把整段输入一次性送进模型。输入里的 token 全部已知,可以同时计算。这一步结束时得到回答的第一个 token,同时把每个输入 token 的一部分中间结果存下来供后面使用(KV cache,见 1.5)。用户感受到的是首字延迟(TTFT,Time To First Token)。
- Decode(解码):之后每一步只生成 1 个新 token。新 token 要依赖前一个 token,没法提前算,只能一步一步来。用户感受到的是输出速度(每秒多少个 token)。
多模态模型在 prefill 之前还有一步图像编码(ViT encode):图片先被切成许多小方块(patch),由一个视觉编码器转换成若干视觉 token,再和文字 token 拼在一起做 prefill。以我们的模型为例,一张 1024×1024 的图被切成 4096 个 16×16 像素的小块,最后变成 1024 个视觉 token。图像编码的计算特点和 prefill 类似,下面不单独讨论。
两个阶段卡在不同的地方
我们来认识 GPU 的两项关键能力:
- 算力:每秒能做多少次计算。大模型里几乎所有计算都是先乘再累加,一次乘法加一次加法叫一次乘加(FMA)。例如:一张 V100 每秒最多大约能做 56 万亿次乘加。
- 显存带宽:每秒能从显存里读出多少数据。例如:V100 是每秒 900 GB。
GPU 干活时,要算的数据得先从显存读进计算单元。一项任务跑多快,取决于这两项能力里哪一项先跟不上:数据早就备好、计算单元忙不过来,就是受算力限制;计算单元算得飞快,却总在等数据送过来,就是受带宽限制。先跟不上的那一项,就叫这项任务的瓶颈。
Prefill 和 decode 恰好各卡在一边:prefill 的瓶颈是算力,decode 的瓶颈是显存带宽。换句话说,想让首字出得快,要把算力用足;想让回答写得快,要把带宽用足。这是后面所有优化的出发点。
为什么会这样
模型的参数(也叫权重)存在显存里,按每个参数 1 字节存,大约 27 GB。每个 token 经过模型时,都要和全部参数各做一次乘加。于是:
- 计算量随 token 数增长:每个 token 都要做约 240 亿次乘加(我们的模型约有 243.5 亿个参数在做矩阵乘)。
- 读权重的量与 token 数无关:过一遍模型,不管同时算多少个 token,全部权重都只需要从显存读一遍。
Prefill 时几万个 token 一起过模型,权重读一次就给几万个 token 用,读权重的时间分摊下来几乎可以忽略,GPU 一直在计算,瓶颈是算力。
Decode 时一步只有 1 个 token,却同样要把全部权重读一遍,读完只做了很少的计算。GPU 大部分时间在等数据从显存送过来,瓶颈是带宽。
我们可以来算一笔账:V100 每秒能做 56 万亿次乘加,却只能读 9000 亿字节,相当于每读 1 个字节,能做约 62 次乘加。而 decode 时如果参数是 1 字节一个,每读 1 个字节只需要做 1 次乘加,算力最多只能用上 1/62,约 1.6%。
这也解释了批处理(batching)为什么有用:decode 时把多个用户的请求凑在一起算,权重读一遍就能同时给好几个请求用,总吞吐几乎成倍增加,每个人的速度基本不受影响。不考虑 KV cache 的话,要凑到约 60 个 token 一起算,算力才会重新成为瓶颈;而实际服务里同时在 decode 的往往只有几个请求,所以 decode 基本一直卡在带宽上。
|
Prefill |
Decode |
|---|
一次处理多少 token |
整段输入,几千到几十万 |
每个请求 1 个(用投机解码时是几个) |
主要瓶颈 |
算力 |
显存带宽 |
用户感受 |
首字延迟 |
输出速度 |
我们目前的成绩 |
40,960 token 输入,15.4 秒出首字 |
单个用户约 115 token/s(用了投机解码) |
1.2 推理框架是怎么工作的
要让一个大模型跑起来,主要靠两部分软件配合:推理框架和推理算子。
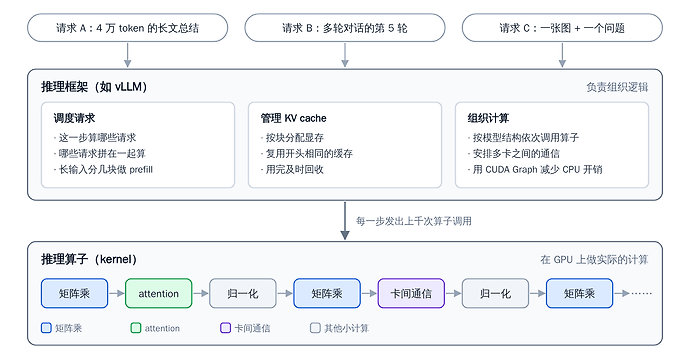
推理框架负责组织逻辑,常见的有 vLLM、SGLang、TensorRT-LLM、llama.cpp 等,我们用的是 vLLM。框架主要做这几件事:
- 调度请求:决定每一步算哪些请求:一个请求答完了,马上补进新的请求(continuous batching);输入特别长时,把 prefill 切成几块分几步做(chunked prefill),这样不会把正在 decode 的其他用户卡住。
- 管理 KV cache:把显存切成小块分给各个请求(PagedAttention);新请求如果和以前的输入开头相同,就直接复用以前算好的部分(prefix caching)。
- 组装模型:按模型结构依次调用算子;用多张卡时,还要安排卡与卡之间什么时候交换数据。
- 降低 CPU 开销:一步 decode 要调用上千次算子,每次调用 CPU 都有开销。框架可以把这一整串调用录制成一个 CUDA Graph,之后每一步只需要整段重放一次。
推理算子(kernel)则是真正在 GPU 上运行的小程序,每个算子负责一种计算,例如矩阵乘(GEMM)、attention、归一化、激活函数、量化与还原、卡间通信等,通常用 CUDA、Triton、cuteDSL 等工具编写。同样一个计算,算子写得好坏差别非常大。例如:在我们的项目里,prefill 阶段的 attention 算子从通用实现换成针对 V100 手写的版本后,从 38.4 毫秒降到了 1.77 毫秒,快了 21 倍;一个线性注意力算子从每层 31.2 毫秒降到了 0.92 毫秒。
麻烦的是,新版框架和算子基本不再照顾 V100:上游 vLLM 的量化矩阵乘、8 位 KV cache 在 V100 上都跑不起来;一部分用 Triton 写的算子在 V100 上用不上张量核心(GPU 里专门做矩阵乘的硬件单元),只能退回普通的乘加单元,慢好几倍。所以这个项目的大部分工作,其实是在为 V100 重写算子、改造框架。
总结一下,想让模型跑得快,我们可以从三个方面下功夫:
- 框架:调度好请求,管好 KV cache,减少 CPU 开销和卡之间的互相等待,让算子一个接一个紧凑地跑。
- 算子:让每个底层计算都尽量把硬件用满。
- 算法:直接减少要算、要读的东西。比如量化,用更少的位数存参数,要读的数据就少了(见 1.7);又比如投机解码(MTP),先用一个小模块快速猜出后面几个 token,再让大模型一次性验证,这样一步就可能产出好几个 token。
这三方面后面的章节会分别展开。
1.3 如何评价优化得如何
光看每秒多少 token 是不够的:输入长度、模型大小、显卡型号都会影响这个数字,单看它并不知道离硬件的极限还有多远。优化的目标其实只有一个:尽可能把硬件的能力用满。衡量用了多少的指标有两个:MFU 和 MBU。
MFU:算力利用率
MFU(Model FLOPs Utilization)衡量的是算力用上了多少:
MFU = 实际每秒完成的有用计算量 ÷ 硬件每秒最多能做的计算量
我们先来算一下 V100 的峰值:V100 有 640 个张量核心,每个核心每个时钟周期能做 64 次乘加,频率约 1.37 GHz,所以每秒最多约 56 万亿次乘加。习惯上按浮点运算次数来算,1 次乘加算 2 次运算,也就是约 112 TFLOPS(每秒 112 万亿次浮点运算)。
我们是三张卡一起算。三张卡里有一张 V100S 稍快一点,但三张卡分到的活一样多,每一步都要互相等,快的那张多出来的能力用不上,所以峰值按最慢那张卡的 3 倍算:3 × 112.58 = 337.74 TFLOPS。
例如:对 40,960 个 token 的输入做 prefill,模型需要的有用计算一共约 2336 万亿次浮点运算(约 1168 万亿次乘加)。我们用了 15.41 秒,平均每秒 151.6 TFLOPS,那么:
MFU = 151.6 ÷ 337.74 ≈ 44.9%
这里有两点要注意:
- 只算有用的计算:为了方便切分而补的零、多张卡上重复做的计算都不算,不然数字会虚高。
- 不可能到 100%:在 V100 上,即使是最理想的测试程序,张量核心也只能持续跑到峰值的约 87%;我们手写的矩阵乘最好能到约 76%。何况模型里还有很多不是矩阵乘的计算。
MBU:带宽利用率
MBU(Model Bandwidth Utilization)同理,衡量的是显存带宽用上了多少:
MBU = 实际每秒读取的必要数据量 ÷ 显存带宽峰值
这里的必要数据,指的是每一步 decode 都必须从显存读出来的东西:全部权重、这个请求的 KV cache,以及其他状态。
例如:早期的 INT8 版本、关掉投机解码、输入 64k token、单个用户时,每生成一个 token,每张卡要读约 11.6 GB 数据(权重约 9.4 GB,KV cache 约 2.1 GB,其他状态约 0.1 GB),用时 24.95 毫秒,相当于每秒读 467 GB。V100 的显存带宽是 900 GB/s,那么:
MBU = 467 ÷ 900 ≈ 51.9%
带宽同样到不了 100%,单个算子实测最好也就在 80%–90% 左右。
Prefill 看 MFU,decode 看 MBU
前面提到过,prefill 卡在算力上,所以我们用端到端 MFU 来评价 prefill 的优化程度:从收到请求到吐出第一个 token,平均用上了多少算力。decode 卡在带宽上,所以我们用端到端 MBU 来评价 decode:生成过程中,平均每一步用上了多少带宽。decode 的 MFU 天生只有百分之一二,没什么参考意义。
这里的端到端,指的是用户实际等待的总时间,里面包含了所有开销:卡之间的通信、CPU 调度、各种小算子、互相等待等等。它和单个算子的利用率是两回事。例如:把上面的 decode 例子换成开启投机解码的线上配置,三个最大的算子(矩阵乘、attention、输出层)各自都能用到 68%–74% 的带宽,端到端却只有 43%,剩下的时间都花在了通信、CPU 调度和一堆搬不了多少数据的小算子上。很多优化工作,就是在想办法把这部分时间找回来。
最后要说明的是,MFU 和 MBU 只是诊断工具,不是最终目标,最终目标还是用户感受到的速度。比如开启投机解码后,单个用户的输出速度从每秒 40 个 token 提高到了 76 个,MBU 反而从 51.9% 降到了 43.3%,因为它多做了一些搬数据效率不高的工作。这种情况我们当然选更快的那个。
1.4 并行方式
当一张卡放不下、或者一张卡算得太慢时,就需要多张卡一起干活。我们的模型如果按 FP16(每个参数 2 字节)存,权重就有 54 GB,一张 32 GB 的 V100 根本放不下。多卡分工主要有下面几种方式:
- DP(数据并行):每张卡放一份完整模型,各自服务不同的用户。卡之间基本不用通信,最简单;但前提是一张卡放得下整个模型,而且单个请求不会因此变快。适合模型小、用户多的场景。
- TP(张量并行):把每一层的大矩阵切成几份,每张卡算一份,算完再把结果合起来。这个合并操作叫 all-reduce:每张卡各算出一部分和,加在一起后再让每张卡都拿到总和。好处是每张卡只需存、只需读 1/N 的权重,decode 时每张卡要搬的数据少了,单个请求也能变快。代价是每一层都要通信,例如我们的模型每一步 decode 要做 130 多次卡间通信。所以 TP 对卡间连接的速度要求很高,一般只用在同一台机器里、用 NVLink 等高速互联连接的卡之间。
- PP(流水线并行):按层切。第 1 张卡算前 1/N 的层,算完交给第 2 张卡算接下来的层,依此类推。卡之间只在交接处传一点数据,通信量很小,适合跨机器或者卡间连接慢的情况。缺点是单个请求仍然要依次经过所有卡,速度不会变快;而且要有足够多的请求把流水线填满,否则总有卡在空等,这部分空等叫气泡(bubble)。
- EP(专家并行):只用于 MoE 模型(见 1.6)。MoE 模型里有很多个专家子网络,每个 token 只用其中几个。EP 把不同的专家放到不同的卡上,每个 token 被发往它选中的专家所在的卡,算完再发回来。适合 DeepSeek-V3 这类有几百个专家的超大 MoE 模型(Qwen3.8 27B是个稠密的模型,没有MoE)。
- CP(上下文并行):把一条特别长的输入切成几段,分给不同的卡同时做 prefill。因为 attention 需要看到全部上下文,卡之间还要互相传递 KV。适合几十万到上百万 token 的超长输入,主要用来缩短首字延迟。
方式 |
切什么 |
通信 |
单个请求会变快吗 |
典型场景 |
|---|
DP |
不切,每张卡一份完整模型 |
几乎没有 |
不会 |
模型小、用户多 |
TP |
每一层的矩阵 |
每层都有,非常频繁 |
会 |
单机多卡,有高速互联 |
PP |
层 |
只在交接处,量小 |
不会 |
跨机器、互联慢 |
EP |
MoE 的专家 |
每个 MoE 层收发 token |
主要为了放得下、提吞吐 |
大型 MoE 模型 |
CP |
输入序列 |
attention 时交换 KV |
prefill 会 |
超长上下文 |
实际部署时,这几种方式经常组合使用,例如机器内部用 TP、机器之间用 PP,大型 MoE 模型用 EP 加 DP(部分情况下会考虑TP)。
我们的选择:TP=3
我们的三张卡在同一台机器里,模型是稠密的(不是 MoE),又希望单个用户也能快,所以用 TP 把模型切成了 3 份。但这也带来了两个难点:
- 没有 NVLink:卡之间只能走 PCIe 3.0,实测单向每秒约 8–10 GB,而 NVLink 版 V100 的标称互联带宽是 300 GB/s。TP 每层都要通信,通信很容易成为瓶颈,后面会专门用一章来讲。
- 3 不好分:模型里很多维度不是 3 的倍数,或者除以 3 之后对不齐硬件需要的大小,只能补零或者复制。例如:前馈层的中间维度 17408 要补到 17664;普通 attention 只有 4 个 KV 头(见 1.5),没法平分给 3 张卡,早期版本里干脆每张卡都存了一份完整的 KV cache。
1.5 KV cache
我们先来看 attention 在做什么。attention 是模型里让 token 之间交换信息的部分:生成每个新 token 时,它要用到前面所有 token 的信息,并决定从每个 token 那里取多少。为此,每个 token 在每个 attention 层都会算出两个向量:
- K(Key):用来和其他 token 的 Q 比较,算出两者的相关程度;
- V(Value):这个 token 要提供出去的信息。
新 token 还会再算出一个 Q(Query),拿它和前面每个 token 的 K 算相似度,再按相似度把各个 V 加权求和。
关键在于,前面 token 的 K 和 V 一旦算出来就不会再变。所以我们可以把它们存起来,下一步直接用,这就是 KV cache。如果不存,每生成一个 token,都要把前面的全部内容重新 prefill 一遍。
KV cache 为什么这么重要
- 它占显存,决定了能读多长、能同时服务几个人。 KV cache 的大小 = 层数 × KV 头数 × 每个头的维度 × 2(K 和 V)× 每个数的字节数 × token 数。我们的模型有 16 个普通 attention 层,每层 4 个 KV 头,每个头 256 维,每个 token 要存 16 × 4 × 256 × 2 = 32,768 个数,按 FP16 存就是 64 KB。260k token 的上下文就要 16 GB,而一张 V100 一共才 32 GB,还得放权重。所以我们把 KV cache 压成了每个数 1 字节(FP8),容量翻了一倍。
- 它占带宽,决定了长上下文时 decode 的速度。 decode 的每一步,都要把这个请求的 KV cache 全读一遍。在前面 MBU 的例子里,64k 上下文时每张卡每步要读约 2.1 GB 的 KV cache;到 260k 时就要约 8.6 GB,和权重差不多大了。上下文越长,decode 就越慢。
- 它可以复用,省掉重复的 prefill。 多轮对话里,每一轮的输入都包含了之前所有轮的内容;很多请求也会共用同样的系统提示词。只要开头相同,以前算好的 KV cache 就能直接拿来用(prefix caching),只需要算新增的部分。例如:我们实测一个 64k token 的输入,命中缓存时 1.5 秒就开始吐 token,完全重算则要 27.6 秒。为了能缓存更多内容,我们还在内存里开了一个 60 GB 的池子:显存放不下的旧缓存先挪到内存里,需要时再搬回显卡。
前面提到过,框架是用分页的方式管理 KV cache 的(PagedAttention):把显存切成固定大小的块,按需分给各个请求,用完回收,不需要给每个请求预留一整段连续空间。
我们模型的特殊之处
我们的模型 64 层里只有 16 层是普通 attention,另外 48 层是线性注意力(Gated DeltaNet,见 1.6)。线性注意力不保存每个 token 的 K 和 V,而是维护一份固定大小的状态,每个请求约 150 MB,不会随上下文变长而变大。如果 64 层都是普通 attention,KV cache 会是现在的 4 倍。代价是这份状态只能在特定位置保存下来,复用起来比普通 KV cache 麻烦,这个后面会讲。
1.6 模型的组成
我们来看一个模型具体由哪些部分组成。如下图所示,输入文字先被切成 token,通过查表(embedding)变成向量,然后依次经过 64 层计算,最后由输出层(lm_head)给词表里的每个 token 打分,选出下一个 token。
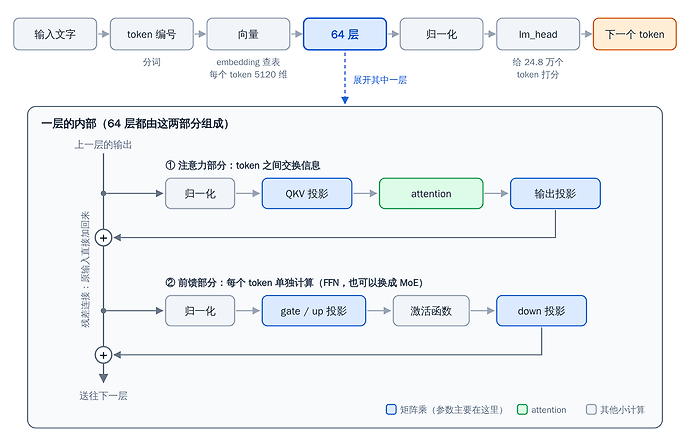
其中每一层都由两部分组成:
- 注意力部分:让 token 之间交换信息。先做一次归一化(把数值调整到合适的范围),用矩阵乘把每个 token 的向量投影出 Q、K、V;然后做 attention(1.5 介绍过);再用一次矩阵乘投影回原来的维度,加回到输入上。这一步叫残差连接,也就是说每一层算出来的结果是加在输入上的修正量。
- 前馈部分(FFN):每个 token 各自单独计算,不和其他 token 交互。同样先归一化,然后用矩阵乘把 5120 维放大到 17408 维(gate 和 up 两个投影),经过一个激活函数,再用矩阵乘压回 5120 维(down 投影),最后加回残差。
有些模型会把 FFN 换成 MoE(混合专家):准备几十到几百个小 FFN(叫作专家),每个 token 由一个小路由器挑出其中几个来用。这样模型的总参数可以很大,但每个 token 只用到一小部分,计算量并不大。我们用的模型是稠密的,没有 MoE,每个 token 都要用到全部参数。
从计算的角度看,一层里最重的是那几个投影,它们本质上都是矩阵乘(GEMM),模型绝大部分参数也在这里:我们的模型约 270 亿参数中,有 243.5 亿在投影矩阵里,光 FFN 就占了 171 亿。attention 本身没有参数,但它的计算量随上下文长度的平方增长,输入越长占比越大;decode 时它还要读 KV cache。剩下的归一化、激活函数、残差相加等操作计算量很小,但次数很多。
我们用的模型:Qwen3.8-27B
项目 |
数值 |
|---|
层数 |
64 层:48 层 Gated DeltaNet + 16 层普通 attention,每 4 层里 3 层线性注意力 + 1 层普通 attention |
每个 token 的向量长度 |
5120 |
FFN 中间维度 |
17408 |
普通 attention |
24 个 Q 头、4 个 KV 头,每个头 256 维 |
词表大小 |
248,320 |
原生上下文长度 |
262,144 token |
附加部分 |
1 个 MTP 层(用于投机解码),1 个视觉编码器(看图) |
它和常见的模型相比有两点不同:
- 混合注意力:普通 attention 每生成一个 token 都要用到全部历史 token 的 K 和 V,历史越长越慢、越占显存。Gated DeltaNet 是一种线性注意力,它把历史压缩进一个固定大小的状态矩阵,每来一个新 token 就更新一次,计算量随长度线性增长,显存则不随长度增长。代价是压缩会丢信息,所以模型每 4 层保留了 1 层普通 attention,保证能准确取到很早之前的信息。
- 自带 MTP 层:模型训练时额外学了一个小模块,能根据当前的状态猜出接下来的几个 token。推理时可以用它来做投机解码,后面会有专门的章节介绍。
这一节我们只讲每一层大致在做什么,每个部分具体怎么算、在 V100 上怎么写得快,会在后面算子优化的章节展开。
1.7 数字的精度与量化
模型的参数和计算过程中的中间结果都是小数,存储时可以选不同的精度:位数越多越精确,也越占地方。常见的格式有:
格式 |
每个数占用 |
说明 |
|---|
FP32 |
4 字节 |
单精度浮点数,训练时常用 |
FP16 / BF16 |
2 字节 |
推理常用的精度 |
INT8 / FP8 |
1 字节 |
8 位整数 / 8 位浮点数 |
INT4 / FP4 |
半个字节 |
4 位 |
量化就是用更少的位数来存参数,好处有两个:一是省显存,例如我们的模型按 FP16 存要 54 GB,按 INT8 约 27 GB,如果全部用 4 位只要约 14 GB(另外还要存一些缩放系数);二是 decode 更快,decode 卡在读数据上,要读的数据少了,速度自然就能提上去。代价是会损失一些精度,所以每次量化后都要验证回答质量没有明显变差。
量化方案常写成 WxAy 的形式:W 是权重(weight)的位数,A 是激活值(activation,也就是计算过程中的中间结果)的位数。例如:W8A8 是权重和激活都用 8 位,W4A16 是权重用 4 位、激活用 16 位。
这里 V100 又有一个限制:新显卡有直接计算 FP8 甚至 FP4 的硬件(例如 H100 支持 FP8,RTX 5090 两种都支持),而 V100 的张量核心只会算 FP16。所以在 V100 上,低位数的权重只能边读边还原成 FP16 再计算:省下的是显存和带宽,算力并没有省。我们先后用过 W8A8(INT8 权重)和以 4 位为主的 NVFP4 混合格式,KV cache 用 FP8,这些都需要我们自己写还原和计算的算子。
1.8 我们的硬件,以及难在哪里
最后我们来看一下我们的硬件,并和现在的消费级旗舰 RTX 5090 对比一下:
项目 |
我们的机器(每张卡) |
参考:RTX 5090 |
|---|
显卡 |
1 张 V100S + 2 张 V100 PCIe |
1 张 RTX 5090 |
发布时间 |
2017 年(V100S 为 2019 年) |
2025 年 |
显存 |
32 GB |
32 GB |
FP16 张量核心算力 |
112 TFLOPS(V100S 为 130) |
209.5 TFLOPS(FP16 累加时为 419) |
NVFP4 张量核心算力 |
112 TFLOPS(无实际硬件,用 FP16 计算模拟) |
1676 TFLOPS |
显存带宽 |
900 GB/s(V100S 为 1134) |
1792 GB/s |
卡间互联 |
PCIe 3.0,无 NVLink(理论单向约 16 GB/s,实测 8–10 GB/s) |
PCIe 5.0,无 NVLink(理论单向约 64 GB/s) |
张量核心支持的低精度 |
只有 FP16 |
FP8、FP4 |
可以看到,一张 5090 的显存和 V100 一样大,但 FP16 算力是 V100 的 2~4 倍,带宽是 2 倍。差距最大的是低精度:5090 能直接算 NVFP4,V100 只能还原成 FP16 再算,算力差了约 15 倍。
p.s. 现在 V100 32G 在闲鱼上大概 3200 元一张,而 5090 32G 全新已经要 4.3w 了(二手也得 3.2w+),买一张 5090 的钱足够买 10 张 V100。前面提到过,decode 主要吃显存带宽,10 张 V100 的总带宽(10 × 900 GB/s ≈ 9 TB/s)大约是单张 5090 的 5 倍,只要优化到位,吞吐显然比单张 5090 大得多;而且 10 张 V100 的总显存有 320 GB,能塞下更大的模型、更长的上下文。如果不考虑电费的话,V100 的性价比其实相当不错,这也正是我们写这篇文章的原因。
那么,我们如何把v100优化到位呢?
结合前面的内容,我们的难点主要有四个:
- 软件不支持:主流框架和新算子不再适配 V100,量化矩阵乘、8 位 KV cache、新模型的线性注意力算子都得自己写。
- 互联慢:TP 每一层都要通信,而 PCIe 3.0 比 NVLink 慢几十倍(见 1.4)。
- 显存紧:每张卡只有 32 GB,要放约三分之一的权重、3 个用户各 260k token 的 KV cache,还有计算时的临时数据。
- 模型新:线性注意力、MTP、多模态,都需要专门的算子和框架支持。
后面的章节,我们会大致按量化与存储格式、算子、卡间通信、框架调度、服务部署的顺序,讲讲我们是怎样把这些问题一个个解决的。
本章小结
- 推理分为 prefill 和 decode 两个阶段:prefill 一次读完整段输入,卡在算力;decode 一次只写一个 token,卡在显存带宽。
- 跑模型靠推理框架(调度请求、管理 KV cache、组织算子)和推理算子(底层计算)配合,此外还可以用量化、投机解码等算法手段。
- 我们用端到端 MFU 衡量 prefill,用端到端 MBU 衡量 decode,但最终还是要看用户感受到的速度。
- 多卡并行有 DP、TP、PP、EP、CP 几种方式。我们用的是 TP=3,代价是每层都要通信,而我们的卡之间只有 PCIe。
- KV cache 决定了能读多长、能同时服务几个人、长上下文时 decode 有多快,还能通过复用省掉重复计算。
术语速查
术语 |
含义 |
|---|
token |
模型处理文字的最小单位,约一个英文单词或一两个汉字 |
Prefill / Decode |
读入整段输入 / 逐个生成输出 |
TTFT(首字延迟) |
从发出请求到收到第一个输出 token 的时间 |
token/s |
每秒输出多少个 token |
FMA / FLOPS |
一次乘加 / 每秒浮点运算次数(1 次乘加 = 2 次浮点运算) |
显存带宽 |
每秒能从显存读写多少数据 |
MFU / MBU |
算力利用率 / 带宽利用率 |
算子(kernel) |
在 GPU 上运行的单个计算程序 |
GEMM |
矩阵乘,模型里最主要的计算 |
张量核心(Tensor Core) |
GPU 里专门做矩阵乘的硬件单元 |
KV cache |
保存下来的历史 token 的 K、V 向量 |
批处理(batching) |
把多个请求合在一起算,提高总吞吐 |
DP / TP / PP / EP / CP |
数据 / 张量 / 流水线 / 专家 / 上下文并行 |
all-reduce |
多张卡把各自的部分结果加起来,并让每张卡都拿到总和 |
量化 |
用更少的位数存参数 |
投机解码(MTP) |
先快速猜出几个 token,再让大模型一次性验证 |
CUDA Graph |
把一串算子调用录制下来,之后整段重放,减少 CPU 开销 |
聊天截图:

 乱翻 10-01 19:532楼