本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
创时智驾 IECU 3.1 是一块智驾域控制器(主要有智己LS9和奥迪E5 2个版本),价格1000多块钱,拿来跑个35B MOE模型或者最近热门的JEV开源版速度还将就。原始的板子因为runtime版本过低跑不了ComfyUI,这个包魔改了运行时,Z-image和H3都可以跑,直接把它下载下来做为一个项目,让Codex或者CC去帮你部署即可.
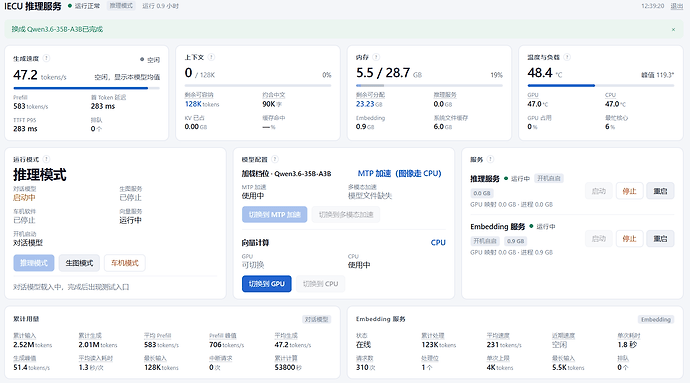
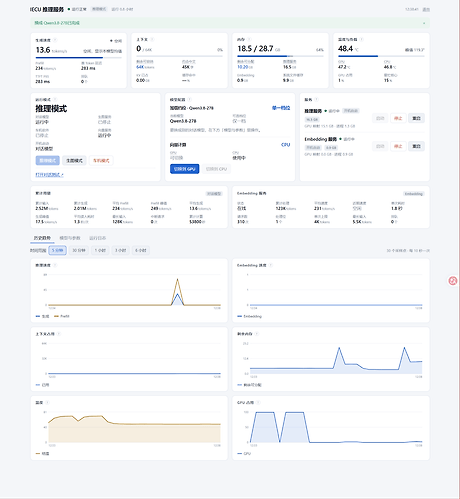
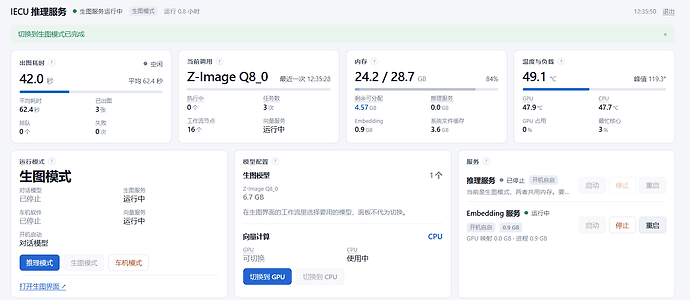
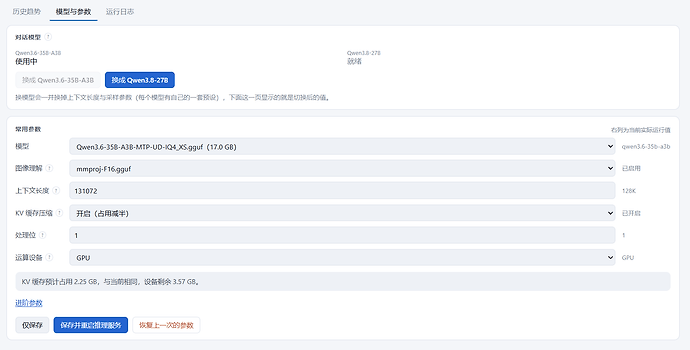
它内置了一个WEB面板,可便捷切换Qwen3.6-35b-a3b/Qwen3.8-27b(带Qwen Embedding模型,单板可跑私有Rag ),ComfyUI生图环境,带全套源码、Skills工作流、部署包、运维面板源码和完整部署资料。skills可以自动分析接入的板子,如果成功进入ssh则可完成自动化部署。
这个设备的硬件与原始系统情况如下:
NVIDIA DRIVE AGX Orin X
12 核 CPU
标称约 254T 算力
32GB 统一内存
128GB UFS 存储
DRIVE OS 6.0.9
Ubuntu 20.04 用户空间
支持以太网和 SSH 登录
原厂车机系统保留,可切回车机模式
本部署包已完成的主要优化:
- 本地大模型
板上已经部署两套大模型环境:
35B:Qwen3.6-35B-A3B,
支持 MTP+多模态同时在线,速度约 30~50 token/s
27B:Qwen3.8-27B,速度约 10~15 token/s
两套模型可以通过面板按需切换
针对 MTP 加速和多模态看图之间的冲突进行了专项调优,现在两套能力都可以稳定使用:
MTP 对话模式(cpu多模态)
多模态看图模式(gpu多模态)
工具调用
128K 上下文
Embedding 向量服务
相对llama.cpp直接部署提速20%
面板带thinking和nothinking2套推理端点适配不同需求(深度推理和指令跟随)
- ComfyUI 生图
原板子不兼容生图,已根据板上实际环境,编译专用运行时,这些都是魔改的,把很多高版本的能力编译进了低版本,解决了依赖问题:
Python 3.13.15(魔改版)
PyTorch 2.11.0(魔改版)
torchvision 0.26.0
torchaudio 2.11.0
CUDA 12.2,Tegra / arm64 版本(魔改版)
cuDNN 9.20
OpenBLAS 0.3.29
Flash Attention
经过多套运行时编译和实际测试,最终选定兼容性和速度最合适的版本。
本部署包优化后的实测效果:
Z-Image,1024×1024,8 步连续出图:约 30.4 秒
相比上一代环境,实际吞吐提升约 40%
ControlNet 双分支,512×512:约 21.3 秒
原来跑不动的 ControlNet 双分支,现在可以正常出图
首张出图约 82 秒,包含模型加载时间
- 中文运维面板情况如下
设计了一套中文运维面板,可以统一管理:
四个 Skills的作用:
- board-discovery(陌生板卡发现与接入)
拿到一个新板后,自动尝试对接解码,解决新板不知道型号、MAC、IP、VLAN、端口和登录方式的问题。
- iecu(现有板子运维与二次开发)
用于换模型、调参数、看监控、排障、管理服务和继续开发。
- iecu-provision(新板基线部署)
把一块新板部署成完整的本地 AI 系统。
- comfyui-import(ComfyUI 工作流导入与适配)
用于检查缺失节点和模型、替换量化模型、适配工作流并验证真实出图。

 wangcccccct 10-01 20:381楼