
如果本地跑embedding模型 推荐哪一个呢
Little_100
2026-10-01 21:52
1
 或者直接用硅基流动免费的 bge-m3? 也不知道速度咋样 ^-^
最新回复 (16)
-
 甘棠 10-01 21:531楼
-
 枫哥 10-01 21:552楼
-
Little_100 楼主 10-01 21:573楼
-
Little_100 楼主 10-01 21:574楼
-
 cyilin 10-01 21:575楼
-
 wintsa 10-01 22:046楼
-
甘棠 10-01 22:067楼
-
 比卡丘 10-01 22:078楼
-
Little_100 楼主 10-01 22:079楼
-
Little_100 楼主 10-01 22:0810楼
-
 8386559 10-01 22:0911楼
-
 vzld 10-01 22:1012楼
-
 蛋蛋 10-01 22:1513楼
-
比卡丘 10-01 22:2614楼
-
蛋蛋 10-01 22:2715楼
-
 apparition 10-01 23:1416楼
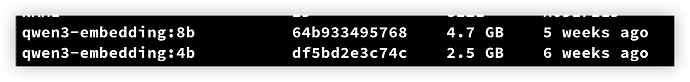

* 帖子来源Linux.do
附近帖子
- ↑不知道开发什么了
- ↑GPT是不是废了。全部号都降智了
- ↑开心的告诉各位佬,我还是买下了三星s26u
- ↑似曾相识cli
- ↑关于Claude订阅的一些疑问
- 📍 如果本地跑embedding模型 推荐哪一个呢
- ↓准备去泰国旅游,又可以泰国买的电话卡吗,或者薅的羊毛
- ↓27应届佬们还好吗
- ↓关于gpu服务器租赁请教
- ↓grok 4.7
- ↓求教佬友哪个模型汉语文采比较好