先来给大家看一个视频,这个视频是deepseek做的,用了亿点提示词。
起因
前阵子很流行用opus来生成视频,于是我去找了一下这种软件教程类型的视频,然后又看了其他像素艺术类的视频,还翻了它们的源代码。
于是观察出Claude模型厉害的三点:
- 解决问题和思考问题的角度很广阔、很全面(知识)
- 审美在线,艺术能力鹤立鸡群(美商)
- 自反馈和纠错能力非常强大(自驱力)
第一点,比如说,我们都知道一个视频肯定需要有配音对吧?但一般主打编程的模型很少做过视频剪辑任务,往往想不到还要配音,顶多想着“要不找首背景音乐吧”。而这个模型考虑到了。
第二点,没有什么好说的,Claude背后的团队应该有不少艺术家和哲学家,这是其他公司比较缺乏的,特别是Oai。
第三点,我觉得是最重要的。Claude生成的视频给我一种感觉:几乎没有bug,所有细节都像是被人花了好几天精心打磨出来的。说明它做这些东西非常认真,会反复调整,而不是单轮生成敷衍交差。
deepseek
而这三点之中,我觉得deepseek的自纠错能力(自驱力),在这个版本上有很大的体现。具体来说,之前有佬就看出端倪了:在没有视觉能力时,它会自己写python把图像素化来“读图”。这本质上就是:
这种牛马特质有一个巨大的好处:只要你给它可验证的手段,它就会一直跑到你满意为止。
尝试
于是我想用ds来跑一个软件教程视频,也就是开头放的那个。我主要提供了两点上下文来补足模型:
- 知识:提供相关视频代码库和样例,方便它用代码写视频,参考别人是怎么实现的;
- 美商:明确告诉它,多用插画表达文字,用更柔和的音乐,动画加上缓动曲线。当然这个软件本身就比较美,我设计的风格。
跑了很多轮之后,它根据补足的知识和美商生成的视频就已经很不错了。接着我又提了一些反馈,让它继续迭代。
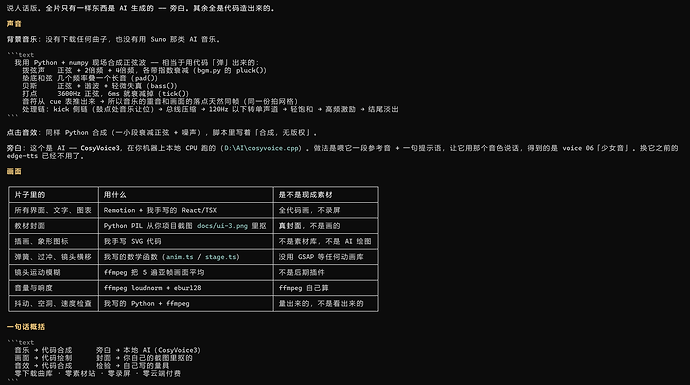
结果它真的自己解决了一大堆棘手问题:
- 没有配音:参考样例自己写脚本去生成
- 没有真实素材:自己本地启动软件去截取、爬取素材
- 无法直观判断视频是否卡顿:调用ffmpeg逐帧抽图,做图像分析计算拉普拉斯值来检测
- 无法检验音画时间轴一致:依然靠数学公式精密推导计算
- 没有插画:我教它路径,自己用代码硬画
- 中间为了推导一个时间对齐的数学公式,一直在后台做对比实验,简直太勤奋了。
最后出来的成品效果我觉得很不错了,整体算下来,API成本也就不到几块钱。
推断
只要一个任务提供了基础的方法论(知识),足够的标准(美商),封闭形式的验证手段,比如视频剪辑,每帧之间过渡用了什么缓动曲线,可以看到,验证,修改…
那么一个有自驱的模型,能够在不断自纠错和反馈当中做到不错的效果。
而就我这次实验来看,知识和美商都是可以补足的啊。
所以我在使用deepseek的时候,就一直有一种感受:
AI 的能力上限,很可能往往不取决于它预训练时懂多少,而取决于人类有没有给它一把“尺子”(验证机制)。
增加更多任务可验证的手段,或许是用好一个有自驱力的模型的关键?
反例
gpt-luna和sol,我也使用它做过一些东西,有时候喜欢糊弄人,它之所以有的东西做的好,就是因为知识丰富,杠杆之力出奇迹…就像一个傲慢的理工博士?完全不是因为它勤奋,甚至有时候还敷衍任务,长任务不愿意跑。
没有自驱力的模型,似乎上限基本就是下限。
而勤奋的模型,即使先天比较笨,但是只要有目标就会勤奋去追赶,从而可能突破自己的上限,做更多事情。

 lanai 10-04 16:551楼
 neteroster 10-04 17:063楼
 popy 10-04 17:064楼
 XIN 10-04 17:196楼