
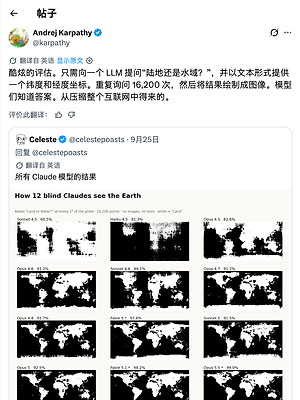
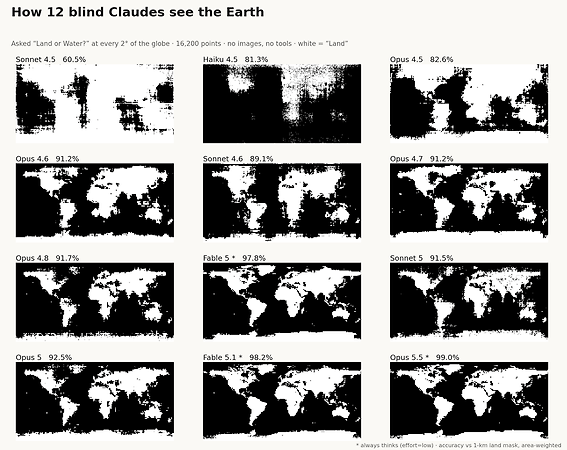
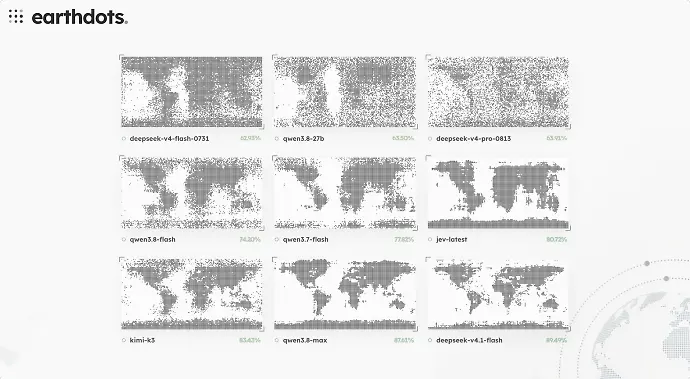
竟然还能这么测模型能力吗???
NowwwW
2026-10-04 21:44
1
最新回复 (12)
-
 calendar 10-04 21:471楼
-
 NullUserSIe 10-04 21:512楼
-
 Zuojingqi 10-04 21:523楼
-
 Angel 10-04 21:524楼
-
NowwwW 楼主 10-04 21:545楼
-
 星渊清梦 10-04 21:546楼
-
NowwwW 楼主 10-04 21:557楼
-
 疯狂麦克斯 10-04 21:578楼
-
 Runwhere 10-04 21:589楼
-
 wcac 10-04 21:5810楼
-
NowwwW 楼主 10-04 22:0511楼
-
星渊清梦 10-04 22:1712楼

* 帖子来源Linux.do
附近帖子
飞读
NowwwW
随机推荐
- 261004实测 claude 5x不弹kyc
- 【提问】挂载谷歌盘除了付费的CD2还有其他选择吗
- 「影视站」2 天的时间 总结下
- 115ck emby 和播放器扫码登陆115观看有区别吗
- 出hostdare小鸡一枚。
- 有没有收菲区20x的【降智】 满额度带3次刷新
- GPT 6 Astra 真的有那么牛逼吗
- X 全新的 XPass订阅即将来了,之前印度区、3个月折扣开的年费SuperGrok订阅要作废了?
- 不降智的 6.1sol 很能打,吉吉 api 先人一步 已经实现 6.1sol 全站不降智并加入实时监测,倍率 0.19,能打省钱才是真理,欢迎 v 佬来测,回复送鸡蛋测试。
- 有了vmiss的cn2,还有Dmit的AS3.pro.tiny,佬友们 感觉不太靠谱呀!