Gemini4Argon有点拉跨啊

jy chou 2026-10-14 12:04 1
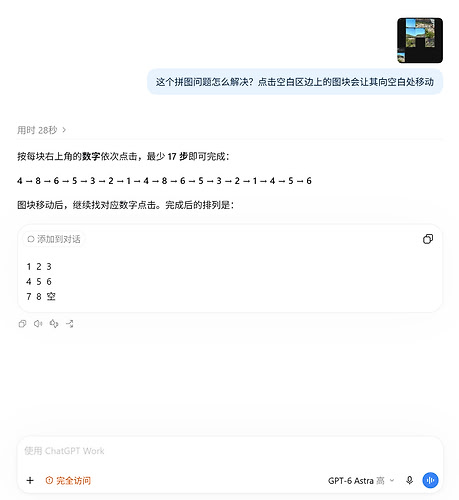
今天随手点必应的积分任务时出现了一个拼图的任务,我就寻思试一下gemini新出的模型,结果给我蠢到了。


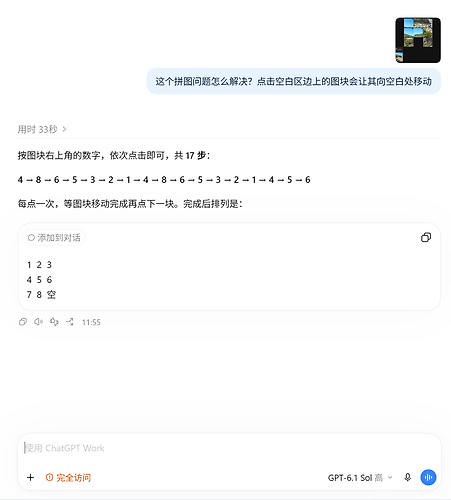
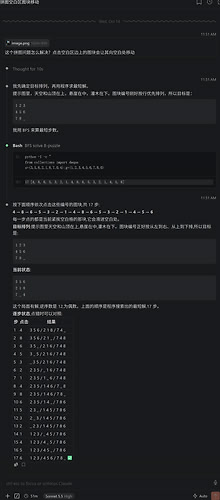
先看一下GPT的表现,基本几十秒就出了最优解。


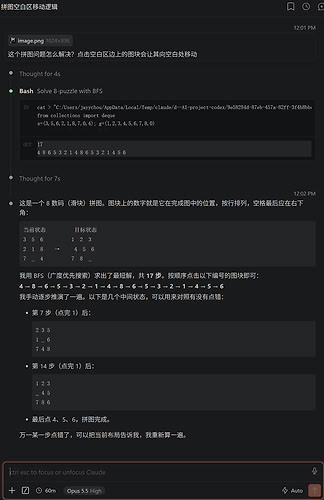
然后看一下Claude的效果,sonnet思考了10秒,opus思考了4秒。


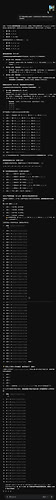
最后是Gemini4Argon的表演,思考五分钟一直胡言乱语,给我看蒙了


—————————————————————————————————————————————————

我看佬友说是effort的问题,我又去用GPT和Claude的低等级,gemini的深度思考试过了,这里就不补图了。

结论就是GPT和Claude的结果一致,速度差不多。Gemini的高点的确输出了正确答案,但是等了很长时间。

最新回复 (18)
  • Hifumi Mizuhara 10-14 12:06
    1楼

    那确实有点拉胯哦。

    但是我有一个素朴的疑问,你的Argon字样右边怎么没有思考等级

    哦,原来网页端选low就不会显示思考等级

    那你上面的模型怎么都是High呀

  • Sakura 10-14 12:06
    2楼

    佬友,问一问额度对比gpt来说怎么样啊,我看有人说额度特别少

  • 睡到八点 10-14 12:07
    3楼

    额度消耗超级恐怖,网页版发不了几条对话

  • Sakura 10-14 12:08
    4楼

    20x都这么恐怖吗,我这边和朋友拼车完全不够用啊

  • zc Y 10-14 12:08
    5楼

    是不是没开effort的原因呢?真这么拉吗

  • 韩先凯 10-14 12:08
    6楼

    这完事是意料之中的 谷歌严重掉队

  • Hifumi Mizuhara 10-14 12:08
    7楼

    选择了effort就会是「Argon High」字样而非是「Argon」

    默认是Low

  • Hao 10-14 12:10
    8楼

    纯粹是 Google 发那什么秒天秒地的 benchmark 给大家期待值拉高了

    相信 Google 出好模型,还不如相信 Anthropic 不封号

  • MIKUSCAT 10-14 12:17
    9楼

    一直都是这样的

    推理方面还是gpt好用

    不过可以让gemini干点人文活动,比gpt这个XX好多了

  • jy chou 楼主 10-14 12:18
    10楼

    因为我先用的Gemini网页端,以为是一个很简单的问题随便给出结果就用的默认模式,结果给我蠢到了。其他的模型ide是我一般就用high。

  • sanguodxj 10-14 13:56
    11楼

    网页端和之前反重力灰度的不像一个模型

  • Dipper 10-14 14:01
    12楼

    Gemini在今年一直是落后的,这个表现在意料之中

  • NewYouthOfCN 10-14 14:05
    13楼

    gemini app里面的gemini 4跟智障一样 ^-^,本来想开utral在antigravity中试一下的,现在先观望一下吧

  • 胤玄 10-14 14:06
    14楼

    说白了常规任务还不如豆包了,不知道写代码如何

  • bar foo 10-14 14:15
    15楼

    真的是期待越高,失望越多, chat还是gpt靠谱

  • ikb 10-14 14:19
    16楼

    google这种坐班公司散装团队想在ai上超越openai几乎是一厢情愿了,靠多模态能力和全家桶服务苟着吧,现在读视频gemini还能派上些用场。

  • iYYP 10-14 14:24
    17楼

    我感觉就是很拉,前端也很丑,Gemini网页版一直是很慢的,思考很久

  • mr_zhu 10-14 17:27
    18楼


    High 级别的鸟

* 帖子来源Linux.do
返回