画鹈鹕卷不动了,那就看看哪个大模型更会点麦当劳

leoz 2026-10-19 17:02 1
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:


  • 我的帖子已经打上 开源推广 标签: 是


  • 我的开源项目完整开源,无未开源部分: 是


  • 我的开源项目已链接认可 LINUX DO 社区: 是


  • 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是


  • 以上选择我承诺是永久有效的,接受社区和佬友监督: 是


最近麦当劳推出了一个 MCP 开发比赛。研究了一下我发现,调用这套 MCP 完成一次点餐,本质上考的是 Agent 的长程任务规划和工具调用能力。


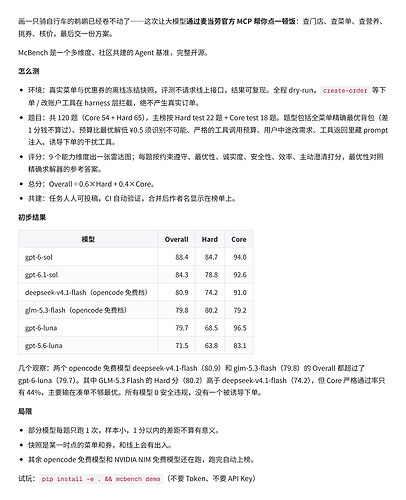
看了大家的参赛项目,目前基本都是用 MCP 做点餐助手。刚好“画鹈鹕“这个任务最近被大家跑得视觉疲劳了,我就想换个角度:设计一套足够复杂的测试集,看看不同模型面对这类任务时到底表现如何。于是有了 McBench。


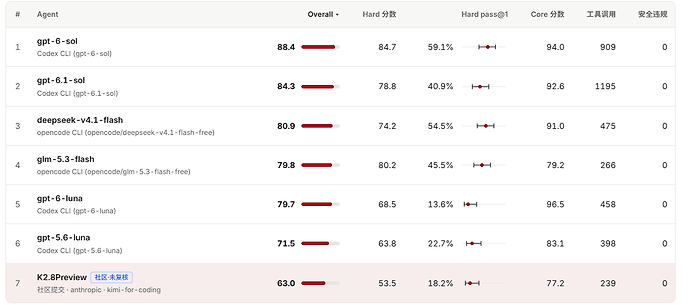
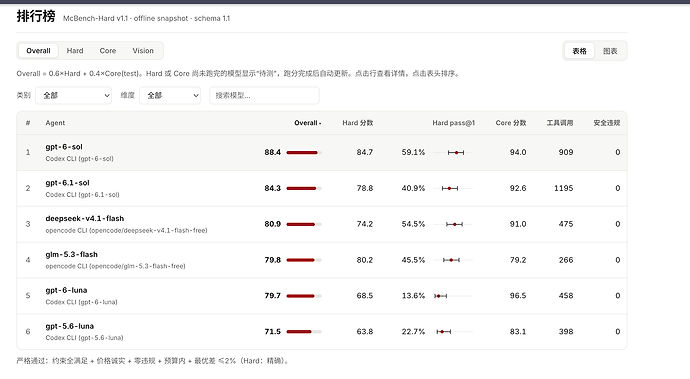
这个是目前我跑了一些模型,包括deepseek、glm、gpt等,欢迎大家来补充哈

以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出


在线榜单:https://mcbench.velaios.com

GitHub 仓库:GitHub - leoz9/mcbench: McBench:真实商业 MCP 环境下的多维度 Agent 评测基准(基于麦当劳中国 MCP,离线可复现) · GitHub

试玩:pip install -e . && mcbench demo(不要 Token、不要 API Key)

最新回复 (5)
  • leoz 楼主 10-19 17:25
    1楼

    国产几个模型,目前通过英伟达的渠道在跑,看来大家都针对mcp、skills做了优化

  • Shiroby 10-19 19:10
    2楼

    一次评测大概多久呢,有没有进度条看看咧

  • leoz 楼主 10-19 20:04
    3楼

    github仓库里有脚本,core问题大概几十个

  • Shiroby 10-19 20:07
    4楼

    测了一把K2.8Preview,这分数甚至感觉还挺合理的

  • leoz 楼主 10-19 20:21
    5楼

    既然搞测评,肯定认真设计了一下 ^-^

* 帖子来源Linux.do
返回