字节回应“超一半算力造爽剧”:视频模型训练与推理合计仅占约 10%

牡蛎 2026-10-19 23:20 1
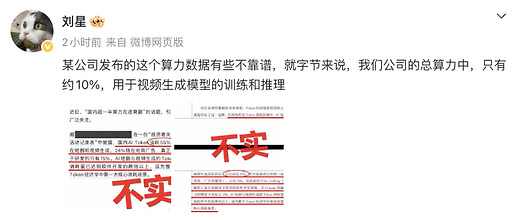
事件起因:中文在线在投资者关系记录表中披露,国内 AI Token 消耗中 55% 烧在短剧与视频生成,电商广告占 24%,而用于核心研发的仅占 15%,宣称短剧已成整个 Token 经济学的第一大消耗黑洞。


字节公关负责人回应:10 月 19 日,豆包公关负责人刘星公开拆台,直言该数据“有些不靠谱”。他表示,即便在字节跳动内部,全公司总算力中也仅有约 10% 用于视频生成模型的训练与推理。


[豆包刘星回应“国内超一半算力在造爽剧”:字节总算力中,只有约 10% 用于视频生成模型的训练和推理 - IT之家]

最新回复 (11)
  • JKstring 10-19 23:34
    1楼

    也就是手里握着巨大的算力也没做出什么厉害的模型吗…感觉还不如承认了大部分算力用来做短剧了 ^-^ ^-^

  • 青玉白露 10-19 23:36
    2楼

    其实这个数据感觉一开始就是假的。谁知道别人拿AI来做什么?又不是所有的ai都走某一个平台

  • lucas 10-19 23:38
    3楼

    不是说seadance是一个200B的模型嘛好像,以10%来训练也不少了,毕竟字节有这么多业务,主要还有大量的资源在语言模型部署那边

  • antior 10-19 23:39
    4楼

    即便在字节跳动内部,全公司总算力中也仅有约 10% 用于视频生成模型的训练与推理。


    这个没看懂,他是想说字节跳动内部用于视频生成比C端多,但是内部才不到10%,所以外部更低么?可是怎么感觉外部的更多呢?

  • listening 10-19 23:39
    5楼

    当时混元团队不是说字节在做规模超级大的模型吗,现在也没怎么听到风声了。

  • xiayi 10-19 23:40
    6楼

    字节的视频模型还不厉害么

  • lucas 10-19 23:43
    7楼

    源内容里没有什么内部和外部的表达,这是自己加的吧。字节seedance应该都是自己部署的,估计都没有打包成二进制交给外部的一些平台部署

  • JKstring 10-19 23:46
    8楼

    厉害的,这不是用来做短剧了…

  • xiayi 10-19 23:50
    9楼

    我是觉得字节的重心已经在视频模型了,至于大语言模型…

    感觉字节手里可能还藏着更强的视频模型没发布,毕竟现在看来,开源闭源都没有啥太大的对手

    minimax H3和 wan3 目前看来 也就跟seedance2.0 fast差不多,可能还比不上?

  • pxw2002 10-19 23:52
    10楼

    他说的只是训练推理,就是训练这个模型用了多少算力,那个一半的说法是说别人用他这个模型,然后生成视频,生成视频的模型比其他技术要耗费很多倍,现在抖音全是各种猫啊狗啊的视频,生成一条就要十几块二十几块

  • JKstring 10-19 23:57
    11楼

    相比于视频,我更希望算力能优先给语言大模型的训练上,毕竟代码目前都是靠大预言模型生成的,这并不是说视频不好,我是重度游戏玩家,我觉得视频生成模型以后对VR游戏可能是一个出路,不需要建模,直接生成视觉3D效果,完全的身临其境,但是大语言模型能达成自己训练自己的效果,现在在算力紧张的时候给视频,实在是有些浪费.当然这都人家自己花钱买的,怎么用是人家的事,但看到是真觉得糟践东西…

* 帖子来源Linux.do
返回