
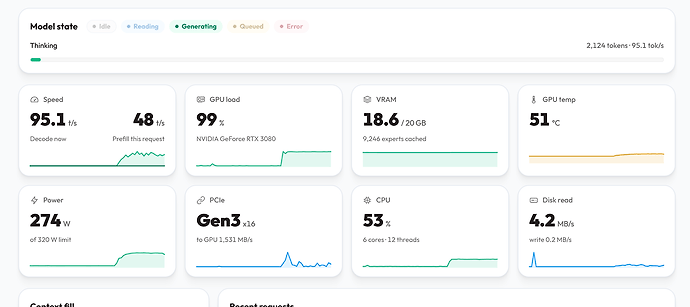
RTX3080 20G部署qwen3.8-flash-next-iq2_xs
重度粉毛厨
2026-10-21 22:13
1
最新回复 (14)
-
 lemos 10-21 22:151楼
-
重度粉毛厨 楼主 10-21 22:172楼
-
 小黄 10-22 10:263楼
-
 Ljj 10-22 10:284楼
-
小黄 10-22 10:315楼
-
Ljj 10-22 10:426楼
-
Ljj 10-22 10:427楼
-
小黄 10-22 10:438楼
-
Ljj 10-22 10:439楼
-
小黄 10-22 10:4410楼
-
Ljj 10-22 10:4611楼
-
小黄 10-22 10:4612楼
-
 中国人会飞 10-22 10:4713楼
-
 fromxiaobai 10-22 10:4814楼

* 帖子来源Linux.do
附近帖子
- ↑开通了claude code,看看多久会被毙
- ↑电子🐑萎了,618买的5070ti到现在还没开箱
- ↑看到佬们说codex 的速度提升了,不知道是否会保持
- ↑bybit的卡被拒,无法续费team。
- ↑Vibe了个词源故事网站,从单词背后的故事来学习词汇
- 📍 RTX3080 20G部署qwen3.8-flash-next-iq2_xs
- ↓有没有佬上班的时候就喜欢逛论坛,下班就完全不开电脑
- ↓比快更快,社区官方 iOS App 更新至 1.0.2
- ↓订阅Max 赠送的200 usd 官key,出这个会有封号风险吗
- ↓笑死,居然还有人不会去安卓油管广告?
- ↓有没有DS-Flash的爽蹬方法,梁圣的API太贵了啊啊