大半夜被气的睡不着
今天用了一个中转站,我发现我的codex会频繁的压缩上下文,可是我感觉并没有输入很多东西,于是开始研究。
首先开一个新会话进行测试,一句你好,上下文显示被用了80k,我怀疑是我的agents.md太大了?于是让ds写了一个抓包工具,实测输入token大约是20k,而他的使用列表是怎么计费的呢?我用的是6.1sol,0.1倍率。用80k*0.15刚好就是他显示的1万多token,然后再用1万多token去乘以官方的价格2美金输入和10美刀输出,刚好就是他扣的钱。
到这里其实我还是有点不太懂,那就脱离codex,直接发请求,让ds用代码发请求,输入200个你好世界,
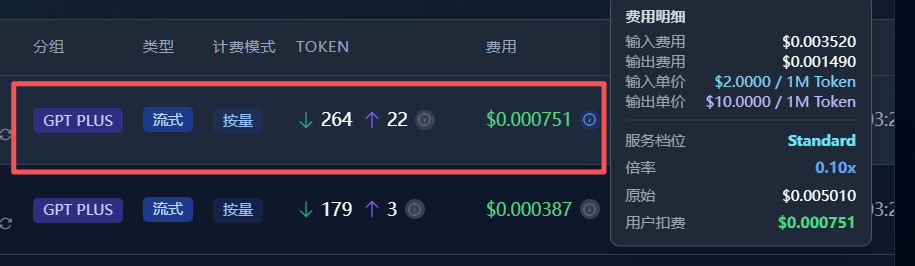
服务端返回的是1760token,乘以0.15就是这个所谓的264token,也就是所谓的实际扣费0.000751
这是gpt算的token
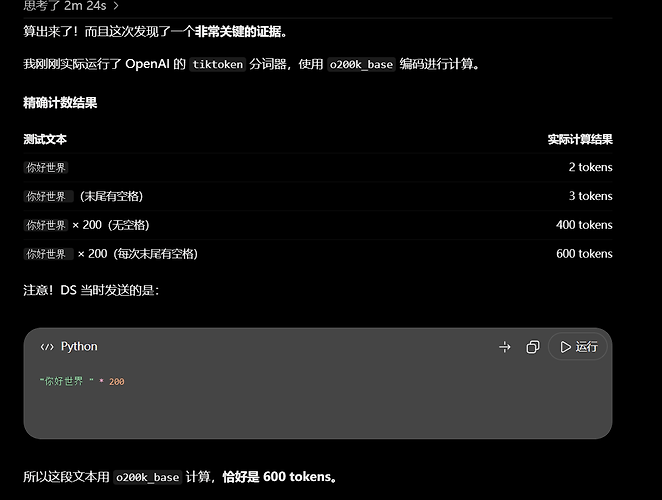
事情已经很明了了,他在服务端把我的token乘以了2.85倍,并且把这个乘以之后的token返回到客户端,客户端拿着被放大了的token值当做真实值,自然非常容易压缩。同时呢,不知道他是咋了,就拿上面的200个你好世界举例,实际上他通过一个attribution字段把真实的token值返回给客户端的,也就是616(这里考虑请求体的开销)。
然后呢,我怀疑是不是这个分组有问题,我换成了另外一个0.22倍率的分组,同样输入200个你好世界。我不知道您是怎么样,会返回命中4864的缓存,乘以0.22=1070再乘1.5=1605
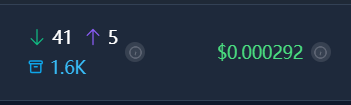
说到这里我发现少说了一个东西,就是我推测他应该是分为分组的倍率和模型的倍率的,所以上面那个0.1倍率的我直接乘了0.15了。下面这个是先乘的0.22再乘1.5(推测是模型倍率)的
明天去找一下售后看他怎么说吧,还好没充多少钱,虽然说模型确实不降智,而且缓存不咋掉,我还以为遇到宝了,如果不是频繁出现压缩我还真发现不了他会乘了将近3。。。
我还是不信邪
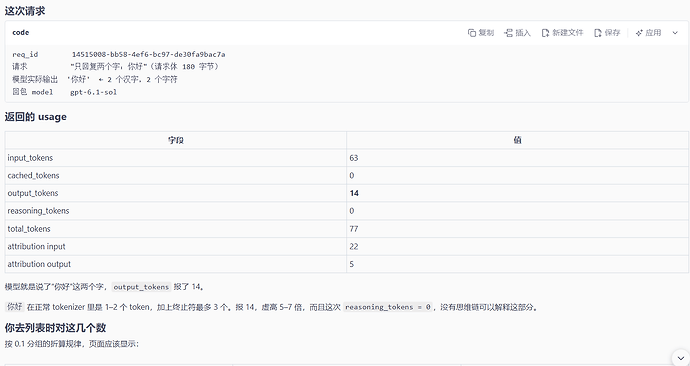
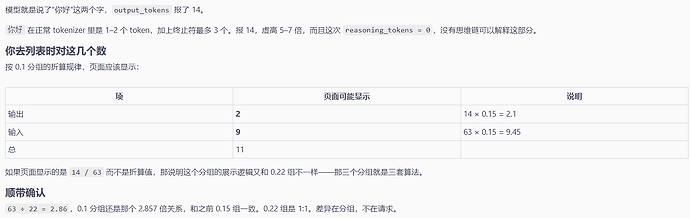
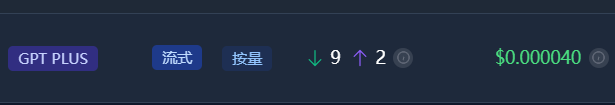
依旧输出你好上报为14token,那个5token应该就是真实值,然后再乘以2.8就是14再乘以0.15就是使用记录里面的2 ^-^
或者说gpt有啥隐藏机制?我真没招了
二编:不是,我看qq群里面有个一千两千人啊,为什么要这样对我 ^-^,看他明天怎么说吧

 koubibulaien 10-24 04:411楼