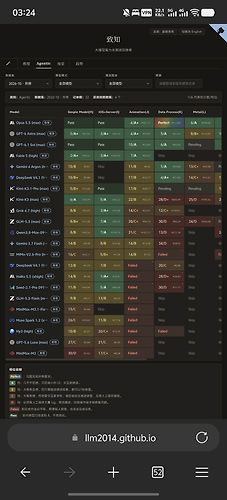
K3.1 偶尔会忽略提示词中的微小细节要求,比如用简短术语来要求完成一个核心功能。项目 H 正是因为这种疏忽导致评级掉到 B 档,项目 M 中也存在这种情况。而 GPT、Opus 则几乎不会有这种情况(这里 GPT 指 Astra,Opus 指 Opus 5.5,下同)。不过如果将要求换一种表述,引起模型重视,则 K3.1 也可以妥善处理。可见并不是模型不会。
K3.1 在不使用工具情况下建模能力显著强于 K3,属于国内最强,但离全球 SOTA 还有极大差距。这方面最强的 Opus 5.5 可以在同样条件下“徒手”创建精度极高,且符合逻辑的各类模型,而 K3.1 首先是达不到相同的精度,其次对模型的逻辑功能处理不好,形似而神不似。当然,如果接上工具,K3.1 能力得到放大,这类问题也不存在了。
任务效率上,K3.1 的呈现出两种截然不同的表现。前端任务通常有不错的直觉,H 项目上也能实现代码文件一次性输出,测试一遍过,不涂改。稍微复杂的前端也可以在有限步骤内完成,效率处于国内 Top,优于前代 K3,基本持平 GPT-6/6.1。但到 N 项目这类略微冷门的技术栈,K3.1 则需要不断现查文档才能逐步推进,并且验证阶段也会很不自信地多次打包,多次跑全程自检,期间也会验出真正问题,但更多时候是在反复改文案和尺寸,意义不大。