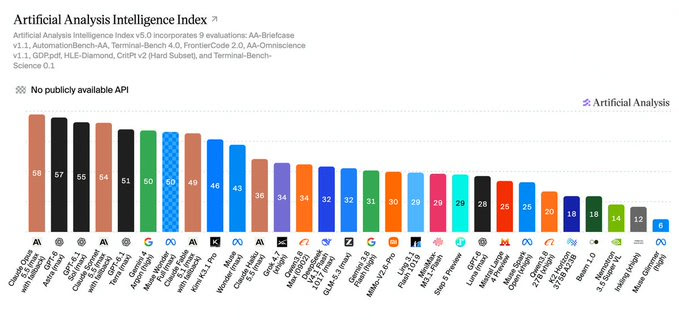
Artificial Analysis 推出 V5 版本智能指数

GreatMOLA 2026-10-28 11:17 1

新增内容:


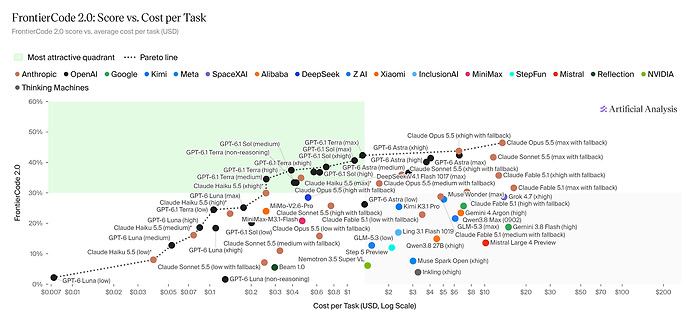
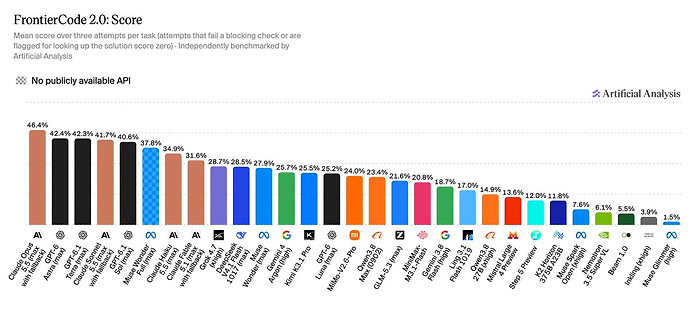
➤ FrontierCode 2.0:Cognition 新推出的私有基准测试,针对现实世界的编码任务,根据仓库维护者是否会合并代理的更改进行评分


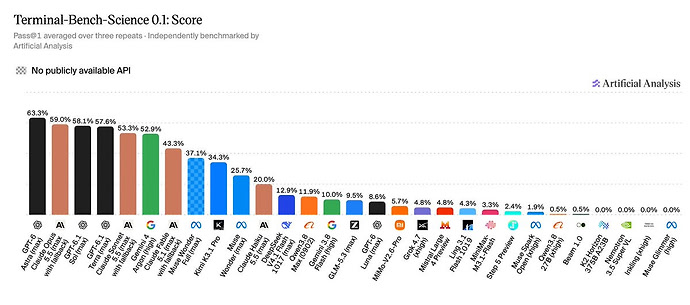
➤ Terminal-Bench-Science:70 个代理式科学研究任务,在终端环境中运行


升级内容:


➤ HLE-Diamond(取代 Humanity’s Last Exam):人类最后考试的精炼版,包含 1000 个问题,推理题和知识题各占一半


➤ AA-Omniscience v1.1:更新后的数据集,移除了饱和和公开集问题,添加了新问题,并修订了模糊或错误的问题


➤ CritPt v2:CritPt v2 的私有 40 题困难子集,由 CritPt 作者修订,并使用代码执行工具运行


保留在指数中的内容:AA-Briefcase、AutomationBench-AA、GDP.pdf 和 Terminal-Bench 4.0


从指数中移除的内容:GDPval-AA v2.1、SciCode 和 AA-LCR v1.1


https://x.com/ArtificialAnlys/status/2115265133467635877

最新回复 (10)
  • avantar 10-28 11:21
    1楼

    开源第一刷分王终于掉下来了

  • Galaxy_Ron 10-28 11:24
    2楼

    科学研究还是 GPT 更强,奈何过度防御和不说人话用的火大


    Terminal-Bench-Science 测试代理是否能够在终端中执行科学研究工作流程。专家策划并审查每个任务,只有当任务的所有测试都通过时,该任务才算通过。GPT-6 Astra(Max)以 63% 的成绩领先,其次是 Claude Opus 5.5(Max)以 59%,以及 GPT-6.1 Sol(Max)以 58%。领先者之后的得分急剧下降:最佳开源权重模型 Kimi K3.1 Pro(权重尚未发布)得分 34%,Claude Haiku 5.5(Max)得分 20%。已发布权重的开源权重模型中最佳的 DeepSeek V4.1 Flash 1017(Max)得分 13%,而我们基准测试的大多数开源权重模型得分低于 10%。


  • windsing 10-28 11:25
    3楼

    AA作为一家评分机构,目前是还没有自己的数据集吗,还是说公开的数据集更认可?

  • Bliod 10-28 11:29
    4楼


  • 予成啊 10-28 11:31
    5楼

    过度防御


    你说得对,但我将要开始探针、快照、证据、门禁、夹具,还有哈希、冒烟、基线了

    我要先建立唯一基线,再进行可追溯备份,先进行最小改动,我先进行一轮烟测,检查89个门禁是否通过,上线前进行一轮全量dry-run,上线后校验哈希值,最后进行一轮实测的验收矩阵。


  • Neptune 10-28 11:35
    6楼

    GPT必须配哈基米中译中才能用,不然烧心

  • 古咕顾 10-28 11:41
    7楼

    k3.1对muse左拥右抱坐一桌啊~


    大鲸鱼已经超过智谱了,可喜可贺


    step5不是pro级模型吗,怎么和m3.1坐一块了

  • Stesla 10-28 11:52
    8楼

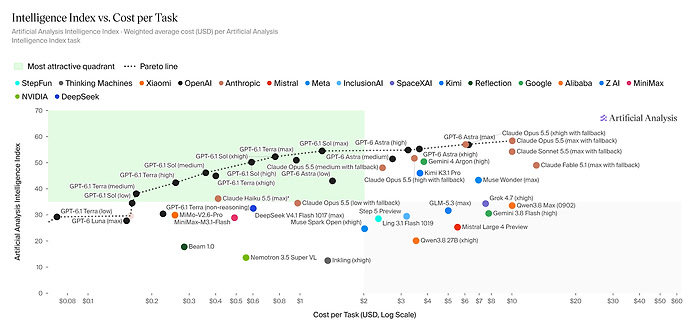
    图中haku5.5>deepseekv4f1017

  • GloryDuck 10-28 11:54
    9楼

    浪潮退下,是谁在裸泳?^-^

  • aeroides 10-28 11:55
    10楼

    那是总榜,这个是代码榜,肥鱼有点偏向代码特化了已经


    RL 大赛

* 帖子来源Linux.do
返回