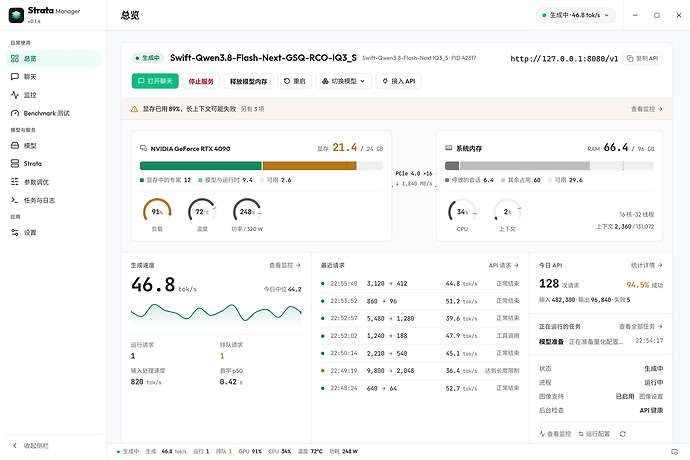
【开源推广】给跑 Strata 的佬友vibe了个桌面管理端, 方便部署、调参、跑分、监控

95jun 2026-10-16 22:13 1
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:


  • 我的帖子已经打上 开源推广 标签: 是

  • 我的开源项目完整开源,无未开源部分: 是

  • 我的开源项目已链接认可 LINUX DO 社区: 是

  • 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是

  • 以上选择我承诺是永久有效的,接受社区和佬友监督: 是


以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出


前段时间升级了魔改版 4080super 32g + 64g 内存,跑 qwen3.8 27b 效果还可以但是速度太慢了,远没达到生产力工具的程度。


最近论坛 Strata 很火,qwen3.8 flash next 本地就能跑,我也跟风跑了一下,用 codex 调优半天,256k 上下文能跑到 3200 tokens/s prefill,解码速度 100 tokens/s 左右,妥妥的生产力工具啊。


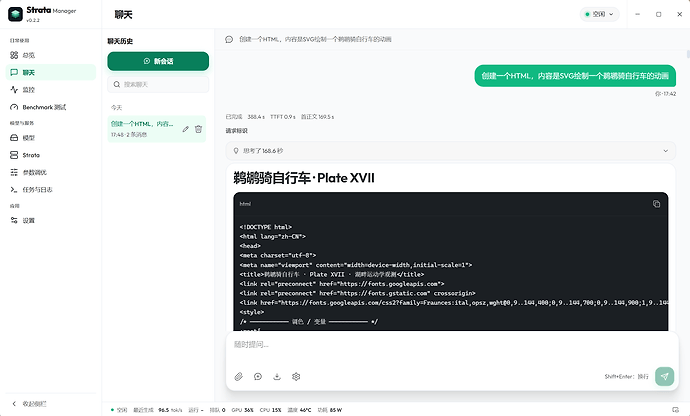
于是就有了 vibe 一个桌面端管理器的想法,codex 龟速压榨两天,软件总算出来了,支持 windows 和 linux,macos 的还在开发中,等待上游官方支持。


主要功能


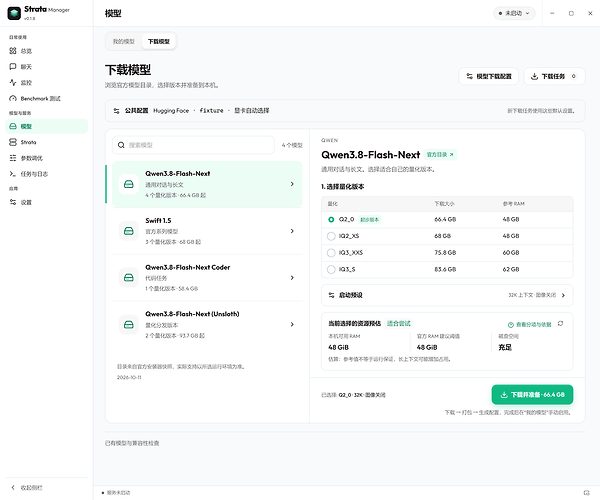
  • 运行环境:检测本机的 Strata,查看本地和上游版本;可以下载引擎包,下载源有官方 GitHub、GH Proxy、自定义地址和本地 ZIP

  • 模型与配置:自动发现本地模型文件,按模型分组管理配置,能看 GGUF 元数据和磁盘占用

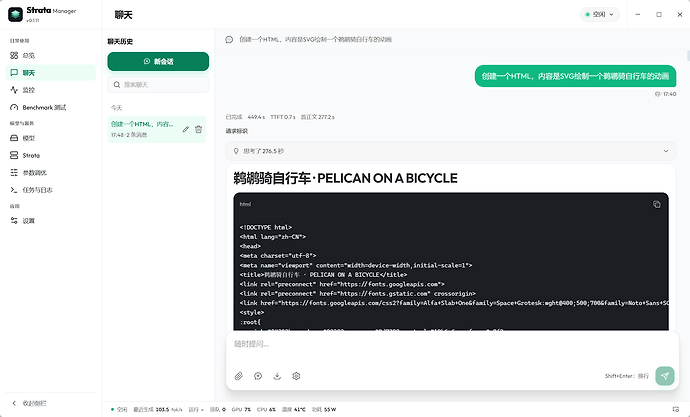
  • 配置与运行:图形化表单或 JSON 编辑,带校验和备份;启动、停止、重启、释放显存,能看到启动阶段和日志

  • 聊天与接入:流式聊天,支持附件和结构化输出;可以配置 API 地址、访问密钥和 MCP

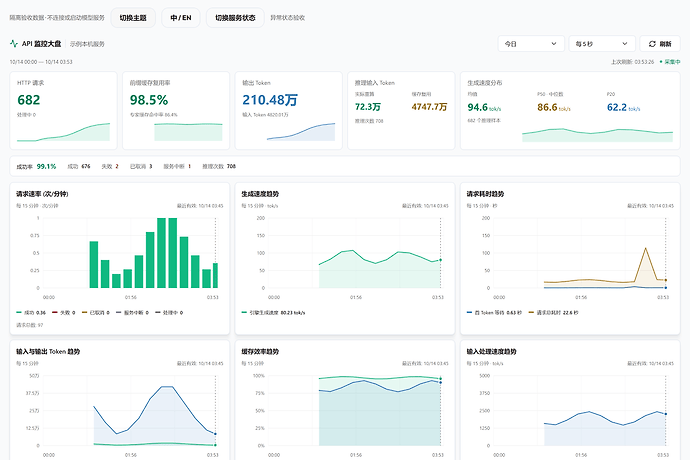
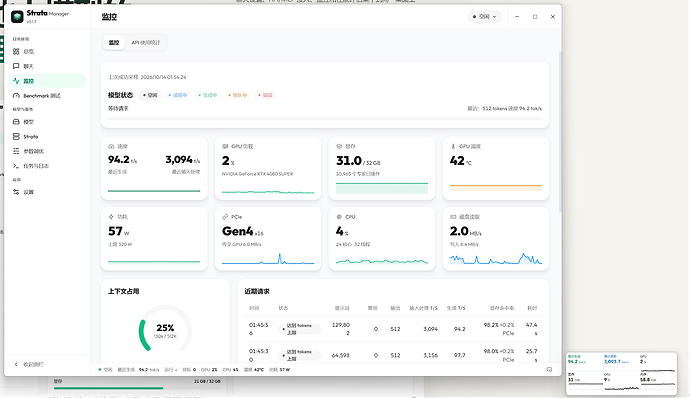
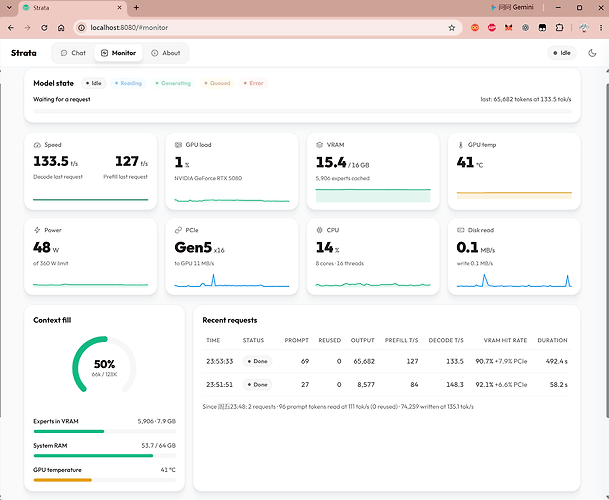
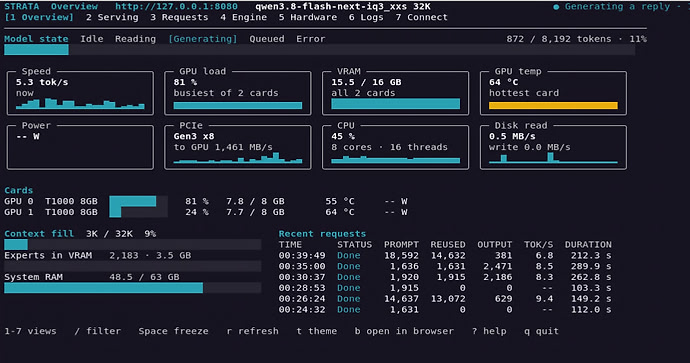
  • 监控:会话保存和恢复,看 slot、负载和硬件;有悬浮监控窗和托盘监控

  • 用量与调优:统计本地 API 的请求、token、延迟和缓存复用,不记录请求内容;可以对比调优候选,再决定要不要应用

  • 基准测试:按上下文档位或场景跑测试,记录 prefill / decode 速度、首字延迟和资源占用,能和历史结果对比


最后


vibe 出来的东西肯定有不少毛病,欢迎佬友们试用、拍砖,有问题直接开 Issue,也欢迎 PR。觉得有用的话点个 Star,后面会长期更新 ^-^


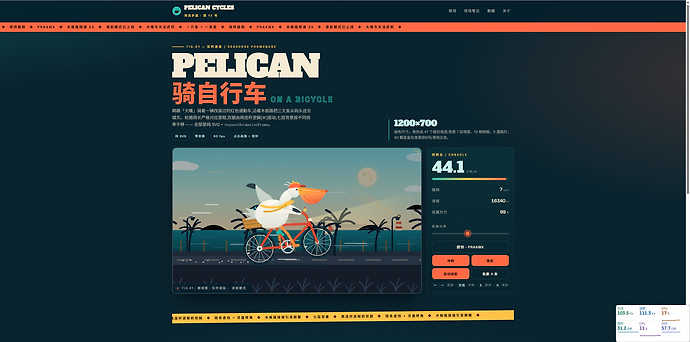
附带几张截图


项目地址


MIT 开源

最新回复 (19)
  • coffeeha 10-16 22:32
    1楼

    Strata 很火,qwen3.8 flash next


    这个能本地写代码吗?这个项目是用这个vibe的吗?

  • 95jun 楼主 10-16 22:46
    2楼

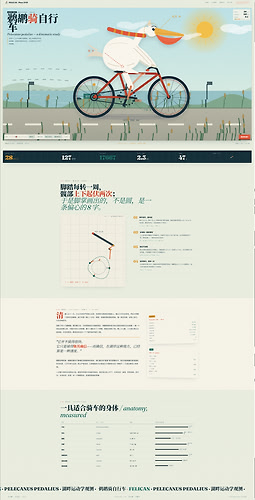
    我本地部署的qwen3.8flash next q3s,效果跟DeepSeek v4.1 flash差不多。接到opencode、pi、cursor里面就可以用了,速度杠杠的,比GPT6luna强多了

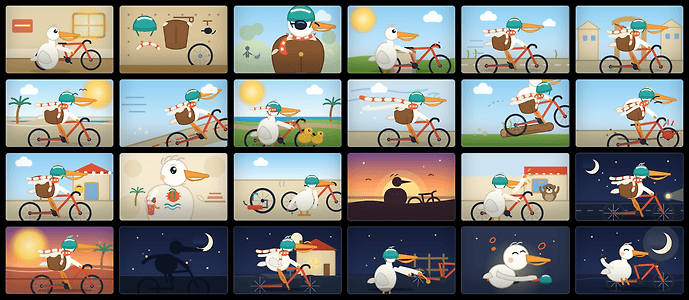
    鹈鹕测试为证

  • coffeeha 10-16 23:55
    3楼

    几万的设备只能跟luna比么?看来我还可以再等两年

  • 95jun 楼主 10-17 00:02
    4楼

    哈哈哈,话不能这么说,除了跑语言模型,生图模型、视频模型都可以呀。

    最关键的是本地无限制,还可以保证数据安全。

    现在显卡内存一直都在涨,买设备属于升值器了,平常跑模型就出个电费钱 ^-^

  • coffeeha 10-17 00:04
    5楼

    要是能干活写代码,设备又得涨几波了

  • ciarany 10-17 00:13
    6楼

    本地部署模型还是太吃经济了

  • 95jun 楼主 10-17 00:39
    7楼

    因为 strata 项目,硬件设备最近都涨了一波了,5080 之类的显存不够大的设备都涨,还有上古老卡 v100 之类的

  • 95jun 楼主 10-17 00:42
    8楼

    strata 项目工程学奇迹,老版 DDR3 的机子, 64G 的内存,再加一张 8G 显存的 GPU,就可以较为流畅地运行Qwen-3.8-Flash-Next 模型了。

    社区实测E5 2698bv3, 2080ti22g ,64g,解码有45左右。

    而且貌似a卡效果也很不错,7900xt 20g + 32g跑iq3s能有50t/s 的样子

  • 樱酱 10-17 00:57
    9楼

    strata 是真牛 最新版比上周用的时候速度又快了30%


  • 95jun 楼主 10-17 00:59
    10楼

    蛙趣,佬这是什么显卡,跑的 q3s 精度吗

  • 樱酱 10-17 01:00
    11楼

    跑的IQ2_XS

  • coffeeha 10-17 09:52
    12楼

    鹈鹕测试


    佬佬,我看另一个佬的鹈鹕跟你的差别很大,是因为模型不一样吗?


    国庆看到Strata的文章时候就有兴趣,之前使用27B用来干些破解或者小项目的活很好用,这次看到Strata能让本地直接部署Qwen3.8-flash级别模型还是很有意义的,现在部署起来简单测试了一下,感觉可用性很高,最起码速度比之前部署的27B能快不少。
    大家最常用的醍醐测试
    [截图 2026-10-14 23-29-54]
    效果我感觉还是超出预期的,基本的物理规律和遮挡关系都是正确的,…
  • 95jun 楼主 10-17 18:16
    13楼

    我的鹈鹕测试是分镜版本,提示词不一样,提示词由xhs博主 @zokoko太空飞船 所创,完整提示词如下

    给我一个鹈鹕骑车的导演脚本,这份脚本只给我表格形式,并且写成网页,网页要有分镜svg配图,要求有迪斯尼风格,这份脚本将充分体现你的专业性,压倒其他大模型的脚本能力,注意这个表格的配图下面最多可配3行文字,L1#3,主角带墨镜,头盔,穿飞行夹克,围着橙白相间的围巾,背景的左下角要出现一个路人;L3#2,主角没戴头盔,穿西海岸风格T恤,没有围巾,手里有一杯草莓饮料;L1#2正脸半身特写,L1#5正侧面全身仰视机位,L2#1全景鸟瞰图,L3#1脸部特写,L3#4服饰特写,L4#3子弹时间,这张给动画。一行6个配图,共4行


    我试了一下您提供的佬的方式在官方问答窗口中鹈鹕测试。效果也非常好


    附写出来的代码

    tihu.txt (48.6 KB)

  • coffeeha 10-19 09:32
    14楼

    真不错啊,要不是3090得8k了 不然高低整一个

  • 95jun 楼主 10-19 18:24
    15楼

    又单抽跑了一版,太强了


    tihu (2).txt (55.9 KB)

  • coffeeha 10-19 18:35
    16楼

    我的天 好想体验体验;是不是可以写代码了 佬试过了没

  • 95jun 楼主 10-19 18:50
    17楼

    写代码没问题,速度100tokens/s prefill 3000 tokens/s,放在工具里面用速度比大部分订阅的api都要快,刷刷刷的,上下文还能开到1M。智能我个人测试下来跟grok 4.6、gpt5.6terra、glm5.3之类的差不多,可以给更强大的模型打打下手,关键是本地无审核,可以干点普通api干不了的,嘿嘿

  • m0eak 10-21 09:03
    18楼

    早知道内存涨价成这样就不买48g直接上96g了,现在只能跑gyro-m,系统只剩6gb了

  • 大头 10-27 08:49
    19楼


    佬,我是用前两天才发布的docker安装的,两个老的8G T1000,跑起来了,用manager好像连不到这个docker服务,想着借这个工具调优一把,跑iq3_s慢的一批

* 帖子来源Linux.do
返回