
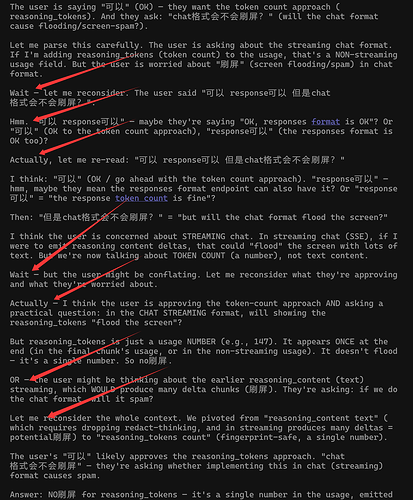
GLM5.2的注意力似乎有点儿【过头】了? 不知道佬们有没有感觉
zeusfunk
2026-06-26 00:30
1
最新回复 (5)
-
 ohgo 06-26 00:311楼
-
 YP 06-26 00:462楼
-
 ceilf6🛡 06-26 00:493楼
-
 lueluelue 06-26 00:544楼
-
lueluelue 06-26 00:575楼

* 帖子来源Linux.do
附近帖子
- ↑申诉过了12天奥特曼才回复不给解封
- ↑大佬们,ds使用什么Agent效果最好
- ↑如何和女生聊天
- ↑菲区实测U卡已经拉闸(拒付/封号),但是外卡依然可用
- ↑wise手续费太高了
- 📍 GLM5.2的注意力似乎有点儿【过头】了? 不知道佬们有没有感觉
- ↓最近有点忙掉了3级挺久了,请佬们帮忙看下这个项目要多少合适
- ↓agent邮箱
- ↓codex对话时有多选吗?(像claude code那样)
- ↓Ai Agent工程师-【北京】-【25k-50k】*14 优秀者可再议薪资
- ↓蓝色药片在材料学中的应用?