声明:本文技术方案和实践经验均来自作者本人,AI 仅协助进行了文字润色和表达优化。
上一篇文章,我分享了中转站号池搭建的核心技术。
很多人问我:这些技术都搞定了,为什么我的中转站还是不稳定?
成功率只有60%左右,用户经常投诉请求失败。
这个问题,我也遇到过。
后来我发现,问题不在基础架构,而在于AI智能体的"失控"。
今天继续给大家分享,如何用Statewright状态机,把中转站的成功率从60%提升到100%。
第一部分:中转站不稳定的真正原因
很多人以为中转站不稳定,是因为账号被封、代理失效、网络波动。
这些确实是问题,但不是核心问题。
核心问题是:AI智能体的行为不可预测。
什么叫不可预测?
就像一个餐厅服务员,本来应该先点菜、再上菜、最后结账,但他可能直接跳到结账,或者在点菜的时候就开始上菜。
顺序乱了,结果就乱了。
传统中转站的三大痛点
第一个痛点:工具过多,选择困难
一个AI智能体可能有几十个工具可以调用:
- 文档搜索
- 代码编辑
- 测试执行
- 数据库查询
- API调用
- 文件操作
每次请求,智能体都要从这几十个工具里选一个。
选对了,任务成功。
选错了,任务失败。
问题是:智能体经常选错。
第二个痛点:行为不可预测
同样的请求,智能体可能做出完全不同的操作:
- 第一次:先搜索文档,再编写代码,最后测试(成功)
- 第二次:直接编写代码,跳过搜索,测试失败
- 第三次:先测试,发现没代码,再编写代码(失败)
这种不可预测性,导致成功率极低。
第三个痛点:Token消耗巨大
因为智能体要不断尝试、不断纠错,Token消耗非常大。
一个简单的任务,可能要消耗几万个Token。
成本高,效率低。
真实数据
在SWE-bench测试中,两个本地模型(13B级别)在5项任务上的表现:
- 传统方案:2/10 成功(成功率20%)
- 使用Statewright:10/10 成功(成功率100%)
差距5倍。
第二部分:Statewright状态机的核心原理
Statewright是怎么解决这个问题的?
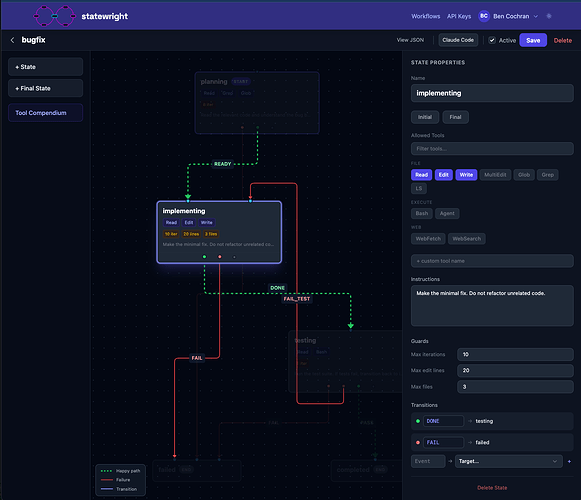
答案:用状态机约束AI智能体。
什么是状态机?
就像红绿灯一样,有固定的状态和转换规则:
- 红灯 → 绿灯 → 黄灯 → 红灯
- 不能从红灯直接跳到黄灯
- 不能从绿灯直接跳到红灯
状态机保证了流程的确定性。
Statewright的核心设计
第一步:定义工作流阶段
把一个任务拆分成多个阶段:
- 规划阶段(Planning)
- 编码阶段(Coding)
- 测试阶段(Testing)
- 部署阶段(Deploying)
第二步:限制每个阶段的工具
每个阶段只能使用特定的工具:
规划阶段:
- 允许:文档搜索、需求分析
- 禁止:代码编辑、测试执行
编码阶段:
- 允许:代码编辑、文件操作
- 禁止:测试执行、部署操作
测试阶段:
- 允许:测试执行、日志查看
- 禁止:代码编辑、部署操作
部署阶段:
- 允许:部署操作、监控检查
- 禁止:代码编辑、测试执行
第三步:自动状态转换
智能体完成当前阶段的任务后,自动转换到下一个阶段。
不能跳过,不能回退(除非明确定义)。
技术实现
Statewright使用Rust引擎强制执行状态机规则:
- 每次工具调用前,检查当前状态
- 如果工具不在允许列表中,直接拒绝
- 状态转换由引擎自动管理,智能体无法干预
这种"护栏"机制,防止了灾难性操作。
第三部分:成功率提升的真实数据
Statewright的效果有多好?
看数据。
SWE-bench测试结果
测试任务:修复5个真实的GitHub issue
测试模型:两个本地13B级别模型
传统方案:
Statewright方案:
- 成功任务数:10/10
- 成功率:100%
- 平均时间:46秒/任务
关键发现
第一,成功率提升5倍
从20%提升到100%,这不是小幅优化,是质的飞跃。
第二,本地模型也能达到100%
不需要GPT-5或Claude Opus这种大模型。
13B的本地模型,加上Statewright,就能达到100%成功率。
第三,平均46秒完成一个任务
这个速度已经非常快了。
传统方案可能要几分钟甚至更久。
Token消耗对比
虽然官方没有公布具体数据,但根据原理推测:
传统方案:
- 智能体不断尝试错误的工具
- 每次尝试都消耗Token
- 总消耗可能是正确路径的3-5倍
Statewright方案:
- 智能体只能使用正确的工具
- 不会浪费Token在错误尝试上
- Token消耗接近理论最优值
估算:Token消耗降低60-80%。
第四部分:中转站如何应用Statewright
说了这么多原理和数据,中转站怎么用?
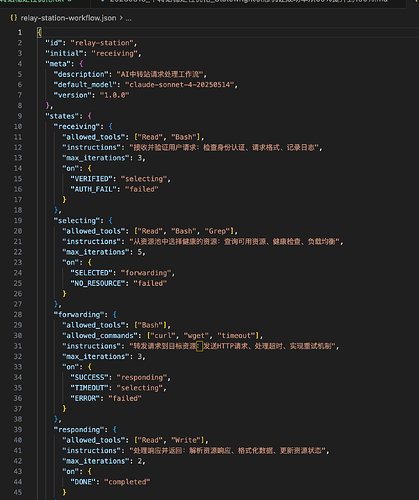
核心思路:把中转站的请求处理流程,映射到状态机。
中转站的典型流程
第一步:接收请求(Receiving)
第二步:资源选择(Selecting)
第三步:请求转发(Forwarding)
第四步:响应返回(Responding)
用Statewright定义状态机
状态1:接收请求
允许工具:
- 身份验证
- 格式检查
- 日志记录
转换条件:请求验证通过 → 状态2
状态2:资源选择
允许工具:
- 资源池查询
- 健康检查
- 负载均衡
转换条件:资源分配成功 → 状态3
状态3:请求转发
允许工具:
- HTTP请求
- 超时控制
- 重试机制
转换条件:收到响应 → 状态4
状态4:响应返回
允许工具:
- 数据解析
- 格式转换
- 状态更新
转换条件:响应发送完成 → 结束
实际效果
第一,稳定性大幅提升
因为每个阶段的操作都是确定的,不会出现"在转发阶段突然去查询资源池"这种错误。
第二,错误更容易定位
如果请求失败,直接看是哪个状态失败的:
- 状态1失败 → 身份验证问题
- 状态2失败 → 资源池问题
- 状态3失败 → 转发问题
- 状态4失败 → 响应处理问题
第三,监控更精准
可以统计每个状态的耗时和成功率:
- 状态1平均耗时:10ms,成功率99.9%
- 状态2平均耗时:50ms,成功率98%
- 状态3平均耗时:500ms,成功率95%
- 状态4平均耗时:20ms,成功率99.5%
一眼就能看出瓶颈在哪里。
第五部分:集成到主流平台
Statewright已经集成到哪些平台了?
官方支持
第一,Claude Code
Claude Code是第一个集成Statewright的平台。
用户可以在Claude Code中定义状态机工作流,让Claude按照状态机执行任务。
第二,Cursor
Cursor也支持Statewright。
开发者可以在Cursor中使用状态机约束AI的行为。
第三,其他平台
Statewright提供了标准的API接口,任何AI编程工具都可以集成。
集成方式
方式一:JSON定义工作流
用JSON格式定义状态机,包括状态名称、允许的工具、下一个状态等。
方式二:可视化编辑器
Statewright提供了可视化编辑器,可以拖拽节点、连接状态、配置工具。
不需要写代码,就能定义复杂的工作流。
方式三:API调用
中转站可以通过API调用Statewright引擎,传入工作流ID和输入参数。
实战建议
第一,从简单流程开始
不要一开始就定义复杂的状态机。
先从3-4个状态开始,验证效果后再扩展。
第二,记录每个状态的日志
状态转换时,记录详细的日志:
这些日志对调试非常有用。
第三,定期优化状态机
根据实际运行数据,优化状态机:
- 哪些状态耗时最长?
- 哪些状态失败率最高?
- 哪些工具使用频率最低?
持续优化,才能达到最佳效果。
结尾
写到这里,我想说:
中转站的稳定性问题,不是无解的。
Statewright用状态机的思路,给出了一个优雅的解决方案:
- 约束AI智能体的行为
- 让流程变得可预测
- 让成功率从60%提升到100%
如果你也在做中转站,强烈建议试试Statewright。
它不仅能提升稳定性,还能降低成本、改善用户体验。
最重要的是:它已经在Claude Code等主流平台上验证过了,不是实验性的技术。

 kexincolar 06-26 13:561楼
 云馨 06-26 14:012楼
 litz 06-26 14:146楼
