本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
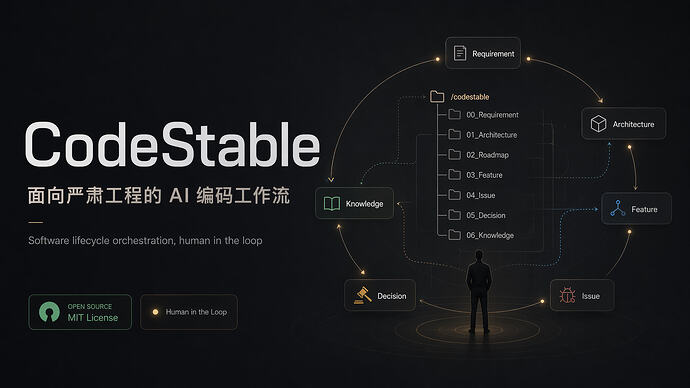
EasySDD 正式改名为 CodeStable
缘起
我在开发一套新的 Harness Agent,一开始当然是 VibeCoding——我只写设计和需求,代码由 AI 来改。这样支撑了大部分特性的开发。直到有一天 Codex 反复解决不了一个我认为比较简单的问题,并且反复在同一个地方犯错。我就知道项目需要一套工作流来维持它继续进行了。
我调研了 OpenSpec、SuperPowers、Oh-My-OpenAgent 这一类工具,没一个用着顺手:
- OpenSpec 太简单,没有复利工程,生成的 Spec 抽象到人类没法读
- SuperPowers 没有流程约束,不知道该用哪个
- Oh-My-OpenAgent 太重,且哲学上认为"人介入 = 失败"
CodeStable 的目标是解决严肃工程的软件实现和编码问题,不是造一个新名词、追求热点。
与其他框架的核心区别:编排的目标是谁
我看了一圈现在主流的 AI 编码框架——Superpowers、CCW、Oh-My-OpenAgent 等等——它们的工作重点是一样的:
如何编排 Agent 。 让它们组队、协作、头脑风暴、跑流水线、自动接力。围绕的实体始终是 Agent。
CodeStable 的思路不同:
编排的是软件本身的生命周期。 围绕的实体是构成软件的要素——每一个需求、每一个架构决定、每一个特性、每一个 bug、每一条历史里留下来的约束。
| Agent 编排 | CodeStable |
|---|
| 核心实体 | Agent / Role / Team | Requirement / Architecture / Feature / Issue / Decision |
| 主线问题 | Agent 之间怎么分工、传递、协调? | 软件的需求、约束、决策怎么被记下来、被检索、被复用? |
| 状态存在哪 | Agent 的 session / 消息总线 / 队列 | 项目里的 codestable/ 文件树(人和 AI 都能读) |
| 解决的痛点 | 单 Agent 能力不够,需要协同放大 | 软件复杂度膨胀撑破上下文、隐知识丢失、需求漂移 |
| 对人的定位 | 人少介入越好,理想是全自动 | 人在环 —— 程序员对整体把控负责,AI 是高效的执行体 |
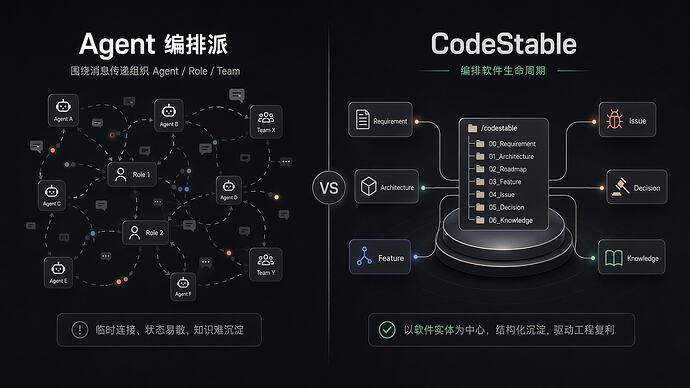
这两个方向没有谁对谁错,甚至可以融合
如果你的任务是"用 AI 跑一个端到端的自动化产线"、“让多个 Agent 互相讨论方案”,Agent 编排显然会更强。
如果你的任务是"维护一个会跨年迭代的严肃软件"、“让今天写下的需求和决策三个月后还能被准确召回”——那以软件要素为中心才是对的。
软件工程的混乱本质上不是 Agent 不够强,而是要素没被组织好。Agent 再强,也写不了一个把需求、架构、历史决策全丢失的项目,因为从逻辑上就不可行。
与trellis 的区别
因为评论区很多人在询问与trellis的区别,所以我特意开一下这个章节说明一下。trellis是站内桃酥大佬的作品,链接在这里: Trellis v0.5.0 beta 版本测试!
这里叠个甲!绝不拉踩!绝不贬低!保持友好!
trellis的目录结构是这样的:
.trellis/

├── spec/                    # Project standards, patterns, and guides

├── tasks/                   # Task PRDs, context files, and status

├── workspace/               # Journals and developer-specific continuity

├── workflow.md              # Shared workflow rules

└── scripts/                 # Utilities that power the workflow
CodeStable的目录结构是这样的:
├── codestable/

│   ├── requirements/                     # 需求实体("为什么要有这个能力")

│   ├── architecture/                     # 架构实体("用什么结构实现")

│   ├── roadmap/                          # 路线图("接下来打算怎么走")

│   ├── features/                         # 特性流程聚合根

│   ├── issues/                           # 问题流程聚合根

│   ├── refactors/                        # 重构流程聚合根(beta)

│   ├── compound/                         # 知识沉淀(复利工程)统一目录

│   ├── tools/                            # 跨工作流共享脚本(onboarding 释放)

│   └── reference/                        # 共享参考文档(onboarding 释放)

│       ├── shared-conventions.md         # 跨技能口径 / 路径命名 / 元数据规范

│       ├── system-overview.md            # CodeStable 体系总览 + 场景路由

└── AGENTS.md                             # 在项目根,不在 codestable/ 里
在我看来,虽然没有实际使用过,但是看README,trellis 依然是偏向于 Agent 编排的框架,虽然它也有Spec,所以根本区别上还是编排的目标的区别。如果我表述上还是不容易听懂的话,大家可以理解为CodeStable把所谓的Spec打得更细一点,更符合开发实践。
还是强调一点,每个人的作品都有倾向性,都有权衡,都有适用的场景!如果各位有自己的测试集也欢迎对比一下两个框架的行为差异,欢迎批评!
设计:6 个实体 + 3 个流程
CodeStable 顺着软件编码的真实流程来设计,把软件开发活动建模成 6 个实体 和 3 个流程。
6 个实体
实体 |
英文 |
干什么 |
|---|
需求 |
requirements |
原始用户故事、当时的讨论与权衡。最终的逃生通道——代码烂成一坨屎时,可以摒弃所有代码、让 AI 重新生成 |
架构 |
architecture |
为实现需求,系统的编排层长什么样。文档要尽可能精简、统一,给人读的,不是给 AI 自嗨的 |
路线图 |
roadmap |
“我想要一个权限校验系统”——直接塞 feature AI 接不住,先拆成路线图分步推进 |
特性 |
feature |
实际落地的工程执行过程,人与 AI 共同协作,对 design / 实现 / 验收负责 |
问题 |
issue |
开发完成后的 BUG 单子,AI 和人一同解决 |
知识 |
compound |
复利工程的知识库,沉淀踩过的坑、好做法、技术决策 |
3 个流程
流程 |
关键技能链 |
说明 |
|---|
特性引入 |
cs-brainstorm → cs-feat-design → cs-feat-impl → cs-feat-accept |
想清楚 → 综合架构设计 → 逐步编码 → 验收测试。各位程序员怎么顺手怎么来 |
问题修改 |
cs-issue-report → cs-issue-analyze → cs-issue-fix |
跟 AI 说哪里有问题 → 让 AI 分析根因 → 让 AI 定点修复 |
代码重构 |
cs-refactor (beta) |
软件架构腐化不是一蹴而就的。AI 辅助重构,但终归是人在重构——还在迭代中,欢迎赐教 |
技能总览
| 分组 | 技能 | 用途 |
|---|
| 接入 | cs-onboard | 把 CodeStable 接入到一个新仓库 / 已有零散文档的仓库 |
| 需求 & 架构 | cs-req | 整理 / 沉淀原始需求文档 |
cs-arch | 起草或更新 codestable/architecture/ 下的架构文档 |
| 路线图 | cs-roadmap | 把模糊大目标拆成可推进的子任务序列 |
| 讨论入口 | cs-brainstorm | 想法模糊时的统一讨论入口,做分诊:直接 design / 进 feature 写 brainstorm.md / 移交 roadmap |
| 特性流程 | cs-feat | 新特性子流程入口 |
cs-feat-design | 起草 {slug}-design.md 作为后续唯一输入 |
cs-feat-impl | 按 design 的推进顺序写代码 |
cs-feat-accept | 逐层对照 design 核对实现,做完整验收闭环 |
cs-feat-ff | 超轻量通道:不写 design、不分阶段,让 AI 直接做 |
| 问题流程 | cs-issue | 问题修复子流程入口 |
cs-issue-report | 把脑子里的问题落成可复现、可追溯的 report |
cs-issue-analyze | 找根因、评估修复风险、给方案 |
cs-issue-fix | 定点修复 + 验证 + 写 fix-note |
| 重构流程 | cs-refactor | (beta) 重构主流程 |
cs-refactor-ff | (beta) 轻量重构通道 |
| 知识沉淀 | cs-learn | 把踩过的坑 / 好做法沉淀成 learning 文档 |
cs-trick | 把可复用的编程模式 / 库用法整理成处方性参考 |
cs-decide | 把已拍板的技术选型、架构决定、长期约束记成永久文档 |
| 探索 & 文档 | cs-explore | 定向代码探索,把"提问 → 读代码 → 得结论"沉淀成证据 |
cs-guide / cs-libdoc | 对外的开发者指南 / 库参考文档 |
工作流示意
CodeStable 的技能不是一条线性流水,而是分层 + 事件驱动的:
═══════════════════════════════════════════════════════════════════════

 阶段 0 · 接入                                  (只在新项目跑一次)

───────────────────────────────────────────────────────────────────────

   cs-onboard ──▶ 生成 codestable/ 骨架 + 释放 reference/、tools/

═══════════════════════════════════════════════════════════════════════

                              │

                              ▼

═══════════════════════════════════════════════════════════════════════

 第 1 层 · 长效档案("系统现在长什么样",只记现状)

───────────────────────────────────────────────────────────────────────

   cs-req   ──▶ codestable/requirements/{slug}.md

   cs-arch  ──▶ codestable/architecture/ARCHITECTURE.md

                                       └─ {type}-{slug}.md(子系统)

═══════════════════════════════════════════════════════════════════════

                              │

                              ▼

═══════════════════════════════════════════════════════════════════════

 第 2 层 · 规划("接下来打算怎么走",大需求才需要)

───────────────────────────────────────────────────────────────────────

   cs-roadmap ──▶ codestable/roadmap/{slug}/

                  把一个"我想要 X 系统"拆成多个可执行的 feature

                  (小需求可跳过本层,直接进第 3 层)

═══════════════════════════════════════════════════════════════════════

                              │

                              ▼

═══════════════════════════════════════════════════════════════════════

 讨论入口(可选 · 想法模糊时进入,做分诊后路由到下游)

───────────────────────────────────────────────────────────────────────

                          ┌── case 1 已经够清楚 ──▶ cs-feat-design

   cs-brainstorm ────────▶┼── case 2 小需求方向定 ─▶ feature 流(落 brainstorm.md)

                          └── case 3 大需求只有一个词 ─▶ cs-roadmap

═══════════════════════════════════════════════════════════════════════

                              │

                              ▼

═══════════════════════════════════════════════════════════════════════

 第 3 层 · 执行流程(按事件类型选一条进入)

───────────────────────────────────────────────────────────────────────


  ▸ 事件:新增能力                                          ┌──────────┐

       cs-feat-design ──▶ cs-feat-impl ──▶ cs-feat-accept  │ features │

       cs-feat-ff     ──(轻量直通车,跳过 design/accept)─▶  │ /YYYY-…/ │

                                                            └──────────┘


  ▸ 事件:修复缺陷                                          ┌──────────┐

       cs-issue-report ──▶ cs-issue-analyze ──▶ cs-issue-fix│  issues  │

                                                            │ /YYYY-…/ │

                                                            └──────────┘


  ▸ 事件:代码腐化(beta)                                   ┌──────────┐

       cs-refactor / cs-refactor-ff                         │refactors │

                                                            │ /YYYY-…/ │

                                                            └──────────┘

═══════════════════════════════════════════════════════════════════════

                              │

                ▼ 任意阶段觉得"这个值得记下来"都能触发 ▼

═══════════════════════════════════════════════════════════════════════

 横切层 · 知识沉淀(复利工程)

───────────────────────────────────────────────────────────────────────

   cs-learn   ──▶ ┐

   cs-trick   ──▶ ├─▶ codestable/compound/YYYY-MM-DD-{doc_type}-{slug}.md

   cs-decide  ──▶ │     doc_type ∈ { learning, trick, decision, explore }

   cs-explore ──▶ ┘

                   ↑

          下一次 cs-arch / cs-feat-design / cs-issue-analyze

          会回头读 compound/,让经验在新工作里被复用

═══════════════════════════════════════════════════════════════════════
运行时结构
/cs-onboard 跑完后,会在你的项目根下生成一个 codestable/ 目录
你的项目/

├── codestable/

│   ├── requirements/                     # 需求实体("为什么要有这个能力")

│   │   └── {slug}.md                     # 一个能力一份,扁平不分组

│   │

│   ├── architecture/                     # 架构实体("用什么结构实现")

│   │   ├── ARCHITECTURE.md               # 架构总入口 / 索引

│   │   └── {type}-{slug}.md              # 子系统架构 doc(同类 ≥6 份自动收进子目录)

│   │

│   ├── roadmap/                          # 路线图("接下来打算怎么走")

│   │   └── {slug}/

│   │       ├── {slug}-roadmap.md         # 主文档:背景 / 拆解 / 排期

│   │       ├── {slug}-items.yaml         # 机器可读子 feature 清单,acceptance 回写状态

│   │       └── drafts/                   # 可选:草稿 / 调研

│   │

│   ├── features/                         # 特性流程聚合根

│   │   └── YYYY-MM-DD-{slug}/            # 一个 feature 一个目录

│   │       ├── {slug}-brainstorm.md      # 可选(cs-brainstorm 产出)

│   │       ├── {slug}-design.md          # 方案(cs-feat-design)

│   │       ├── {slug}-checklist.yaml     # 推进清单(impl 跑、accept 回写)

│   │       └── {slug}-acceptance.md      # 验收报告(cs-feat-accept)

│   │

│   ├── issues/                           # 问题流程聚合根

│   │   └── YYYY-MM-DD-{slug}/

│   │       ├── {slug}-report.md          # 问题报告

│   │       ├── {slug}-analysis.md        # 根因分析(不显然时才有)

│   │       └── {slug}-fix-note.md        # 修复记录

│   │

│   ├── refactors/                        # 重构流程聚合根(beta)

│   │   └── YYYY-MM-DD-{slug}/

│   │       ├── {slug}-scan.md

│   │       ├── {slug}-refactor-design.md

│   │       ├── {slug}-checklist.yaml

│   │       └── {slug}-apply-notes.md

│   │

│   ├── compound/                         # 知识沉淀(复利工程)统一目录

│   │   └── YYYY-MM-DD-{doc_type}-{slug}.md

│   │       # doc_type ∈ {learning, trick, decision, explore}

│   │

│   ├── tools/                            # 跨工作流共享脚本(onboarding 释放)

│   └── reference/                        # 共享参考文档(onboarding 释放)

│       ├── shared-conventions.md         # 跨技能口径 / 路径命名 / 元数据规范

│       ├── system-overview.md            # CodeStable 体系总览 + 场景路由

│       └── ...

│

└── AGENTS.md                             # 在项目根,不在 codestable/ 里
设计哲学
CodeStable 与 OMO 做的是完全相反的哲学。
- OMO 认为:人只要干预就是失败的信号
- CodeStable 认为:程序员是软件编码中的在环对象——可以对实现层黑盒不了解,但对整体实现必须有所把控,必要时也可深入
软件架构必须要 可演进、可观测、可控制。
【安装】
npx skills add https://github.com/liuzhengdongfortest/CodeStable
按a全选技能,按a全选技能,按a全选技能
【github 链接】

 Eic 04-19 22:151楼
 javalover123888 04-19 22:223楼
 Jianwinn 04-19 22:254楼
 不要向命运妥协 04-19 22:345楼
 paviber 04-19 22:437楼
 Butterl 04-19 22:438楼
 胖阿学 04-19 22:439楼
 duiK 04-19 22:4410楼
 leef 04-19 22:4511楼
 alexs 04-19 22:4713楼
 ZILIN 04-19 22:5114楼
 CyberNova4 04-19 22:5215楼
 windherd 04-19 22:5418楼
 Rikka 04-19 22:5419楼
 Conjurer 04-19 22:5620楼