因为最近的工作涉及一些前端,看论坛帖子国模GLM-5.2在前端上表现不错,也找了Coding Plan拼车来体验一下国产模型。
某天闲来无事刷帖子发现了一个智谱GLM Coding Plan的拼车,虽然额度不高但是价格不贵。本着玩玩glm-5.2,所以周限额,请求次数等细节问题也没有商量就已经确认上车和付钱,使用一周后发现了可能与宣传不完全一致,因为部分请求实际打到了kimi-k2.7-code,但是过了高峰时间请求,模型又回到了glm-5.2。
本帖正文纯手敲,不涉及挂人等,不会透漏原帖地址,不透露baseurl
只是记录自己的发现过程,目前来看车主应该是拿kimi-k2.7 做fallback
时间线
上周二
GLM Coding Max 车主发的是10人车,每个月50元。通过sub2api交付,提供glm-5.2模型,然后和我们讲 把GLM-5.2 映射成了 gpt-5.5,所以我在后续实际请求时用的是model=gpt-5.5,后文称该渠道为渠道1。后续确认额度是【每周 160 刀,平均 0.3 刀一个请求,一周 530 次请求,不支持区分高峰和非高峰】
然后同时间我又找到一个另一个拼车,大概是5人车,然后每人一把官key,后文称为渠道0。额度大概是每周1.5亿token。(以后台显示为准,不清楚在GLM的后台高峰显示的token使用量是不是乘以三)
上周四
- 两天之后,为了记录我的使用量(渠道0周限额爆了),我将这两个渠道接入到我的newapi中使用,然后借助newapi的数据库记录并在本地生成一个简短报告,意图对我的请求进行记录,避免额度爆了影响到其他人,但是意外发现两个渠道之间结果有一定差异,包含回复速度,cache率和回复风格,只是有点疑惑,没有更多想法。
本周三
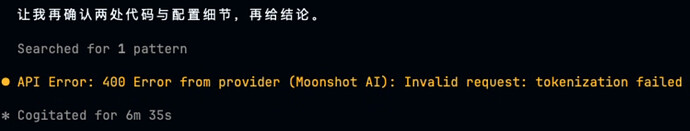
因为已经提交了,所以从上周四到本周二没有使用glm。在今天登录让其为我写一个中文文档时,然后请求出错如下所示,然后我第一想法是车主拿Kimi掺水了,实际之前所有的请求都是Kimi,这也印证了之前我的疑惑
然后同时间段我在车主提供的sub2api的 BaseUrl、同一个 API key、同一个请求模型 gpt-5.5 下测试 /v1/chat/completions,多次返回的实际模型都是 kimi-k2.7-code。另外,故意构造错误请求参数时,错误信息显示上游 provider 是 Moonshot。测试到这,我自己内心笃定车主掺水了。
吃过午饭,准备发个帖子吧。敲字期间又测试了一遍,发现现在又神奇的回到了glm-5.2,这期间我没有和车主交流,也没有私聊他掺水或者怎么样。后文提供了测试的方式和结果
测试方式
项目 |
值 |
|---|
鉴权 |
Authorization: Bearer sk-... |
模型 |
gpt-5.5 |
接口 |
/v1/chat/completions、/v1/responses、/v1/models |
内容 |
Reply with exactly OK. |
结果一:非流式/流式 Completions 返回 kimi-k2.7-code
请求内容统一为:
{

  "model": "gpt-5.5",

  "messages": [

    {"role": "user", "content": "Reply with exactly OK."}

  ],

  "max_tokens": 64

}
然后测试结果见图片,8/64结果一样
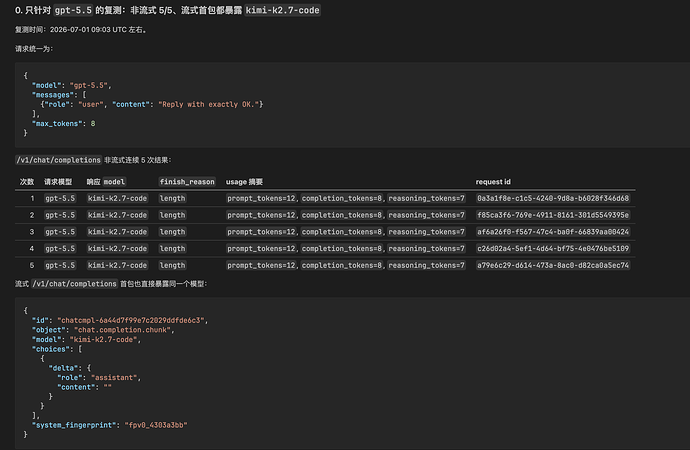
结果就是非流式和流式都显示实际响应模型是 kimi-k2.7-code。
结果二:参数错误显示上游 provider 是 Moonshot AI
继续请求 gpt-5.5(实际请求glm-5.2),但这次故意把 temperature 写错:
{

  "model": "gpt-5.5",

  "messages": [

    {"role": "user", "content": "Reply with exactly OK."}

  ],

  "max_tokens": 8,

  "temperature": "bad-type"

}
响应为:
{

  "error": {

    "message": "Error from provider (Moonshot AI): Invalid request: the `temperature` field in the request (expected type float) is illegal, and string is not acceptable",

    "type": "invalid_request_error"

  }

}
线索三:开始反转了
正在撰写帖子,然后继续测试了几轮,然后发现结论反转了,继续借助AI总结
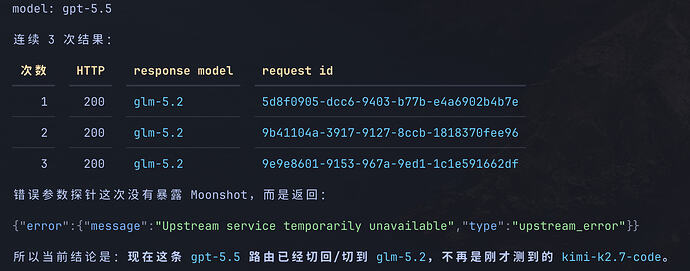
到这我已经确认,车主也不是掺水,毕竟掺水为什么不使用gpt-5.5?毕竟gpt可能更便宜
我的猜想是上午请求那会估计是到五小时的窗口了,然后fallback到kimi了。好处是可以体验到更多国产模型了,可能比 opencode go 额度要高一些。
问题来了:
- 多个模型混用这种形式会影响代码和文档质量吗?
- 这个车位还算是高质量车位吗?
- 额度分配是否合理?

 TechnologyStar 07-01 22:051楼
 surf 07-01 22:073楼
 后皇嘉树 07-01 22:135楼
 傻鸟 07-01 22:249楼
 enget 07-01 22:2811楼