
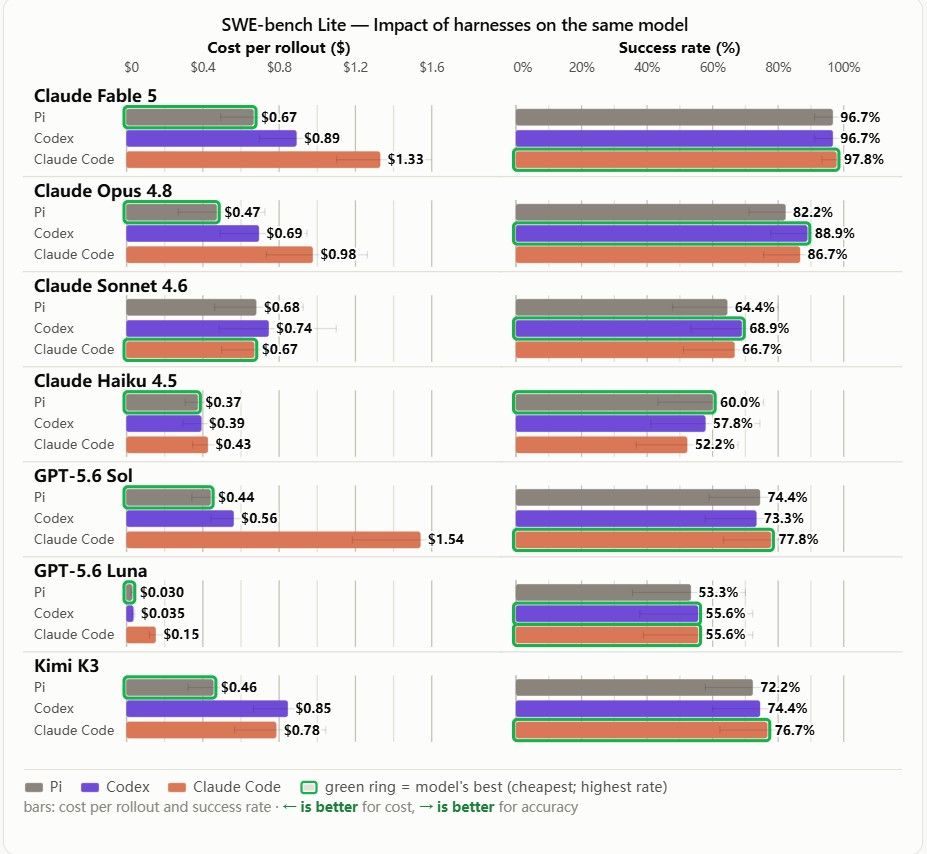
“马鞍税”,一篇非常有意思的 harness 横比文章
sentinelK
2026-09-17 13:16
1
最新回复 (9)
-
 Tink 09-17 14:071楼
-
 longaiwp 09-17 14:192楼
-
sentinelK 楼主 09-17 14:223楼
-
 yh7gdiaYW 09-17 15:324楼
-
yh7gdiaYW 09-17 15:365楼
-
sentinelK 楼主 09-17 15:476楼
-
 keakon 09-17 20:207楼
-
keakon 09-17 20:238楼
-
 greentim 09-18 04:439楼

* 帖子来源V2EX
附近帖子
- ↑求好心人分享个《凡人修仙传》TV 版的阿里云分享链接
- ↑用键盘练英语的开源免费小工具, 打开即用, 无需登录
- ↑请教各位大佬,目前市面上哪个平台以旧换新优惠力度最大。本
- ↑remote remote remote
- ↑UmamiBar - mac 菜单栏查看 Umami 统计数据
- 📍 “马鞍税”,一篇非常有意思的 harness 横比文章
- ↓LUMERUNE 天然水晶首饰|新人 10% OFF 优惠
- ↓executor 的 propose 入口用 LLM 检查自我承诺:这种设计有哪些失效场景?
- ↓CDN3900U/P Ai 模型最低至 4 折 阿里腾讯华为火山国内站 7 折 阿里国际/GCP 可至 65 折 AWS 新号 65 折/老号无需迁移 85 折 腾讯国际 55 折 支持测试效果
- ↓第一届本地优先会议(线上)
- ↓iPhone 18 Pro Max 换电池破 1000 了?何意味?