你好 NVFP4: strata-0.1.44.1, qwen3.8-flash-next, rtx pro 5000 48GB + 64GB RAM, decode 130t/s, prefill2600 t/s

sentinelK 2026-10-14 13:57 1
如题。


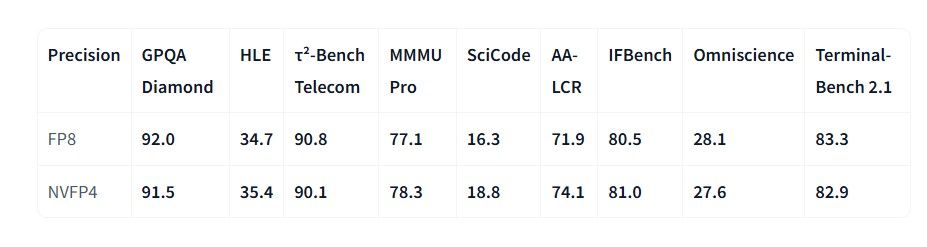
相较于只有ISTA-DASLab 孤立跑分的 IQ3 系列,nvfp4 有英伟达官方站台,所以其能力会更有说服力。
image.jpeg


更何况 nvfp4 并不是全 4bit ,很多参数都保持了全量 bf16 。


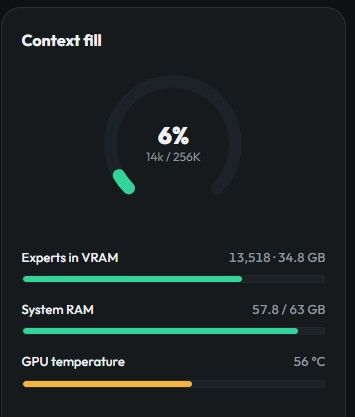
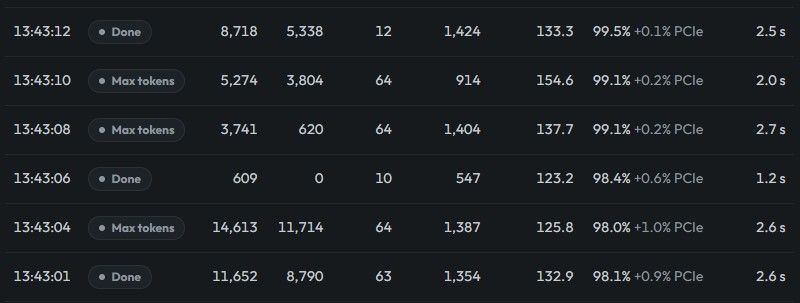
对于 64GB ram + rtx pro 5000 48GB 而言。瓶颈主要是因为专家变大了,导致显存只能放进 13500 个专家,从而专家命中率从 99.7%降低至大概 97.x~99%。
image.jpeg
image.jpeg


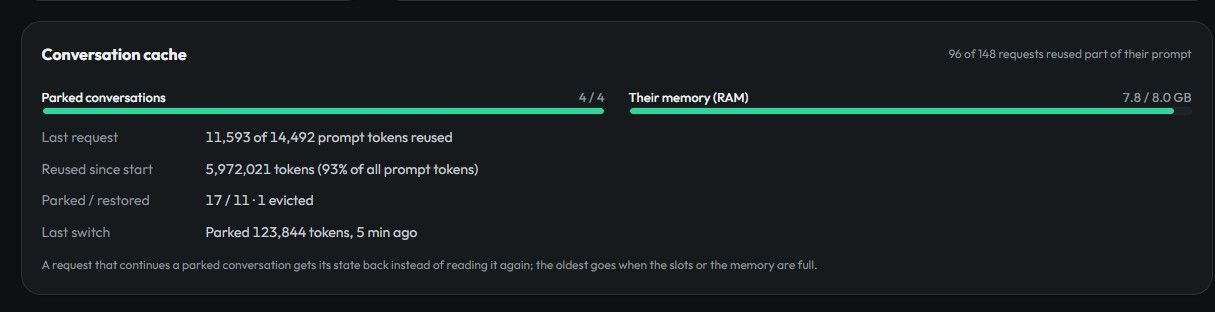
然后就是因为内存的紧张,所以 Conversation cache 只能维系在 8GB ,4slot 。
image.jpeg


其他的配置保持不变。
如惯例,贴出我的配置表:


args": [
"--pack",
"C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\pack",
"--native",
"C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf",
"--native-dense-gguf",
"C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf",
"--ple-gguf",
"C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\ple-fp8.gguf",
"--embd-gguf",
"C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\token-embd-bf16.gguf",
"--expert-profile",
"C:\\work\\Strata\\data\\expert-profile.bin",
"--expert-cache",
"auto",
"--prefill",
"auto",
"--spec",
"4",
"--mtp",
"C:\\work\\Strata-data\\mtp\\rt",
"--max-context",
"262144",
"--kv",
"k8v4",
"--resident-budget-gib",
"39",
"--vision",
"--vram-reserve-mib",
"700",
"--spec-min-p",
"0.5",
"--pool-workers",
"2",
"--conversation-cache-mib",
"8192",
"--conversation-cache-min-tokens",
"20000"
],
最新回复 (3)
  • catazshadow 10-14 18:31
    1楼
    这个跟 IQ3 比会明显更聪明吗
  • flkaylor19 10-15 01:47
    2楼
    @catazshadow 聪明 不循环
  • sentinelK 楼主 10-15 09:02
    3楼
    @catazshadow 如果从跑分角度讲,大概提升 5%,从困惑度角度讲降低 50%。

    实操中,比 IQ3_XXS 更少出现雷霆思考。代价就是对于 48 vram + 64ram 来讲,考虑到会话缓存,nvfp4 还是有点太极限了。
* 帖子来源V2EX
返回