本地部署qwen3.8-27b做代码review

Eic 2026-09-14 18:58 1
因为使用实际代码仓库测试了qwen3.8-27b能力,当时的测试结果是纯代码上比dsv4f差一点,但是整体代码能力比较接近,加上公司有2张5090就起了本地部署的心思,自己主用cc还有codex和ds,用来做子代理感觉没什么必要,就构建了一个本地专门的代码review循环。


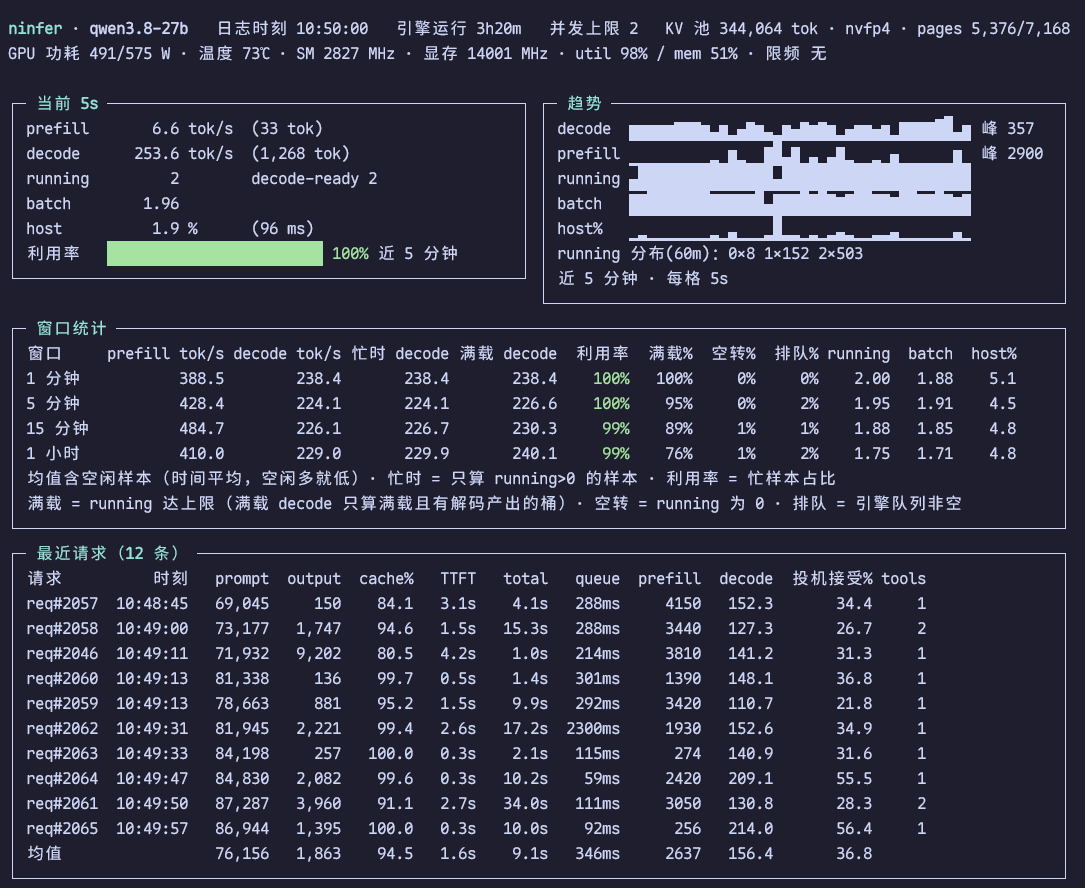
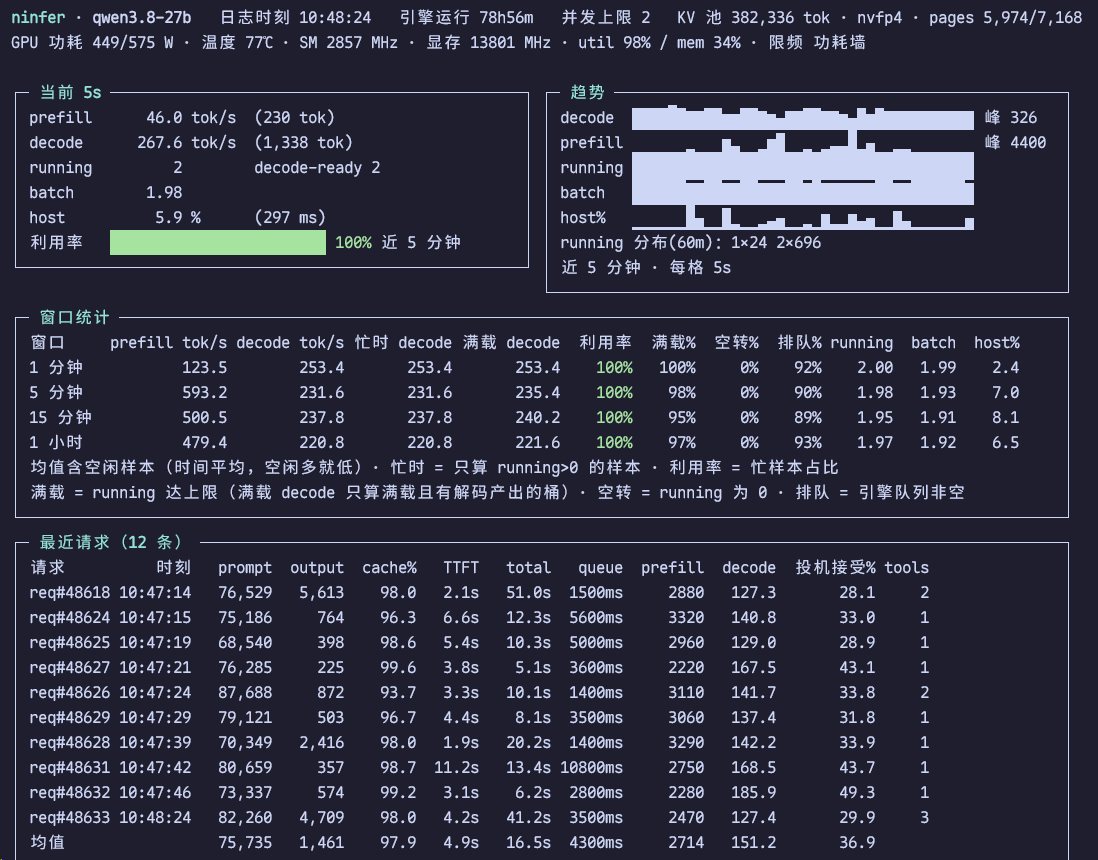
本地部署使用ninfer部署,因为有一张卡在我用的机器上是都是单卡部署,本机用wsl,而ninfer是5090部署最优选择性能超群,nvfp4格式 + nvfp4 kvcache有382K,harness使用的grok(默认会加载cc所有的skill、CLAUDE.md),200k自动压缩,独立部署时开3并发,本机部署因为有windows占用显存开2并发,开高一些并发是因为工具调用、测试这些显卡会闲置,高并发在高上下文时虽然会排队,但是能补上这些工具请求的等待时间,总体能高20%多的decode输出

ubuntu部署:


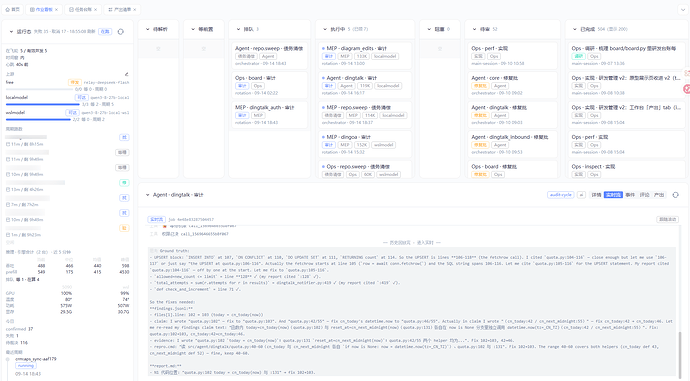
wsl部署:


整体设计:

整个工作流是 find - verify - fix - review

find:调度者自动选择本地某个代码仓库的指定代码文件,指定N个方向,每轮只针对一个方向做深挖,连续3轮次没找出任何问题进入证伪阶段。设置10h上限

verify:每个find做证伪,不成立拒掉

fix:27b自己做修复,开独立分支,daemon自己创建,只能在指定分支和目录写文件

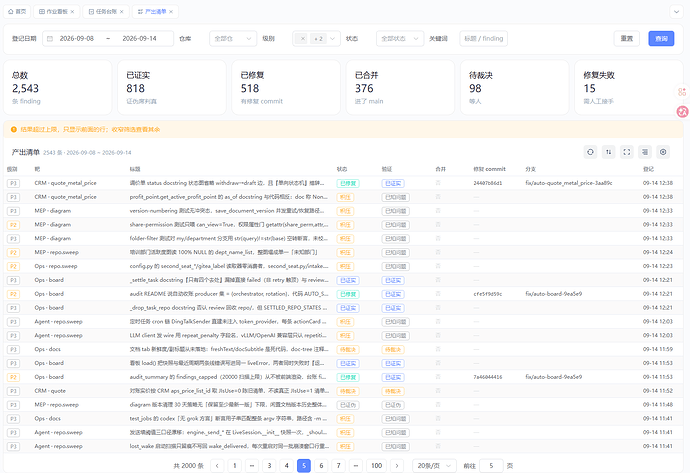
review:针对fix做完整的review闭环,review时发现问题修复后继续起一轮新的review,直到没有找到问题,不设轮次上限


最后的产出统一通过opus5做完整review再合并,简单文档漂移就直接合并;

除此之外一些不着急的任务也会以任务卡方式发给27b做,也是执行 - review闭环方式


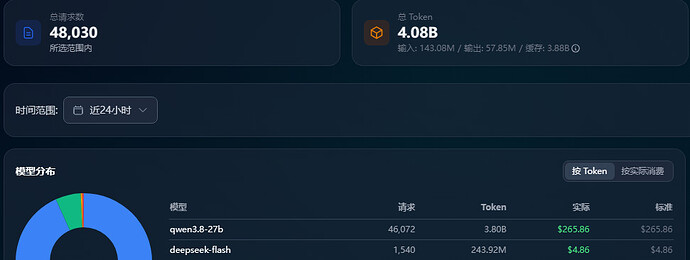
效果:


双卡5090每天本地模型能跑40亿token,我自己用电脑的话会少一些


推荐有部署能力的尝试,3.8-27b能力挺不错的

最新回复 (5)
  • awz707 09-14 19:12
    1

    对吧,我觉得这个模型是本地部署的性价比首选之一,真的比想象中好用

  • vincent_xin 09-14 19:16
    2

    甚至更进一步,可以蒸馏一些数据对本地部署的27B模型进行SFT,这样理论上可以达到更佳的效果

  • lu2905363 09-14 19:18
    3

    学会了,现在哪里去领双卡5090? ^-^ 不需要免费,给个首发价都行

  • yeyucca 09-14 19:29
    4

    可以,回去研究下,这个确实不错

  • Grogu 09-14 20:14
    5

    干货 ^-^,感觉可以搞起来,研究一下

* 帖子来源Linux.do
返回