浅谈自己Agent的记忆方案

needingcen 2026-09-14 22:41 1
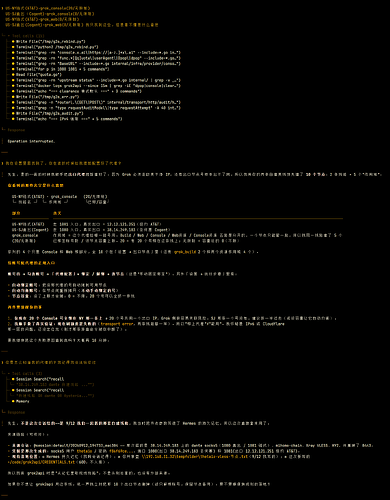
我正在配置 Grok2api


把仓库连接发给了我的Hermers,然后让他帮我配置


结果发现:hermes自己帮我把出网的代理给自动配置了


如图:


我使用的配置是 Gbrain + Hermes + deepseek v4 flash( embedding 模型调用的是 GLM 的资源包,19.9 能跑 50M 的向量化,非常耐用)


平时使用hermes非常高频,经常会吃到这种莫名其妙的小复利


记忆方面,我采用项目记忆分块化存储


Hermes 本身有自己的记忆文件 Memory.md


我平时高频操作的几个项目无非就是几个甲方客户的运维,还有我自己的中转站,还有些搞七捻三的自建服务:例如我的自己些的邮件系统之类的


我将这种高频交互的项目利用Hermes的Self-improvement 机制,把他们中间最高频调用的细节做成了skill,例如些架构设计方案,相关登录密钥等等信息


在长期存储这块,选择的方案是 Gbrain ,它会需要调用到embedding模型,于是我先是在我自己的4060上跑embedding 模型,但是后面了解到 Gbrain 有更深的做梦机制,运行embedding 的机器 24h 最好开机,索性我就花了 19.9 在 GLM 买了资源包,一劳永逸了


Agent记忆的持久化配置其实感觉像是个复利工程,越用越舒服,各位佬友觉得呢?

最新回复 (9)
  • lalalalalacp 09-14 22:49
    1

    佬,请教下,hermes 的 self improvement 机制是怎么样的?需要额外配置的吗?

  • 筱思 09-14 23:13
    2

    它这个self improvement应该是它内置的一个功能吧,不需要额外配置。就是在不断的对话中总结经验,然后形成一个skill并自动启用,然后后续对话就可能用到这个skill,也可以在不断的对话中来优化这个skill。

  • zahuo 09-14 23:26
    3

    我把记忆自更新和skill自更新都关掉了。我算高频使用hermes,这套机制只能说想法很好但效果一般。


    首先这个记忆自更新,什么垃圾都会往里面扔。而且几个设定文件内容经常放错地方,比如有些要放user的放到agents的情况。


    所以。现在我都是把自更新记忆改成审批制,隔段时间就整理一下,你就能发现真是什么屎都想往里面装啊。

  • needingcen 楼主 09-14 23:28
    4

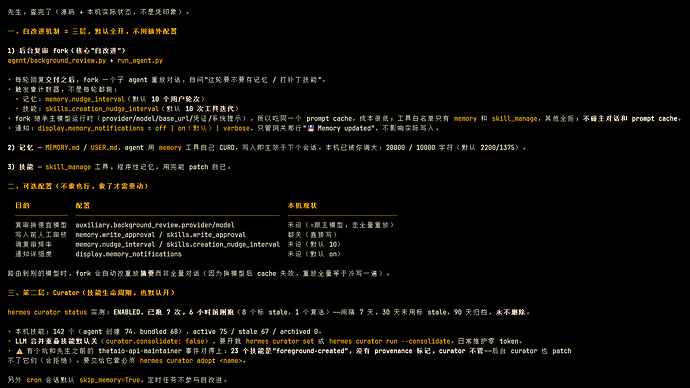
    简单调用hermes读了下自己的文档


  • 筱思 09-14 23:37
    5

    我记得它默认不是只有两个记忆文件吗?一个Memory.md,一个User.md。然后这两个文件,一个负责用户画像,另一个负责比较通用的记忆。而且都有字符上限。这个感觉还好, Skill确实是容易生成很多Skill。但是它是动态加载的,感觉还行。

  • jczhl 09-14 23:39
    6

    加个向量知识库 所有的记忆存进去 。。 用的时候拿出来使用

  • wK36FK 09-14 23:42
    7

    Gbrain


    佬,我用的 vectorize-io/hindsight

    我对Agent记忆这一块很感兴趣,hindsight已经使用了好几个月了

    接下来我将严肃研究一下Gbrain

  • 灿烂甜菜 09-14 23:43
    8

    GLM 的资源包,19.9 能跑 50M 的向量化


    佬这个是在哪买的呀

  • 筱思 09-14 23:46
    9

    感觉这些管理Agent记忆的框架都差不太多。要么就是按文件组织的,用Markdown来存储各种记忆细节。要么就是用Embedding来存储相关的记忆细节,然后需要的时候再检索召回。最多再加个知识图谱。没感觉到有非常新的技术。

* 帖子来源Linux.do
返回