本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
你发给 AI 的,从不止代码:
前几天看到站内的Anthropic 发的Blog,也是有所触动,为什么他们能追踪这么多信息,以及这几天各大企业纷纷限制Claude在企业内敏感项目的访问。
以及爆出来中转站公开兜售用户和AI的聊天。我决定把我们内部使用的智能脱敏网关开源。
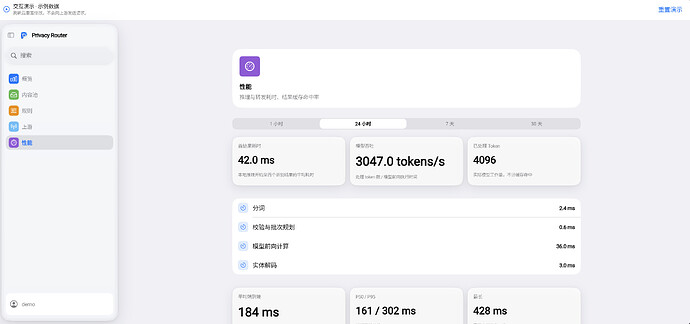
欢迎访问静态 demo 网站体验:
Privacy Router 控制台
Demo 使用样例数据,没有后端,也不会真的发送模型请求。可以先点点内容池、出现记录和规则管理。
项目地址:
GitHub - Inling-AI/privacy-router: Local AI privacy routing: discover sensitive content, review once, enforce registered decisions on future requests. · GitHub
以下是相关报道:
Palantir, Nvidia curb AI model use over data fears — Reuters,Investing.com 转载
(https://www.investing.com/news/stock-market-news/palantir-nvidia-curb-ai-model-use-over-data-fears-the-information-reports-4899995)
Nvidia, Palantir, and others restrict advanced AI model usage over privacy concerns, report claims
(Nvidia, Palantir, and others restrict advanced AI model usage over privacy concerns, report claims — 'paranoia' rising over customer intellectual property | Tom's Hardware)
平时让 AI 帮忙排查问题,经常顺手把日志、配置文件、接口返回贴过去。Agent 用起来以后更省事,它自己读文件、跑命令,但里面夹着什么,我们不可能去一一审查对吧?
一个 API Key、一段数据库连接串,或者客户的邮箱,就这么跟着上下文一起发给了模型供应商,还有众多的中转站,。尤其是 Agent 连续跑任务的时候,总不能每一轮都停下来检查请求。
所以做了 Privacy Router,放在客户端和模型接口之间,在本地识别请求里的敏感内容,再按规则处理。
我比较想解决的是:不用自己从零写一堆规则。之前看到站内也有类似的项目,但都引入了一个问题,我不想自己去制定一大堆规则,然后指望他们能帮我拦住泄漏,这很麻烦而且效果不好
它用的是本地专用识别模型 OpenAI Privacy Filteropenai/privacy-filter · Hugging Face,不是再调用一个大语言模型来检查你的提示词。模型从实际请求里找出敏感内容,汇总到控制台的「内容池」,你来审核它找得对不对。
比如模型发现了一个密钥:
- 点开
出现记录,能看到它在哪些请求里出现过。
- 打开具体请求,可以对照原文和实际转发的内容。
- 确认需要保护,就点
禁止;如果是误报,或者确实需要发送,就放行。
- 审核结果会登记成规则,后续识别到同一个凭据时,就按你的决定处理,不用每次重新审核。
这样规则是随着实际使用慢慢积累的。模型负责找,你负责决定。
具体能过滤什么?
目前支持 13 类敏感内容,由本地识别模型和固定格式校验共同识别:
类别 |
内容 |
|---|
密钥与凭据 |
API Key、Token、密码等秘密文本 |
账号编号 |
上下文中的账户号码等 |
银行卡号 |
符合支持的号段、长度及校验条件的卡号 |
身份证号 |
中国大陆 18 位身份证号码,包含校验位检查 |
统一社会信用代码 |
18 位代码 |
姓名 |
上下文中的个人姓名 |
地址 |
上下文中的私人地址 |
邮箱 |
符合邮箱格式的地址 |
电话号码 |
模型识别的电话号码 |
私密链接 |
模型识别出的敏感 URL |
IP 地址 |
公网 IPv4 / IPv6 地址,内网、回环等地址不在默认 IP 过滤范围内 |
MAC 地址 |
冒号或短横线分隔的 MAC 地址 |
私密日期 |
模型识别出的敏感日期;默认没有专门的脱敏规则,可自行配置 |
目前支持 OpenAI Chat Completions、Responses 和 Anthropic Messages 接口。控制台和 SQLite 都放在程序里,不需要另起前端服务或者部署数据库。同一个可执行文件支持 CPU / GPU ,Windows、Linux 使用 Vulkan,macOS使用 Metal。首次启动需要下载模型权重。

 slk 09-16 15:381楼
 Waitingfor 09-16 17:163楼