最近有点痴迷大模型的本地部署

iceberg 2026-09-20 21:45 1

22年初自己组装的电脑,12900k+64G ddr5+3090,当时也算顶配了吧,主要是玩玩游戏,毕竟大模型时代还没到来 ^-^


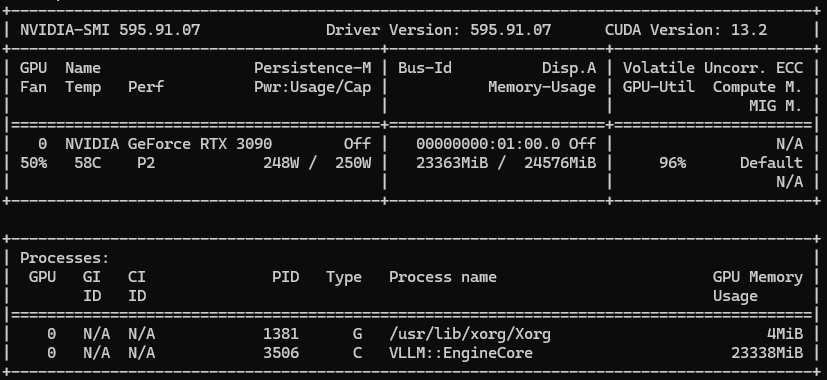
近两年各种量化开源模型层出不穷,各种安装调试,感觉也就是玩玩,不过最近安装了Qwen3.8 27b,接入pi后,感觉速度、智商、上下文都挺能打了,只要不是特别复杂的任务,完成度都不错,最重要的是本地化那种完全由自己掌控的感觉太爽了,而且还有各种Uncensored版本,所以有些蠢蠢欲动,想搞个专门的AI推理机,有没有志同道合的佬友分享分享经验。

最新回复 (14)
  • Zerouscn 09-20 21:50
    1

    其实只是需要一个退烧的过程。不如租个pro6000试试先避免更大损失

  • 996 09-20 21:52
    2

    同3090,佬友可以试试把功耗降到250W,t/s速度只会降10%,对显卡温度、寿命、电费友好 ^-^

  • 时牧 09-20 21:52
    3

    本地部署还得是拿来玩

    开源生图模型和开源视频模型,因为这两个闭源模型审查太严了,不像文字生成那么好绕过

  • vivisitor 09-20 21:55
    4

    这个方向挺好的,我认为未来AI一定是本地部署的,等再过5-10年算力和模型发展到一定地步,必然本地部署的AI就能达到现在最顶级AI的水平,由于隐私和数据安全以及你说的Uncensored的原因,本地部署必然是主流。

    风险就是不知道这个能力哪天能到临界点,毕竟领先时代半步是先驱,领先时代三步就成了烈士。

  • sse 09-20 22:02
    5

    本地部署是真实的需求,但现在的问题还是显存的产能跟不上,也许过几年会改善吧

  • leioukupo 09-20 22:08
    6

    我也是3090玩ai

    不过内存只有16g d5,买不起内存

  • leioukupo 09-20 22:11
    7

    我限制的是300w,咋样?温度我看最多80度,因为我是开放式机箱

    电是公司的

  • Neo-Isshin 09-20 22:14
    8

    在等10月的M5Ultra 512G

    一想到到时候我就能自己做LoRA,跑MinimaxH3

    就兴奋的不行。嘿嘿嘿

  • 996 09-20 22:23
    9

    你确定80度吗……我跑起来峰值最多到58度(长时间运行,我这现在天气还算凉快,机箱里风扇挺多的)


    另外我没测试过300W,我测过150W 200W 250W 350W,能效比最高的就是250W


  • iceberg 楼主 09-20 22:35
    10

    谢谢佬友建议,之前没关注过功耗,一直默认设置,也没敢长时间跑过,怕显卡吃不消

  • 996 09-20 22:36
    11

    锁250W功耗随便你折腾,温度低,放在机箱不动他一般坏不了,算力大概降10%,我感觉划得来。温度高了才容易烧坏或者电路老化

  • iceberg 楼主 09-20 22:36
    12

    生图模型硬件要求低点,视频模型太吃硬件了,而且巨慢

  • iceberg 楼主 09-20 22:40
    13

    是的,感觉未来需求很旺盛,如果产能跟不上,硬件价格的下调还是遥遥无期

  • iceberg 楼主 09-20 22:42
    14

    512G得多少钱啊佬不敢想 ^-^ 还有非cuda环境做LoRA,跑视频效果好吗

* 帖子来源Linux.do
返回