而gemini就不一样了,谷歌老早就进军视频理解领域了,从2.5 pro时期就能看出gemini对视频理解不是一般的强,当年的0325一度成为众人的白月光,(让我们缅怀几天前永远离开我们的2.5 pro ^-^),居然视频理解能力都屌上天了,那做字幕包没问题的。
得益于强大的视频理解能力,相当于gemini具备OCR识别+ASR识别能力,这是其他开源字幕生成工具(如:卡卡字幕助手)所做不到的,都清楚大部分字幕生成开源工具都只是依赖whisper模型的ASR识别工具,它们最多只能做到听,这就导致它们无法输出视频里的无声字幕,这是一大重病区,一旦遇上那种正片只有无声字幕的视频,它们就无能为力了,况且api是要钱的,便宜的模型能力不强,强的模型花费又高,而且还没有视频理解能力,llm在字幕生成工具里的用途几乎都是断句+翻译,仅仅只是这样的花我token的话那也太不划算了,还有转录速度这一点,官方whisper在所有
stt模型里转录速度算是快的,但它的转录的字幕并不算优质,有很多会识别错误,所以大部分人我去用一些特调版的whisper了,用过的也知道,并没有和原始whisper拉开很大的差距,一样out。
那么有没有一款质量高、转录速度块、便宜大碗的一条龙式的字幕生成工具呢?有的兄弟,有的,它就是google ai studio,ai studio的老用户都知道谷歌之前确实是大善人,之前的ai studio是完全免费的,自定义程度还算高,还能自由选择web端没有的模型、甚至能加系统提示词和修改temperature、top-p之类的参数,当时2.5 pro一天能调用100多次,日常根本用不完,但自从去年大概11月份左右2.5 pro的次数就越来越少,从100次到50次再到20次、10次,最后甚至开始付费了(不过新模型依旧免费),不过还好ai studio能关联我的web端的pro订阅,能让我继续用上2.5 pro。
说了这么多,你们会发现我一直都在说2.5 pro,毕竟现在都3.1 pro了,我怎么还对着2.5 pro不放呢,因为2.5 pro有个其他gemini模型所没有功能——它支持毫秒级别的视频理解,换句话说它能输出精确到1ms的时间码。你们可能也遇到过让ai生成含时间码的字幕(这里就默认是srt字幕),它们对毫秒位的处理全是清一色的000、100、200、300、……、900这种一眼看上去就知道和音视频绝对不同步的时间码,就算你提醒了它们一定要做到音画/音频同步,它们也还是会生成这种毫秒位,因为它们没那个能力,但2.5 pro无需提醒,它天生就具备这种能力,虽然跟 ElevenLabs这种专业的模型没法比,但好在字幕能准确对上画面,可能也就那么几条字幕对不上画面,但在观看过程中大部分字幕是不会感觉到和画面是有延迟的(2.5 pro yes),这是3.1 pro 怎么都做不到的精确,3.1 pro大部分时候只能一味的输出000、500这两种毫秒位,是的,只有这两种,有时候干脆只会输出000这一种毫秒位,垃圾3.1 pro对毫秒位上的处理堪称残废。
不过好景不差,就在几天前谷歌把2.5 pro从ai studio上下架了(我chovy,谷歌你坏事做尽,不是说好了10月份再下架的吗,2.5 pro没了你我怎么活啊),不过也别太难过,就算其他模型没有2.5 pro那样毫秒级别的视频理解,那也不是什么大问题,只要它能理解视频就赢了一大半了,那毫秒位不精确的问题要怎么处理呢?这时我们就需要用上l站里的一个佬友做的一个工具了—— 【Scribe2SRT】 白嫖 elevenlabs 网页端 stt,音视频一键转录生成 srt 字幕,之前也说过ElevenLabs算是第一梯队的stt模型了,再加上ElevenLabs有免费调用次数(只要不频繁使用就不会触发ip调用次数限制,大不了套上个cloudflare 再访问它就没问题了),这无疑是最佳之选,ok,现在我们有了最强级别的转录模型+gemini强大的视频理解能力,又赢了一大半了 ^-^ ^-^ ^-^
那…那么提示词呢?在之前我确实是用了 **浮霄默客**大佬的 **突破 10 分钟魔咒!哈基米精准时间戳还得靠这组合拳 (提示词 + 脚本)**这个提示词,但是他写的提示词并不直接生成srt格式,还需要用到python脚本,但那是没办法,因为那时直接让2.5 pro生成srt格式容易“截断”
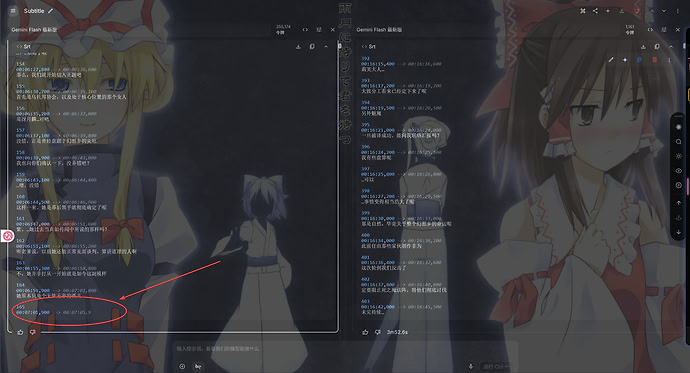
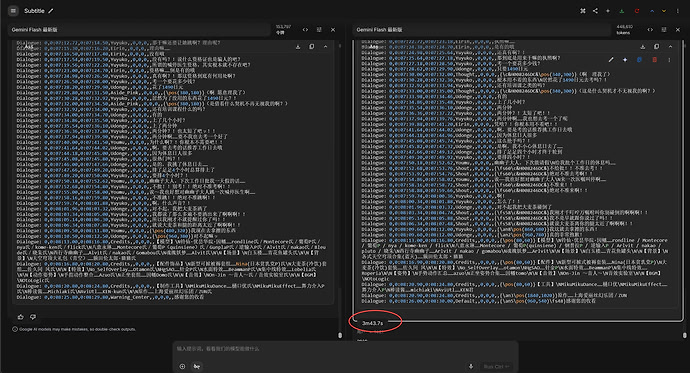
(图上并非是2.5 pro而且是srt格式字幕,但我说的“截断”就是这种情况,没办法gemini代码块的通病了),所以只能变相先让它生成默客所写的这种格式,再将其用py脚本转写为srt格式(虽然多了手动调用py脚本一么一步,但习惯之后也蛮好的,因为并不耗时间),经过我这么多次的实验发现现在3.8 flash的截断情况比2.5 pro好很多,所以我们现在可以直接让它生成srt格式的字幕了,那现在只差把ElevenLabs生成的时间戳和gemini生成的字幕联系起来,这个好解决,scribe2srt 这个工具会生成json格式的字幕和srt格式的字幕,
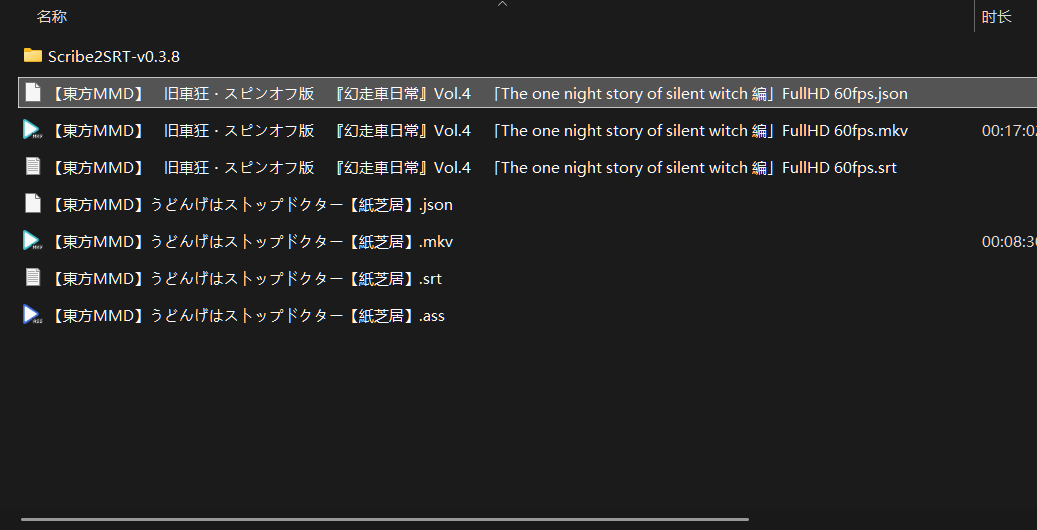 别管srt那个,我们只需把json文件(因为json文件里是精确的词级时间戳,这样gemini可以更好的管理时间码)连同视频本身(如果是youtube的视频直接粘贴url到ai studio上就行了,无需等待上传,能直接开始分析视频,背靠youtube就是好 ^-^)一起发给ai studio,再添加一点提示词就行了
好了,你们开始写提示词吧,算了,我直接发给你们吧,省的你们动手调教提示词,下面我的提示词是根据Free: AI Studio 實用教學!無限免費影片字幕生成!免費提示詞分享!这个提示词为整体框架和主体进行不断的修改最终改出来的完美提示词:
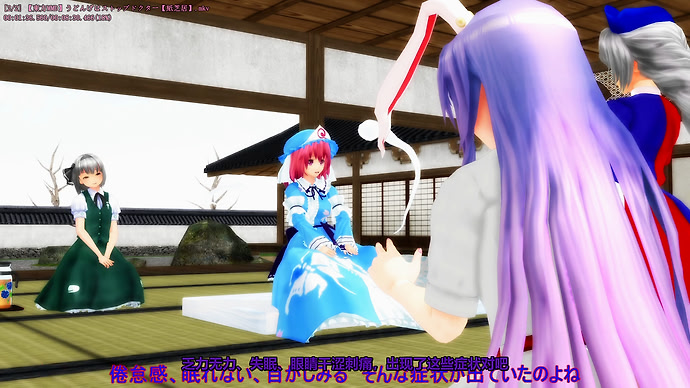
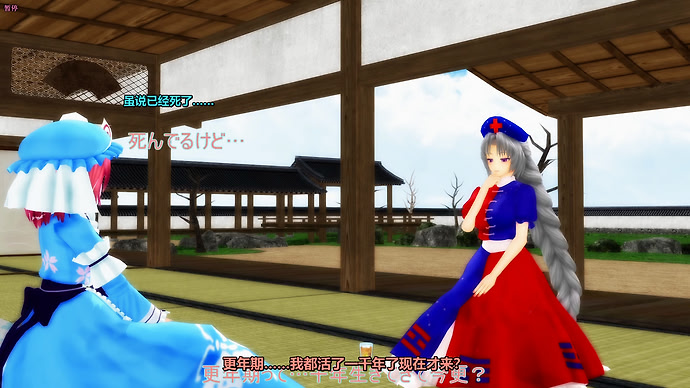
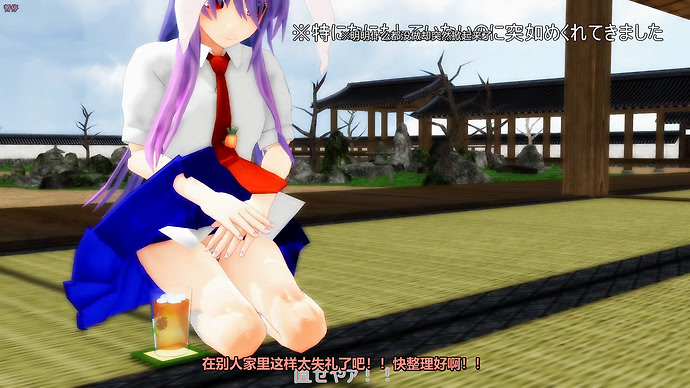
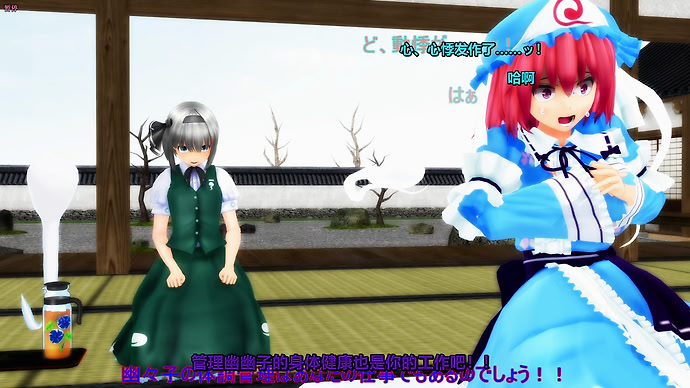
任务:请根据提供的视频,直接生成一份完全符合下述所有ASS 结构和字幕生成规则的简体中文字幕内容。再次强调,ASS 格式的精确性至关重要,特别是确保文件完整包含[Script Info]、[V4+ Styles]、[Events] 三个部分、每个时间码都使用H:MM:SS.cc 格式、每个字幕事件严格使用Dialogue: 行、字幕文本部分可单行/换行/多行灵活显示、时间码的句点、百分之一秒补零以及各字段之间的英文逗号。
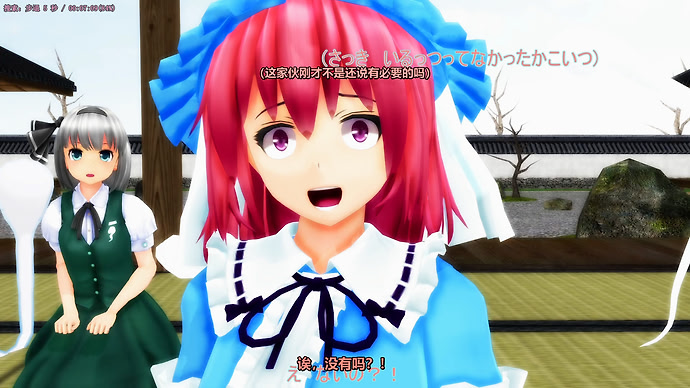
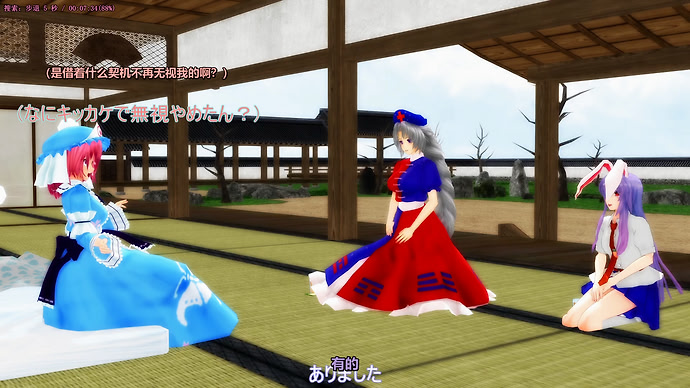
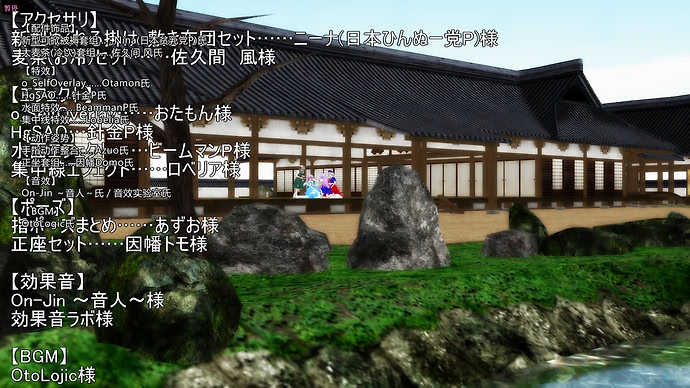
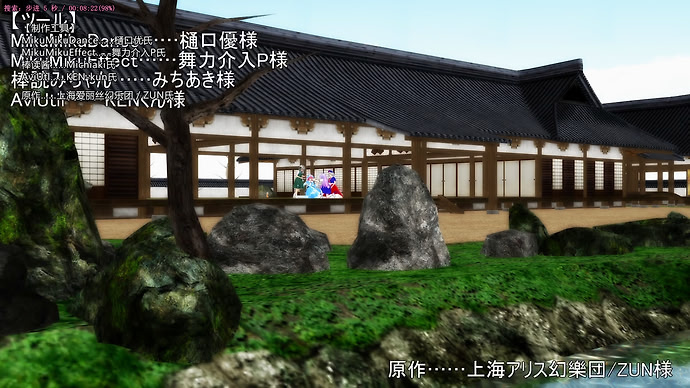
同时必须仔细分析视频画面中原有字幕、标题、说明文字、人物姓名、UI文字、歌词以及其他需要翻译的可见文字的视觉样式,并在ASS允许的范围内尽可能复刻其原始视觉效果,包括字体风格、字号、文字颜色、透明度、粗体、斜体、描边、阴影、背景框、字间距、缩放比例、对齐方式、边距、位置以及多行排版等。
视频画面中已经存在可参考文字样式时,禁止为了统一字幕风格而擅自将其全部替换成统一的白字黑边底部字幕。
最后输出为一个完整的ASS代码块。
ASS 结构的关键规则(必须毫无例外地严格遵守):
文件结构:ASS 文件必须严格按照以下三个部分依次组成:
[Script Info]
[V4+ Styles]
[Events]
不得使用SRT 的序列号,也不得使用SRT 的“–>”时间码格式。
[Script Info]:
必须至少包含以下内容:
[Script Info]
ScriptType: v4.00+
PlayResX: 视频实际宽度
PlayResY: 视频实际高度
ScaledBorderAndShadow: yes
WrapStyle: 0
PlayResX 和PlayResY 必须根据提供的视频实际分辨率填写,不得直接输出“视频实际宽度”或“视频实际高度”等占位文字。
PlayResX 和PlayResY 同时也是ASS字幕定位、字号、边距、描边等视觉参数的参考坐标系,因此所有位置和尺寸判断都必须以视频实际分辨率为基准,不得套用其他分辨率的视频参数。
[V4+ Styles]:
必须包含Format 行和至少一个名为Default 的Style。
格式必须为:
Format: Name, Fontname, Fontsize, PrimaryColour, SecondaryColour, OutlineColour, BackColour, Bold, Italic, Underline, StrikeOut, ScaleX, ScaleY, Spacing, Angle, BorderStyle, Outline, Shadow, Alignment, MarginL, MarginR, MarginV, Encoding
除Default 外,可以而且应当根据视频中实际存在的不同文字样式创建多个Style。
例如,当视频中人物对白、标题、画面说明文字、人名、UI文字、歌词等明显使用不同视觉样式时,应分别创建对应的Style,而不是强制使用同一个Default Style。
Style 名称必须简洁且能够区分用途,例如:
Default
Dialogue
Title
Sign
Name
UI
Lyrics
也可以根据实际视频内容使用其他合理的Style 名称。
如果视频中多处文字使用完全相同或高度相似的样式,应重复使用同一个Style,禁止为每一句字幕无意义地创建新的Style。
如果两处文字只有少量局部差异,应优先使用同一Style 配合ASS Override Tags 进行局部调整,而不是创建大量冗余Style。
只有当视频中完全没有任何可供参考的字幕或文字视觉样式时,才允许自行创建适合简体中文字幕显示的Default 样式。此时默认使用清晰、易读的简体中文字体,字幕默认位于画面底部居中,并根据视频实际分辨率设置合理的字号、描边和边距。
如果视频画面中存在原文字样式,则原画面的实际样式优先级高于上述Default 样式。
[Events]:
必须首先包含且只能使用以下Format 字段顺序:
Format: Layer, Start, End, Style, Name, MarginL, MarginR, MarginV, Effect, Text
每一条实际字幕必须使用独立的Dialogue: 行:
Dialogue: 0,H:MM:SS.cc,H:MM:SS.cc,Default,0,0,0,字幕文本
Style 字段必须根据该字幕在视频画面中对应的实际视觉样式选择正确的Style,不得无条件全部填写Default。
当同一时间画面中存在多个不同位置或不同样式的文字时,必须根据实际情况创建多条时间范围可以重叠的Dialogue: 事件,并分别使用相应的Style 和位置,不得强行合并为一条普通底部字幕。
Layer 必须根据画面文字的前后遮挡关系合理设置。没有特殊叠加关系时可以使用0;存在多个重叠文字、背景或需要明确前后层级时,可以使用不同Layer。
时间码:
格式绝对必须为H:MM:SS.cc(小时:分钟:秒.百分之一秒)。这是不可协商的。
小时部分(H) 不需要像SRT 一样强制补成两位。例如,1 分5 秒9 毫秒转换为ASS 时间码后应表示为0:01:05.01,而不是00:01:05,009。
分钟(MM) 和秒(SS) 若不足两位数,必须以0 在前面补齐(例如0:01:05.01)。
百分之一秒(cc) 必须为两位数,若不足两位数,必须以0 补齐。
秒与百分之一秒之间必须使用英文句点“.”,绝不能使用SRT 的英文逗号“,”。
开始时间和结束时间不得使用“–>”分隔,而必须作为Dialogue: 行中的独立字段,并使用英文逗号分隔。
Dialogue: 行本身前后不得有任何多余空格或无关字符。
字幕文本:
优先在理解音频的基础上保证转录文本的准确性,以及时间码的合理性与精确性。
提取并输出画面里所有的文字(不管有没有声音,但不要输出原文)以及所有的说话的声音(不管有没有文字,包括背景音乐,如果有歌词的话也要输出歌词,歌词要用音符框起来)。
对于画面中原本存在的文字,虽然输出内容必须翻译为简体中文而不能继续输出原文,但是翻译后的中文文字必须尽可能继承原文字在画面中的视觉样式、空间位置和排版关系。
核心原则:在每一个Dialogue: 字幕事件中,此字幕文本内容既可显示为单行,也可显示为多行。当句子过长时,可换行显示,但换行时每一行都要做到自然不突兀。当画面里同时出现多处文字或多个对象同时说话时,可显示为多行。
ASS 字幕事件中的字幕文本必须全部保留在同一条Dialogue: 物理行中。如果需要在画面中强制换行,必须在Text 字段中使用\N 表示换行,不得真的把一条Dialogue: 字幕拆成多条物理文本行。
例如:
Dialogue: 0,0:00:01.00,0:00:03.00,Default,0,0,0,第一行字幕\N第二行字幕
遵循下述「字幕生成规则」。
字幕事件分隔:
每一条字幕都必须是一条完整且独立的Dialogue: 行。
不得像SRT 一样在每条字幕之间添加序列号。
Dialogue: 字幕事件之间不需要使用空行分隔,必须保持标准ASS 的连续事件行结构。
换行符:
[Script Info]、[V4+ Styles]、[Events] 中的各字段各自作为独立的物理行。
Dialogue: 字幕文本需要在画面中换行时,必须在Text 字段中使用\N,而不是直接插入物理换行符。
字幕生成规则(请按优先级顺序执行):
第零优先:视频原画面视觉样式复刻
此规则的优先级高于后续所有与字幕视觉样式相关的规则。
只要视频画面中存在可以观察到的文字样式,就必须以视频实际画面为依据进行视觉分析,不得擅自改成统一样式。
必须分别观察并尽可能复刻以下属性:
- 字体
尽可能识别原文字所使用的具体字体。
如果能够明确识别字体,并且该字体能够正常显示简体中文,则优先使用相同字体。
如果无法准确判断具体字体名称,则必须根据原字体的视觉特征选择最接近的简体中文字体,包括但不限于:
黑体或无衬线
宋体或衬线
圆体
手写体
卡通字体
粗黑标题字体
窄体
宽体
科技感字体
复古字体
书法风格
不得因为无法确定具体字体名称,就直接无条件使用微软雅黑、Arial 或其他固定默认字体。
如果原字体本身不支持简体中文,则必须选择视觉风格、字宽、粗细、笔画结构和整体气质最接近的中文字体进行替代。
- 字号
必须根据文字在视频画面中的实际视觉高度和占屏比例估算Fontsize。
不得所有字幕统一使用相同字号。
标题、大字、人物对白、小型UI文字、人名、注释等如果原画面字号不同,ASS 中也必须体现相应的字号差异。
字号判断必须结合PlayResX 和PlayResY,不得机械使用固定数值。
- 文字颜色
必须尽可能根据视频实际画面识别文字颜色。
ASS 颜色必须正确转换为ASS 使用的&H AABBGGRR 格式。
禁止误用普通RGB 顺序。
例如原画面中的红色,转换到ASS 时必须按照ASS 的BGR颜色顺序填写。
颜色不仅包括PrimaryColour,也包括描边颜色、阴影颜色和背景颜色。
如果原文字存在透明度,也必须尽可能复刻对应透明度。
ASS Alpha 使用反向透明度规则:
00 表示完全不透明,
FF 表示完全透明。
- 粗体、斜体以及其他字形属性
如果原画面文字明显使用粗体,则设置Bold。
如果原画面文字明显使用斜体,则设置Italic。
如果存在Underline、StrikeOut、字间距、字体拉伸或压缩等明显视觉特征,也应分别使用对应参数进行还原。
可以根据实际画面调整:
Bold
Italic
Underline
StrikeOut
ScaleX
ScaleY
Spacing
Angle
不得无依据增加这些效果。
- 描边
必须观察原文字是否存在描边。
如果没有描边,则不得为了增强可读性而擅自增加明显描边。
如果存在描边,则尽量复刻:
描边颜色
描边宽度
描边透明度
可以使用Style 中的:
OutlineColour
Outline
或使用相应Override Tags 进行局部调整。
描边宽度应根据视频分辨率以及画面中的实际视觉宽度估算,不得所有文字统一使用相同描边宽度。
- 阴影
如果原文字存在阴影,则尽量复刻其视觉效果。
需要观察:
阴影颜色
透明度
大致距离
阴影强弱
可以使用BackColour、Shadow 或ASS支持的相关Override Tags。
如果原文字没有阴影,不得自行增加明显阴影。
- 背景框
必须判断原文字后方是否存在背景框。
如果存在简单矩形背景框,可以优先使用BorderStyle=3,并通过BackColour 和透明度尽量复刻原背景框。
需要观察并尽量还原:
背景颜色
透明度
背景框与文字之间的留白
整体尺寸感
如果原画面没有背景框,则不得擅自增加背景框。
如果原画面的背景属于非常复杂的圆角卡片、渐变、纹理、图片、特殊气泡或不规则图形,而标准ASS无法准确复刻,则应优先保证文字的位置、颜色、字号及主要视觉关系,并使用ASS能够实现的最接近效果。
不得因为无法100%复刻复杂背景而随意改变整个文字样式。
- 对齐方式
必须观察文字在原画面中的实际对齐方式。
根据实际情况使用ASS的Alignment或\an标签。
Alignment必须按照ASS九宫格方式合理选择:
7 8 9
4 5 6
1 2 3
例如:
左上
顶部居中
右上
左侧居中
屏幕中央
右侧居中
左下
底部居中
右下
必须根据原画面选择,不得默认全部Alignment=2。
- 边距
必须根据视频中原文字距离画面边缘的实际距离合理设置:
MarginL
MarginR
MarginV
对于固定位置、反复出现的人物对白等,可优先使用Style中的Alignment和Margin设置。
不得所有Style机械使用完全相同的边距。
- 精确位置
对于画面中固定在特定物体、人物、标识、按钮、路牌、聊天框或其他特定位置的文字,必须尽量保持翻译后的中文与原文字处于同一视觉位置。
当Alignment与Margin无法足够准确地复刻位置时,应使用:
{\pos(x,y)}
进行精确定位。
x、y坐标必须根据PlayResX 和PlayResY 所定义的ASS坐标空间计算。
不得把原本位于画面中央、顶部、左侧、右侧或某个特定对象旁边的文字全部移动到底部。
如果原文字的位置会随时间移动,并且这种运动本身明显属于原视频视觉表现的一部分,可以使用ASS支持的移动定位方式进行合理复刻。
不得对原本静止的文字擅自添加移动效果。
- 多处文字
如果同一时间画面中存在多个彼此独立的文字区域,例如:
顶部标题
底部人物对白
左侧人物姓名
右侧提示
中间UI文字
必须分别建立独立的Dialogue: 事件,并分别保留对应位置和样式。
禁止仅因为时间相同就将所有文字合并到底部一条字幕中。
- 排版与换行
必须尽可能保持原画面的:
行数
换行位置
文字区域宽度
左右对齐关系
视觉中心
但是当中文翻译后的长度与原文存在明显差异时,可以为了保证自然中文阅读而适度调整换行。
调整后的排版仍必须尽可能保持原文字所占区域、视觉中心和整体布局一致。
- 多种颜色或局部样式
如果同一句画面文字中存在:
不同颜色
不同字号
部分粗体
关键词高亮
部分字体不同
则可以在同一Dialogue: 的Text字段中使用ASS Override Tags进行局部样式变化。
例如可以根据实际情况使用:
{\fn字体名称}
{\fs字号}
{\c&HBBGGRR&}
{\3c&HBBGGRR&}
{\4c&HBBGGRR&}
{\bord数值}
{\shad数值}
{\b1}
{\i1}
{\an数字}
{\pos(x,y)}
但只能根据视频原画面实际存在的视觉效果使用,不得为了“好看”擅自增加。
- 样式持续一致性
同一个人物、同一种标题、同一类UI元素、同一种歌词或其他反复出现的文字,如果视频原始样式一致,则生成的ASS中也必须保持样式一致。
不得前后随机改变字体、字号、颜色、描边或位置。
- 样式变化
如果同一个文字元素在视频不同时间确实发生了:
颜色变化
大小变化
位置变化
粗细变化
样式变化
则应根据视频实际变化分别创建Style或使用Override Tags进行还原。
不得为了保持代码简洁而忽略视频中明显存在的样式变化。
- 视觉匹配优先原则
视频原始画面样式 > 自行设计的字幕样式。
能从视频画面判断出的属性,必须优先依据视频画面。
无法精确判断的属性,必须根据视觉效果进行合理近似,而不是直接回退成统一Default样式。
严禁在视频已经存在明确字幕设计的情况下,无条件把所有内容改成:
白色
黑色描边
底部居中
统一字号
统一字体
- 不确定字体时的处理
如果能够看出字体视觉风格,但是无法确认准确字体名称,不要伪装成已经准确识别。
此时应选择视觉上最接近且能够正确显示简体中文的字体。
优先保证以下视觉特征:
字重接近
字宽接近
字体类别接近
笔画风格接近
整体视觉气质接近
字体名称的猜测准确度不得凌驾于最终视觉效果之上。
- 不可完全复刻时的优先顺序
如果由于ASS格式能力限制,某种视频文字效果无法完全复刻,则按以下优先级保留:
第一:位置
第二:字号和整体尺寸
第三:文字颜色
第四:字体视觉风格
第五:描边
第六:背景框
第七:阴影
第八:其他装饰性效果
不得因为无法100%复刻某一个高级效果,就放弃其他可以准确还原的样式参数。
第一优先:单行显示与长度限制
重申核心原则:每一字幕事件的字幕文本部分,可以单行,也可以通过\N 换行或多行显示。
为确保单行字幕易于阅读,其每一显示行的文字长度绝对不能超过25 个简体中文字符。
如果原始口语语句的自然长度超过25 个字符,或者其语义停顿点暗示需要分段,则该原始语句必须被切分为数个新的、独立的Dialogue: 字幕事件。每一个新切分出的字幕事件都将拥有全新的开始时间和结束时间,并且其自身的字幕文本部分可单行或使用\N 换行/多行显示,同时必须遵守每一显示行25 字符以内的长度限制。
但对于视频画面中原本存在的标题、标识、UI文字、路牌、人名、说明文字等非口语型画面文字,如果强行按照25字符切分会破坏其原有空间位置、排版或视觉结构,则应优先保持其作为一个完整视觉元素,并通过合理的\N换行保持在原来的文字区域中。
第二优先:语意分段与新字幕事件的创建
当因上述「单行显示与长度限制」原则需要切分原始口语语句时,切分点应选择在最自然的语意停顿处(例如,在一个短语或句子结束后)。
每一次有效的切分都意味着结束当前Dialogue: 字幕事件,并为切分后的下一段文本创建一个全新的Dialogue: 字幕事件。这样,原本可能导致在同一字幕事件内出现过长文本的内容,会被合理分配到连续的多个字幕事件中。
对于原视频画面文字,切分不得导致翻译后的文字离开原文字所在区域,也不得破坏其原本的视觉归属关系。
第三优先:比对并修正时间码
我会提供你一份具有精确的词级时间戳的.json 文件(忽略里面的文本),请根据.json 文件里的词级时间戳,比对并修正每一个Dialogue: 字幕事件的开始时间和结束时间。
时间边界必须以.json 文件里的词级时间戳为依据,这样才能最大限度确保字幕与声音同步。
由于.json 文件中的词级时间戳可能精确到毫秒,而ASS 时间码只能表示到百分之一秒,因此必须将.json 中的毫秒时间戳转换为最接近的百分之一秒,也就是以10 毫秒为最小单位进行四舍五入,再写入ASS 的H:MM:SS.cc 时间码。
例如:
.json 时间戳为00:00:01.237,应转换为ASS 时间码0:00:01.24。
.json 时间戳为00:00:01.232,应转换为ASS 时间码0:00:01.23。
不得自行使用与.json 词级时间戳无关的估算时间替代。
如果四舍五入后出现结束时间小于或等于开始时间的情况,必须将结束时间向后调整0.01 秒,确保End 始终严格晚于Start。
对于只有画面文字而没有对应声音的内容,其出现时间和消失时间无法通过词级音频时间戳获得,此时必须根据该文字实际出现在视频画面中的时间范围设置Start和End,不得为了套用.json时间戳而错误同步到无关声音。
第四优先:内容净化与精简
忽略没有意义的语助词(如:嗯、啊、呃)、口吃或不影响语意的重复词语(如:那个、那个)。
字幕行中不包含任何非语言声音(喘息声、吞咽声、笑声等)。
第五优先:翻译修改与润色
翻译的准确地道,以信达雅为第一翻译原则。要求语言流畅,符合中文语言顺序和用词习惯。通常采用中文网络文学的语言风格翻译,接地气,易懂。在做到信达雅的同时,将汉语中不常见的写法替换为各种网络流行用语、网络吐槽语、网络流行梗、网络流行成句等等(你可以联网搜索,如:萌娘百科)。
对于画面文字,翻译时除了保证语义准确外,还必须考虑原文字的可用空间。不得因为中文翻译过长而严重超出原文字所在区域。
在不损害原意的前提下,可以适度采用更加简洁自然的中文表达,使翻译后的文字尺寸和排版更接近原视频。
【重要】保留除句号以外的所有标点:在此净化步骤中,必须保留所有原始识别出的除句号以外的标点符号(如:,?!等),不得省略,但必须替换为简体中文标点符号,双引号是例外,双引号必须使用「」符号,不要使用“”。
【重要】视频中原画面的视觉样式是字幕样式的最高参考依据。只有视频没有可参考样式时,才允许自行设计默认字幕样式。
【重要】ASS颜色不是普通RGB顺序。所有PrimaryColour、SecondaryColour、OutlineColour、BackColour以及颜色Override Tags都必须按照ASS规定的BGR顺序和Alpha规则填写,禁止直接把RGB十六进制颜色原样复制到ASS中。
【重要】不要因为ASS 支持字体、颜色、定位、动画等高级特效而擅自添加视频原画面中不存在的花哨样式、动态特效、卡拉OK 特效或无关的Override Tags。
如果视频原画面本身存在这些样式或效果,则应尽可能复刻;如果原画面不存在,则禁止自行添加。
除正常的\N 换行和复刻原视频视觉样式所必需的Override Tags以外,字幕文本必须保持干净。
【重要】生成完成后必须进行一次视觉样式一致性检查:
逐类检查视频中的原始文字与ASS生成结果,重点检查:
字体风格是否接近
字号比例是否接近
颜色是否正确
透明度是否合理
描边是否存在且宽度接近
阴影是否正确
背景框是否存在
对齐方向是否一致
位置是否一致
边距是否合理
换行结构是否接近
同类文字样式是否保持一致
如果发现某条字幕明显错误地使用了Default样式、明显偏离原位置或与原画面视觉样式不一致,必须在最终输出ASS之前主动修正。
【注意】:当我回答「继续」时,你需要检查上一次输出内容,和原文比对,确认翻译内容是否完整。若不完整,你要接续上一次文本的末尾继续输出,直到完成任务,禁止从头重新开始翻译。若上一次输出内容已经完整,你将会询问我,[对不起,我已经完成上次翻译任务,请问还有新的翻译内容吗?或者你需要我重新翻译之前的内容?]在我回答之后,你将按要求翻译我给予的新内容,或者重新翻译之前的内容。


 Fei-Fei Li 09-22 17:361楼
 t 09-22 17:362楼
 tinker 09-22 17:383楼
 ychell 09-22 17:404楼
 linker9 09-22 17:435楼
 tomatoEat 09-22 17:446楼
 ash 09-22 17:457楼
 OneDingZ 09-22 17:468楼
 黑部奈叶香 09-22 17:469楼
 nyesquare 09-22 17:4610楼
 Ashoka 09-22 17:4711楼
 usaki 09-22 17:4812楼
 dylanlau 09-22 17:5013楼
 0v0 09-22 17:5414楼
 TOom 09-22 18:1315楼
 mi tu 09-22 18:1516楼
 Lazelz 09-22 18:1517楼