
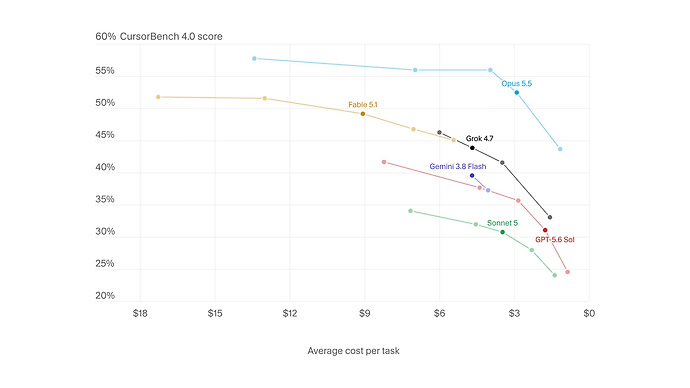
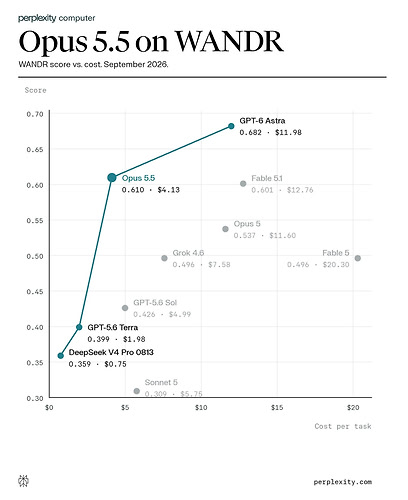
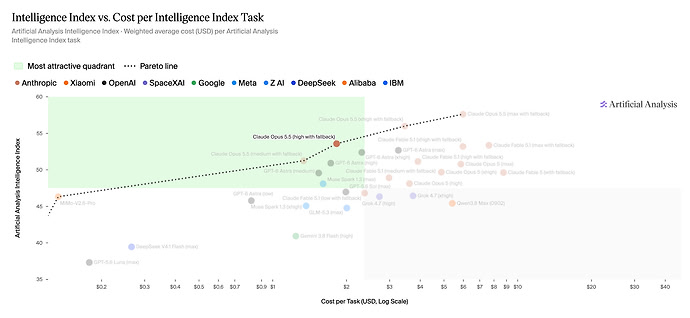
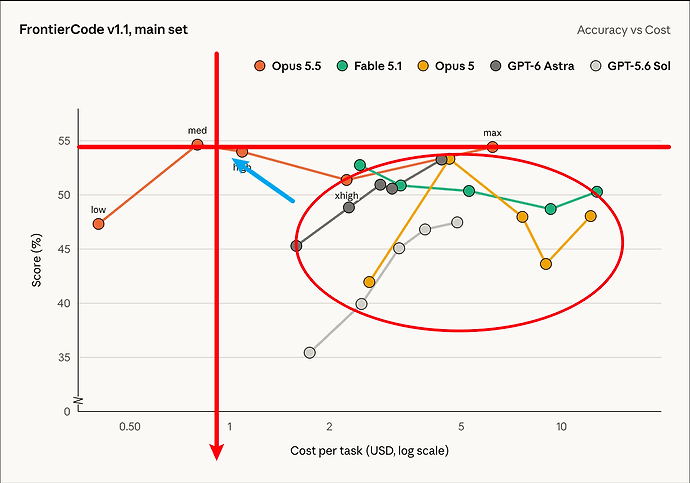
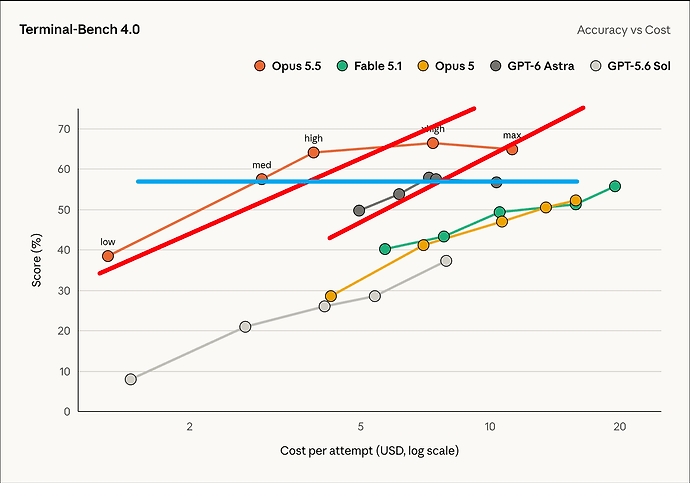
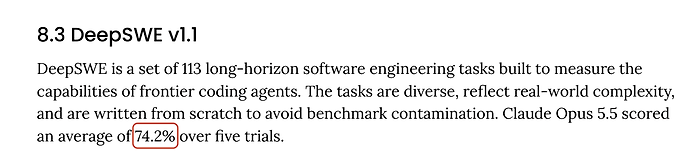
重磅分析:目前来看Opus 5.5 似乎 *大幅* 提升了帕累托前沿,实现了智价比的飞跃
VrianCao
2026-09-23 01:47
1
最新回复 (8)
-
 apparition 09-23 01:531楼
-
VrianCao 楼主 09-23 01:552楼
-
 OneDingZ 09-23 01:583楼
-
 木南城 09-23 01:594楼
-
 维维亚米利欧 09-23 01:595楼
-
VrianCao 楼主 09-23 01:596楼
-
OneDingZ 09-23 02:017楼
-
VrianCao 楼主 09-23 02:138楼
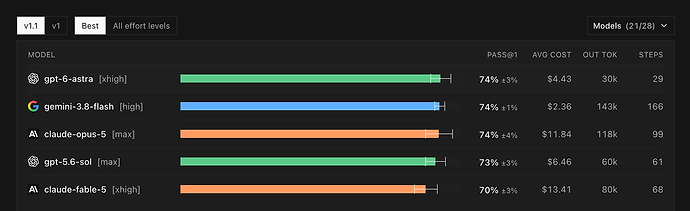
* 帖子来源Linux.do
附近帖子
- ↑6sol/luna才是真核弹吧
- ↑gpt6-luna,free账号的神,也有了
- ↑OpenAI 也卷了... GPT-6-Sol,输入 2$/M,输出 10$/M,GPT-6-Luna,输入 $0.1/M,输出 $0.5/M...
- ↑6sol 和 6luna 的价格 核弹爆炸了…
- ↑Opus5.5 鹈鹕测试(你绝对想不到的细节,有点东西)
- 📍 重磅分析:目前来看Opus 5.5 似乎 *大幅* 提升了帕累托前沿,实现了智价比的飞跃
- ↓震惊围坐 Opus 5.5
- ↓佬怎么渡过工作中一些难熬/想辞职的时刻
- ↓opus5.5鹈鹕骑车效果
- ↓CLAUDE封号的一起讨论看看。究竟哪里出了问题
- ↓Dario 笑话之踩踩刹与老马啊老马