codex换不同的思考强度会省额度吗

slexy 2026-09-27 13:42 1
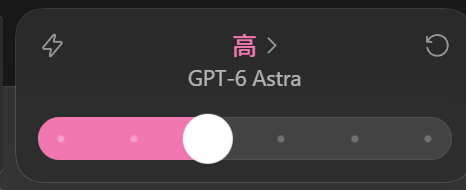
之前有听过在一个会话中中途切换模型会导致缓存失效,影响性能。那如果是在同一个对话中用一样的模型,但是只切换思考强度的话也会影响模型性能吗,因为有的时候监控训练进度的时候,不想继续开astra high了感觉非常浪费…


最新回复 (6)
  • RzMY 09-27 13:47
    1楼

    6系列的缓存是跨思考等级通用的,直接换就行

  • ILS36 09-27 13:55
    2楼

    我现在用的一部分提示词:

    使用gpt-6-astra的high推理强度预先分析整合生成完整方案,使用gpt-6-sol的high作为实施主进程,简单功能使用子代理gpt-6-luna的max完成,最终审计验收使用gpt-6-astra的medium完成;子代理运行较慢,期间减少主模型的唤醒询问次数。

  • slexy 楼主 09-27 13:57
    3楼

    谢谢老友,但还是想询问一下这部分提示词,是写在AGENT.md吗,还是通过对话框的额形式进行约束呢

  • ILS36 09-27 13:59
    4楼

    根据情况,直接写在对话框里布置任务就好。最好是先通过网页版的pro讨论出可行性方案,再通过这个提示词加上传的方案附件进一步规划实施。

  • sis5595 09-27 14:51
    5楼

    使用gpt-6-astra的high推理强度预先分析整合生成完整方案,使用gpt-6-sol的high作为实施主进程,简单功能使用子代理gpt-6-luna的max完成,最终审计验收使用gpt-6-astra的medium完成;子代理运行较慢,期间减少主模型的唤醒询问次数。


    codex会在任务过程中根据情况自己改模型和推理强度吗?

  • ILS36 09-27 14:54
    6楼

    开始时使用的模型无法切换,后续执行过程中就能自动切换了,不管是拉起子代理还是自己新建一个对应模型的会话,实测在chatgpt desktop上都是管用的。所以如果你是要先让astra规划的话,就选择astra起手就好啦,后续会自己调整模型的。

* 帖子来源Linux.do
返回