Claude Code 刚说一句 hello,上下文怎么已经没了 15%?

sherard 2026-09-29 14:34 1

有时候刚打开 Claude Code,明明只说了一句 hello,/context 里却已经占掉一截。第一反应往往是:我什么都还没干,Token 到底被谁吃了?


答案通常不是 hello 太贵,而是这轮对话在你开口之前,就已经带着一批“开场行李”进来了。


这些内容可能比你的第一句话更早进入上下文


系统指令和工具说明:Claude Code 要先知道自己能读文件、改代码、运行命令,以及每个工具该怎么调用。工具越多,说明书通常也越长。


项目指令:项目根目录和相关目录中的 CLAUDE.md、规则、约定,会影响它如何理解代码和执行任务。官方文档也明确说明,CLAUDE.md 会在会话开始时被读取;文件越长,启动成本和干扰都可能越高。


MCP 工具定义:接入 GitHub、数据库、浏览器等 MCP 后,模型需要知道有哪些工具以及参数怎么填。即使这一轮没有真正调用,它们的定义也可能占用可用上下文。


自动记忆和历史消息:恢复旧会话、加载记忆或继续一个长任务时,上下文自然不会从零开始。


所以 /context 展示的是整轮请求所需的上下文,不只是你刚刚输入的那几个字。


我现在会先做三个检查


第一,看 /context 里哪一类占比最大,不要只盯总百分比。


第二,暂时关掉这个项目根本用不到的 MCP。需要查数据库时再开数据库工具,不要让十几个工具长期陪跑。


第三,检查 CLAUDE.md:只保留长期有效、会影响执行结果的规则。项目介绍、临时进度、几百行接口说明,应该拆到普通文档里,让 Claude 需要时再读。


真正该优化的不是每一个 Token


上下文并不是越空越好。必要的项目规则能减少返工,常用工具也能省掉复制粘贴。问题在于:常驻上下文里有没有大量“本轮用不到,但每轮都要带上”的内容。


我更愿意把它理解成电脑开机自启动:不是一个都不能有,而是每一个都要问一句——它真的需要每次启动吗?


顺带说下我自己的用量检查方式


我平时会用 CC Switch 管理不同接口,并通过 TrueSOTA 接入 Claude、GPT、Grok 等模型。这样做的好处不是“换个中转站就能凭空省 Token”,而是切模型、看调用和对比实际消耗更方便。上下文是否臃肿,最终还是要靠自己的配置和任务拆分来解决。


TrueSOTA:TrueSOTA - AI API Gateway


留个问题


大家刚启动 Claude Code 时,/context 通常已经占多少?你们遇到过最夸张的是 MCP、CLAUDE.md,还是恢复的历史会话?


最新回复 (9)
  • 摇摆熊 09-29 14:36
    1楼

    你都不知道,有linux登录,再让创建账户,你会损失多少潜在客户

  • vampeng 09-29 14:51
    2楼

    额度呢?总额度消耗多少,说出来我想知道

  • ziyue yu 09-29 14:53
    3楼

    典中典不是而是,经典ai写个段落+自己站的宣传模式,每天运营时间10分钟

  • 栗子 09-29 14:57
    4楼

    这个有点夸张了吧,是不是突然降智了

  • ycxsw 09-29 14:59
    5楼

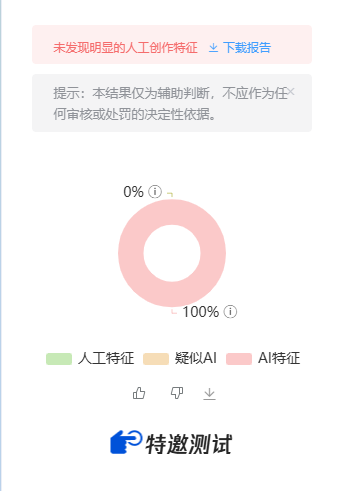
    写个帖子很难吗 这么敷衍 ai味也太重了吧 ^-^

  • UMR 09-29 15:02
    6楼


    未发现明显的人工创作特征,呵

  • agand_de 09-29 15:04
    7楼

    aigc生成内容未使用截图发布 这帖子我还以为我逛的是微信公众号和小红书的ai贴

  • agand_de 09-29 15:06
    8楼


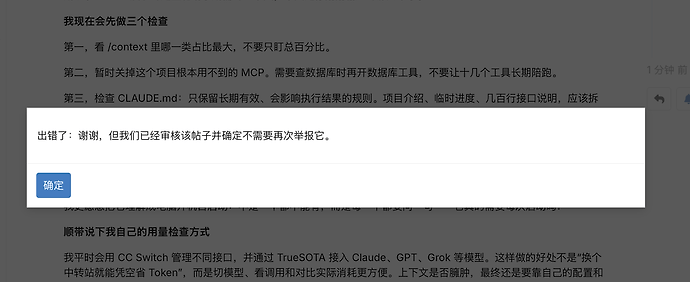
    审核真的看不出来这是纯ai生成的吗

  • 千手扉间 09-29 15:16
    9楼

    我也感觉一股ai味

* 帖子来源Linux.do
返回