跑本地LLM,做了一轮调研,想听听佬友的意见

王多鱼 2026-09-29 17:36 1
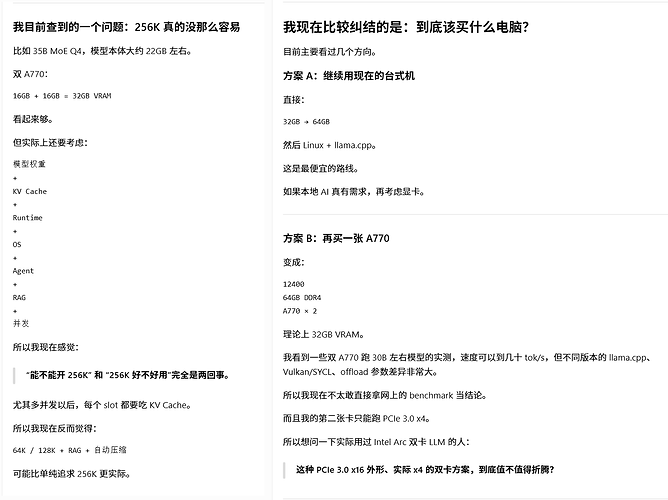
佬友们 我还是在幻想,本地LLM 有没有搞头


目前手里一台垃圾笔记本, 最近想换一台电脑,主要用途不是传统办公或者游戏,而是想认真折腾一下本地 LLM / Coding Agent / Agent Loop。


预算大概 8K~1.2W RMB,如果确实有明显提升也可以再往上,再多就用官方了。。。


我的需求


主要是:


  • Coding Agent / Agent Loop

  • 多终端同时调用

  • RAG、文件分析、代码修改、测试等


现有设备


  i5-12400
MSI MAG B660M MORTAR WIFI DDR4
DDR4 32GB
Intel Arc A770 16GB
850W 电源

想法是 再买一张 A770,搞:


A770 16GB × 2
32GB VRAM

至少 30B/35B Q4 模型(我估计这b样只能跑 MOE架构[只激活3B]的了 ),能用


所以 问题来了,本地大模型是不是 “镜花水月” 只能看不能摸


在 8K~1。2W RMB 预算下:


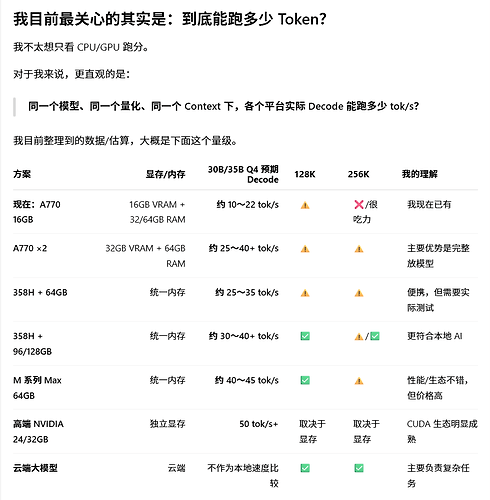
方案 我目前预期 Decode 优势
现有 A770 16GB 10~22 tok/s 不花钱(能跑都是奇迹)
A770 ×2 + 64GB 25~40+ tok/s 32GB VRAM
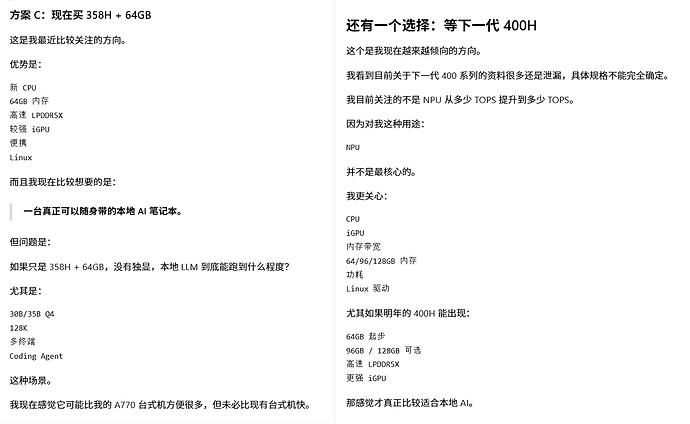
358H + 64GB 25~35 tok/s 梦中情人(太贵啦!!!)
358H + 96/128GB 30~40+ tok/s 压根没有这玩意
下一代 400H + 64/96/128GB 未知 等等党永远不输
M 系列 Max 64GB 40~45 tok/s 左右 统一真神
NVIDIA 大显存卡 50 tok/s+ CUDA 生态

这些数字目前有些是公开实测,有些是根据已有数据做的估算,我不把它当最终结论。


本地 Qwen3.8 35B-A3B MOE架构 估计只有这个选择了,还是 int4 量化版本

这A770pro 16G 据说有4060 80% 的能力


想听听佬友 对于本地llm的看法和意见。(求求热^-^)

最新回复 (19)
  • agi_is_coming 09-29 17:38
    1楼

    怎么说也得上个27b fp8+能开262k


    才有可用性

  • Ruby 09-29 17:39
    2楼

    如果佬纯换过一台的话我会推荐组双卡2080ti跑int8版本的qwen3.8 27b swift微调。

  • chenyu777 09-29 17:40
    3楼

    本地,你得要多好得显卡啊,一般得显存肯定不够,小模型跑起来用处不大,生产力肯定不足啊

  • 还来不及哭穿过的子弹就带走温度 09-29 17:41
    4楼

    不是很懂啊,有这个预算是不是直接买服务器更划算?

  • fantooler 09-29 17:41
    5楼

    本地llm预期来看,近两年内真没啥用,还不如买个好显卡,本地跑ai视频,minimaxh3已经看到希望了,下一个新模型估计能锤seedance

  • nofallbehind 09-29 17:41
    6楼

    CPU 2697V4 18核36线程40条Pcie3.0

    主板 国产C612芯片组

    内存 32G ECC DDR4 (可拓展)

    硬盘 512G致态 M.2

    显卡 2080Ti-22G 双卡44G

    散热 定制静音

    电源 1000W 金牌全模组

    机箱 塔式无光静音

    配件 Nvlink桥接器一套

    咸鱼上面看的套餐:9000,这个有坑么

  • 王多鱼 楼主 09-29 17:42
    7楼

    这个int4 应该也凑错吧,最近看了些,感觉我又醒了 32G能开 262k??? 真的吗

  • moozik 09-29 17:42
    8楼

    能跑,主要还是智商太差了,属于事倍功半,我感觉本地部署的模型主要是干一点小活

    比如简单识别一下图片,翻译,再比如最近的那个jev的开源版本

    拼智商本地部署不划算

  • gjyus 09-29 17:42
    9楼

    买个20x爽下得了,本地部署很简单,关键是你会用吗?部署完了就不会再用了 ^-^ ^-^

  • chongxs 09-29 17:43
    10楼

    社区有个v100的解决方案,跑27B,嘎嘎猛~单跑27B,比pro6k的速度都快。

  • 王多鱼 楼主 09-29 17:43
    11楼

    一万块能买服务器,这跑不了吧 租倒是可以,只是没试过本地的

  • Ruby 09-29 17:44
    12楼

    建议自己买哈,这种主机特别是咸鱼上都没保

    2080ti22g pdd上可以找那个久一点的带店保的改好散热的,非涡轮卡

  • Ruby 09-29 17:46
    13楼

    四卡T10方案也可以考虑一下,E5双路大板就可以了

  • 王多鱼 楼主 09-29 17:46
    14楼

    我干了 2080ti 都已经2500了 整机也1W


    说实话我一直觉得 我1W 没显卡的电脑像是一个傻逼 这价格4060 5060都上了


    但是要兼顾办公 是不是只能这样了

  • hor1zon Lin 09-29 17:47
    15楼

    我觉得可以用google ai 订阅先订阅个20刀,然后申请colab体验一下40GB A100,先尝尝鲜,看看本地AI适不适合自己,我觉得现在电脑硬件这么高价格情况下,还是慎重一些,因为很可能买完效果一般

  • 梧桐 09-29 17:50
    16楼

    先不说这个预算,假设能跑起来,但是能跑和能用是两码事, 尤其是你想本地验证workflow,如果开subAgent 做agent loop(大概率要),跑不起来一点, kv cache 会爆掉,然后就是功耗拉满,风扇狂叫

  • 王多鱼 楼主 09-29 17:51
    17楼

    是个方向啊 生成AI视频 给我妈看了 天天看AI短剧 我直接给他上狠货

  • 王多鱼 楼主 09-29 17:52
    18楼

    这预算也买不了几个月 买完就两手空空 有点舍不得

  • gjyus 09-29 17:56
    19楼

    你本地部署上了过后跑不到两周,你听我劝,我之前有八张A100比你想的还多,真搞了就知道,差远了,涉及很多优化,能跑和能用是两件事。更别说你还要玩花活,做agent。

* 帖子来源Linux.do
返回