
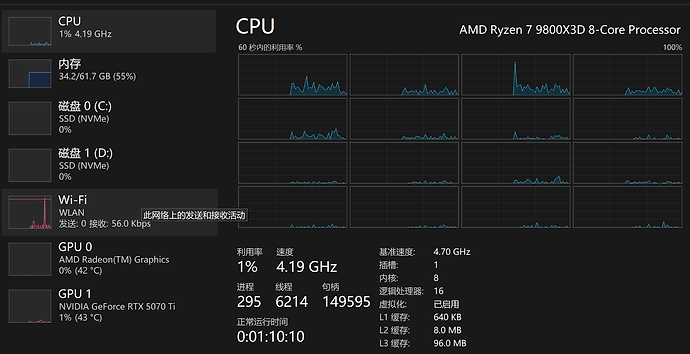
关于qwen3.8-27b的模型选择以及部署方式的问题
trigger
2026-09-29 09:11
1
最新回复 (9)
-
 北夜 09-29 09:151楼
-
 林澈清鱼 09-29 09:162楼
-
 cknights 09-29 09:173楼
-
trigger 楼主 09-29 09:184楼
-
trigger 楼主 09-29 09:195楼
-
 Fsharp 09-29 09:216楼
-
 derkjohn 09-29 09:247楼
-
 lopez 09-29 09:268楼
-
 bluepost 09-30 12:119楼
* 帖子来源Linux.do
附近帖子
- ↑48team GPT网页端降智完了,比豆包还流口水
- ↑Muse注册“尚未在你的国家或地区开放”
- ↑充值了一个月 claude pro,希望运气好点
- ↑中行2233万事达到手
- ↑大模型视觉这么强了,为什么还不能做标注任务?
- 📍 关于qwen3.8-27b的模型选择以及部署方式的问题
- ↓LOL 国庆活动 比惨大会
- ↓Pro 500$ 这个也太耍流氓了
- ↓感觉如果没有家庭托举的话,很难结婚了
- ↓codex客户端为啥没有6.1sol
- ↓DeepSeek这个官方的价格,有点贵啊