大模型视觉这么强了,为什么还不能做标注任务?

Eason Yan 2026-09-30 11:32 1

佬们,现在大模型的视觉理解都已经这么强了,为什么我让它帮忙去做一些目标检测任务的标注,却弄得非常差?为什么会出现这种情况呢?这个地方有点不太理解。

最新回复 (13)
  • agi_is_coming 09-30 11:33
    1楼

    有专门的模型


    这段时间没关注过了,之前nvidia的eagle还不错

  • leonvxe 09-30 11:34
    2楼

    你的视觉能力强的结论是怎么来的?

  • 宫野志保 09-30 11:35
    3楼

    常见的目标是可以的,不过要注意不同的模型输出图片的坐标不太一样,有的是绝对坐标,有的是归一化到1000的

  • bobo1314 09-30 11:35
    4楼

    你用它来做啥了,yolo?

  • mounttai 09-30 11:36
    5楼

    能不能让大模型操纵检测模型,RSI了

  • Crazy-09 09-30 11:36
    6楼

    虽然说有一个新闻是Ai解决人类无法解决的问题,但是还不成熟,你没办法让Ai去做没有资料的东西。

    就算写代码,你看看github没有的项目,叫Ai写出来的代码逻辑,跑都跑不顺,测试都是自己编的,你说清楚逻辑的情况都写不出来

  • Eason Yan 楼主 09-30 11:53
    7楼

    是的,做YOLO,但我觉得一些简单的物品应该是比较好识别的,就是不知道为什么做出来效果不好。

  • Eason Yan 楼主 09-30 11:53
    8楼

    好的,谢谢大佬。我去看看

  • Eason Yan 楼主 09-30 11:54
    9楼

    是的,我觉得输入到大模型token化了之后,应该是丢失了绝对坐标。

  • Sky390 09-30 11:56
    10楼

    标注任务就是很难绷,我前两天让 ds 和 glm 标数据集给我整破防了,最后还是手动标的。

  • neteroster 09-30 11:59
    11楼

    你可以举个例子 实际上现在前沿大模型做这个并不差


    或者是你的任务实在太不常规 太难了

  • neteroster 09-30 12:03
    12楼

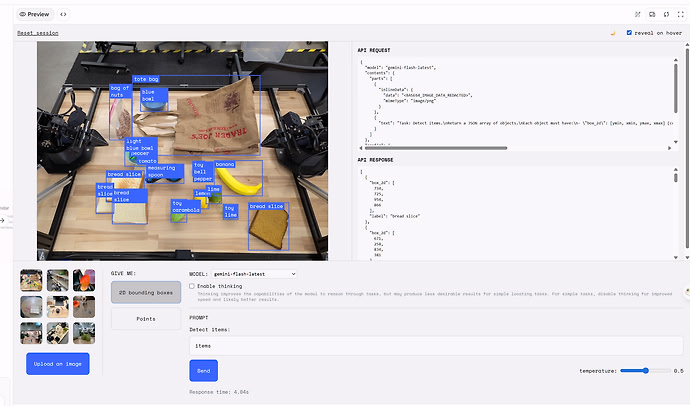
    我举个例子 有人测这个


  • DeepSuck-深度求嗦 09-30 12:09
    13楼


    谷歌gemini这个可以 你去试试

    在aistudio的gallery搜 Robotics Spatial Understanding有的体验

* 帖子来源Linux.do
返回