【图一乐】怀疑Gemini 4 Argon是大砍知识量和智商去刷Agent分数

V_Arrow 2026-10-01 09:23 1
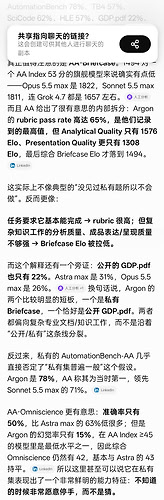
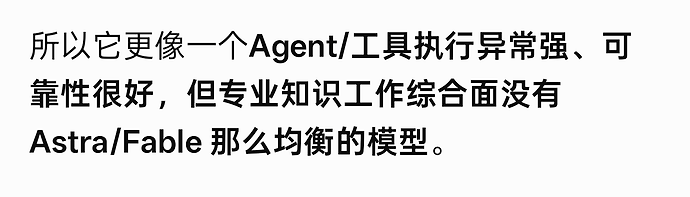
试着让GPT分析了一下Argon的AA index各个子项的得分,本来我是问是否出现了公开测试集核弹爆炸,私有测试集拉胯的情况,GPT分析以后说是没有明显证据,反而给出了这个结论:


具体交给他的任务会完成得很好,但是复杂任务的分析的世界知识表现不行。

搞了半天还是个大号Flash啊,没记错的话3.5 Flash定价好像就是输出接近9USD了吧,倒是和Argon差不多。^-^


GPT详细结论


最新回复 (19)
  • 亓水 10-01 09:24
    1楼

    有点抽象,让GPT去分析滚木的数据吗?

    怎么还改标题,不知道为什么对gemini恶意这么大,Google已经是模型厂商唯一被叫大善人的了 ,不希望Google崛起,难道希望A\这样的崛起吗

  • windgo 10-01 09:25
    2楼

    这个跟之前披着3.8皮测试的4pro是一个模型吗

  • 板栗君 10-01 09:25
    3楼

    啊喂,这都还没开始用上呢,从跑分逆推?… 有点离谱哦

  • V_Arrow 楼主 10-01 09:25
    4楼

    毕竟现在没有其它测试数据,就当图一乐吧

  • 大雨落江面 10-01 09:25
    5楼

    无敌了,还有这样蹭热度的。这跟AI判刑有什么区别。

  • Hifumi Mizuhara 10-01 09:26
    6楼

    大砍知识量但是Text arena第一吗,那咕咕嘎嘎很有黑科技了^-^

  • V_Arrow 楼主 10-01 09:26
    7楼

    从另一个角度,连容易拿分的跑分都表现不佳,真实性能确实容易怀疑^-^

  • V_Arrow 楼主 10-01 09:26
    8楼

    对我来说只要文笔能稳住我依旧愿意用

  • 板栗君 10-01 09:28
    9楼

    楼上所说的Text arena就不是一个容易拿高分的 ^-^ 跃迁式增长了,还是值得期待的

  • quina 10-01 09:28
    10楼

    那skill表现能比较好?那其实利好外接方法,没实测不好下定论啊XD

  • liuliu 10-01 09:28
    11楼

    咱是预期是好用的,难得有这么慷慨的平台。

  • V_Arrow 楼主 10-01 09:30
    12楼

    希望向公众开放后能打脸吧,依稀记得当年Claude3好像就是跑分没赢过体验没输过

  • V_Arrow 楼主 10-01 09:34
    13楼

    至少根据哈基米的前科来看,有必要提前降低预期。当时3.7还是3.8,DeepSwe等旧测试集直接对标Sol,结果还不是美国豆包。

  • 大雨落江面 10-01 09:36
    14楼

    谷歌吹牛逼是必然的,我是说用gpt测评纯搞笑。

  • 丰川祥子 10-01 09:37
    15楼

    根据提示词的不同,或许GPT会给出完全相反的结论也说不定

  • ishtar 10-01 09:40
    16楼

    我怎么印象里哪怕gemini前一段玩的那些flash大份没有一个是以跑分著称的,主打的都是拉稀的速度

    当然argon的跑分看上去确实很奇怪

  • SpaceQ 10-01 09:40
    17楼

    不是吧,gemini一个还值得 称道的就是它的世界知识量和智商了,把这个都砍了不是自废武功吗。还是说看到AO在coding和agent方面那么风光之后,坐不住了,路线也要往这方面倾斜?

  • 哈比 10-01 09:41
    18楼

    不是哥们,咱都还没用呢就开始分析上了。而且盲目相信一个 AI 的判断也不好吧?而且世界知识库这一块我觉得压根就不可能砍,因为这相当于自废武功了。

  • scp3500 10-01 09:43
    19楼

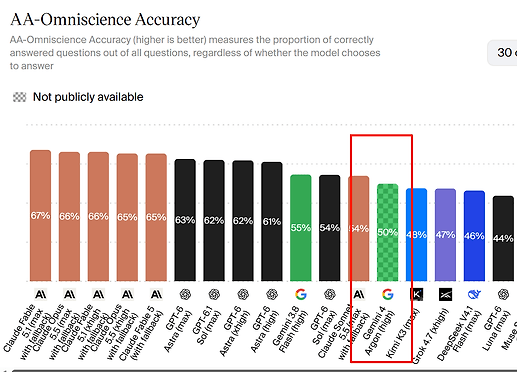
    gpt说世界知识不行是参照这个的吧

    (个人感觉确实有点古怪,pro怎么会表现出比flash更差的知识水平呢)

* 帖子来源Linux.do
返回