搬运一下自己的一篇帖子
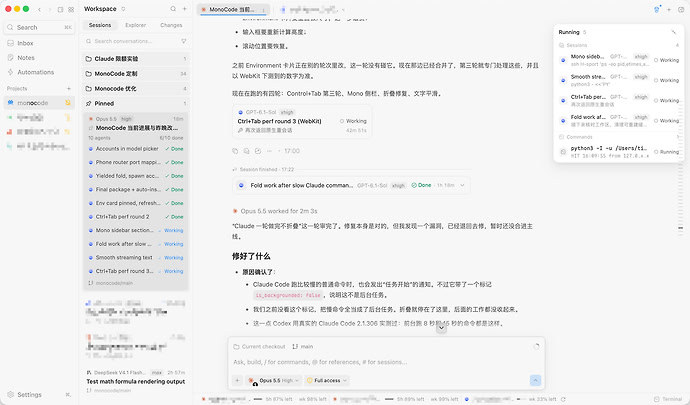
我其实和很多朋友表达过一个观点:几乎所有的软件行业,当下的第一要务是研究并找到自己用着最顺手的工作流,然后靠高质量的 SOTA model token 去快速迭代,我称之为 personal RSI. 那在现阶段,我们人还能做什么?我目前觉得,优化 Agent 的工作流、提高我们对 Agent 的驾驭能力,是一个非常重要的点。在这一块,Harness 作为人和 AI 的对接口,是非常重要的一个点。
TL, DR:
- 以 Intelligient UI / UX 为核心的审美追求是对 Harness 生命长度以及用户粘性的底层保障
- 要做 Harness of Harness: 集成各厂家的原生 CLI
- 以 session 为核心重构:解耦多模型协作以及多 session 协作
- Harness CLI: 以 CLI + Skill / 斜杠命令的形式优化模型上下文管理
- Monos / Agent as Memory: 从用户的角度重新设计 Agent Memory
- Agent Search 的重要性
- 多模型协作,Remote Control, Mobile App 等使用体验
想聊一聊我对下一代 Harness 的一些理解。其实现在有很多 Harness,包括官方的一些 Harness,以及客制化的一些 Harness,我随便就可以举出来一大堆,比如 Codex、Claude Code;第三方的有 T3 Code、BB、Synara。但是作为一个用户,在实际使用的时候,我确实对任何一个单独的 Harness 都不够满意。我觉得可能有几个方面吧。
一个是我觉得这些 Harness 的 UI 真的不够美观。
另外一个是,厂商原生的 Harness 对自己的模型会做极致优化,但对其他模型并不会做优化。也就意味着,他们设计的目的不是为了做多模型协作。
而第三方的一些 Harness 会考虑到多模型的协作,但它们也会涉及很多问题。一般来说,第三方的 Harness 分为两种。第一种是用一套工具、System Prompt,包括它们的压缩策略等,去适配所有模型, 比如 Pi, Cursor, Devin。这样做的好处是,他们可以把整个 Harness 做简化,因为他们只需要维护一套工具。那么,这样做的另外一个坏处是:因为模型在推理时使用的工具集和它们原生的 CLI 并不一致,所以它们的性能并不能得到足够保证。另外一种,则是类似于 T3 Code 和 Synara Monocode 这种集成多个原生 CLI 的 Harness,我可称之为 Harness of Harness。它们的优势在于,每个模型仍然使用原生 CLI,可以保证模型表现不会弱于原生效果(当然,前提是做好了足够的优化)。坏处就是,因为要给每一个模型维护一套对应的 CLI 以及适配层,整个 Harness 会变得非常复杂,也会经常遇到各种各样的 bug。而由于这种复杂性,UI 方面也会有很多的问题(目前像 ACP 这类协议大家的兼容性也还不够,其实挺希望行业能有一个统一的通信标准)。从我的个人角度来说,我会觉得用一套工具和 System Prompt 的方式不够好。 对于这种 Harness 的厂家,比如 Cursor 和 Devin 来说,他们其实都会针对不同的模型适配不同的工具集,并且做大量的 evaluation。这样的话,为什么不用原生的 CLI 呢?
聊完 UI 和 Harness 的适配效果之外,我觉得第二个非常重要的点是:现代的 Harness 应该以 Session 为核心做一次重构。其实,以 Session 或者 Thread 为核心构建的 Harness,可以天然克服我们现在遇到的一些问题,比如多种 Agent 之间的协作,包括 orchestrator,也包括主模型带着辅模型等等,还有就是 subagent 的实现。这一方面,其实我觉得 Claude 已经在有意识地往这边转了。像官方的 Codex App 以及 Claude Desktop,我们可以发现,它们都已经具备成熟的 Session 功能。但其实很多 App 还没有做到这样一种 Session 级别的重构。
我觉得,一个理想的 Harness 就应该以 Session 为单位做一次底层重构。每一个 Session 底层可以有不同的 Provider,用不同的原生 CLI 去支持。如果考虑多 Provider 和模型之间的切换,像 Monocode 的底层会对不同的 Provider 和 Harness 做映射,从而映射为同一套体系,可以做相互转换。那么,以 Session 为核心,我们其实可以做出很多非常具有想象力的操作。比如,我可以轻而易举地让 Claude 做一个总览规划,然后把一些具体实现任务分给 Codex,把一些需要速度的任务分给 DeepSeek,把一些文字类任务分给 Gemini。从另一方面来说,现在很火的 Muse,包括 OpenAI 的 Dots、Grok bot 等等,它们底层的 Personal Agent 其实也需要这种以 Session 为单位的重构。因为如果想维护一个 Agent 的超长上下文,是很难做到的,上下文会被多次 Compact 污染。一个更好的做法是,同一个 Bot 管着不同的多个 session.
聊完以 Session 为单位的重构之后,我们就要考虑怎么实现这么一种以 Session 为核心的 Harness。这一块又会分为两种:一种是以 MCP 的形式注入,一种则是以 Skill 的形式注入。比如 T3 Code 和 Synara,它们都是通过 MCP 形式注入的。那这一块我们就要聊的点是上下文的管理。我们一般注入 MCP 的话,会注入大量工具描述以及一些描述性 token,这就导致你开一个新的对话,只是发一个“你好”,就要付出几万个 token 的代价。我想强调的一个点是:虽然这一部分 token 后面可以被 cache 住,但是因为一个 Agent 代表的是非常多轮的对话,而每一轮都要 cache read 这么一部分 token。比如说,我们现在 MCP 要注入 30K token,Cache read 1000 次,那就是 30M 的 token。事实上,你去看现在 Agent 的账单,Cache read 的占比会非常非常高,一般可能会到 97% 以上。为什么 Cache read 这么大呢?因为有一部分 token 我们需要反复读取。社区里有人说,用 Claude Desktop 会比用 Claude Code CLI 少大约 10% 的额度。这 10% 的额度差异,就是因为 Desktop 会注入额外的 MCP token。
另外一个方面就是上下文长度对于模型性能的影响。其实这个东西在去年可能研究的人更多;而在今年模型能力提升之后,大家可能对这个点的关注就没有那么高了。但不可否认的是,很多模型在 256K 之后的性能仍然会显著下降。这个时候,你的 MCP 这一部分 token 的占用量就会非常重要。因为 MCP 占 30K,你可能就要少 30K 的有效窗口。比如现在还有一些 Codex App,它们有一些 browser,包括一些 automation 操作,都是通过 MCP 注入的,那这一部分 token 都会很大。
我知道,可能会有朋友去说 Tool Search 这么一个东西。那我觉得,Tool Search 的本质和 Skill 的差别也不是很大呀,为什么不用 Skill 去做呢?那么从这条来说,我觉得我们最应该做的是提供一个 Session 操作的 CLI。模型去操作这样一个 CLI,实现各种各样的 Session 级别的管理。关于这个 CLI 的描述,我们完全可以把它作为一个 Skill。这样做的好处是:一方面,我们不激活这个 Skill,就不用让模型付出这部分 Token tax;另一方面,当我们在一个主对话里面激活这个 Skill 去 Spawn 子对话时,子对话因为没有激活这些 Skill,就不用担心子对话进行循环嵌套的 Spawn。这里我指的并不是单纯的 Skill。因为如果是 Skill,它仍然会在上下文里有一个比较短的描述。而我这里说的关于这个 CLI 的描述,可能更像一种斜杠命令,只有用户手动激活,模型才能得到这部分描述。
具体来说,实际上我们的 Session 会分成两种:第一种是普通 Session,另一种是我说的类似 Mono 这种高级 Session,它作为一个高级 Agent。对于 Mono 来说,它在输入时会自动激活我们的这个操作;在我自己实现的版本里面,它是一个 /operator 这样的操作。至于在 Session 之间怎么传递信息,这个是由主 Agent 去写的。在这个地方不能加非常强的约束,因为用户的需求和任务的实现方式是多种多样的。我们只需要用一个强大的主模型,让它去理解用户需求并对齐,并且给出一个需求明确的 Prompt 就可以。从我实际使用来看,也并不会遇到所谓的预算传递或者深度限制这些问题。
然后我想聊一聊 UI 方面的一些事情。其实我个人感觉,很多厂商在做 Harness 的时候根本不在意 UI,但是苹果之所以是苹果,就是因为它有独特的审美。从我目前的使用体验来看,纯粹的 AI vibe 产品有浓浓的 AI Slop 的味道,没有足够的审美。而作为一个用户,我会在意它的 UI,在意它的审美。包括最近 ChatGPT 出得很火的 Open Intelligence UI,为什么这么多用户都在夸赞?是因为它真的给了用户足够好的交互体验。作为一个开发者,我愿意去打磨一次工具调用的 UI、一次 thinking 的 UI、多次工具调用和 thinking 的折叠 UI 等等。这都是为了让我有足够的开发体验。而 UI 这方面,我觉得可能是未来一些 Harness 的主要分歧点,因为底层技术、存储等方面大家会趋同,而审美和 Design 这一方面,大家会百花齐放。我目前的考虑是,把很多 UI 展示为独特的卡片,比如有对应的 Session 卡片、Artifact 卡片、HTML 卡片等等。这里要补的一句话是:怎么让模型产出这些 Artifact?这些说明其实仍然要 Skill 化。我的做法是把 Artifact 作为这个 CLI 的单独一部分。
还有一个方面,是我觉得很重要的一点,就是记忆方面:Agent Memory。当然,我知道这个 topic 其实从 LLM 出现开始到现在,都是大家研究的热点。但是你可以看到,尽管社区有非常多 Memory 的实现,比如用知识图谱去实现,用 SQLite 这些数据库去实现等等,最前沿的 AI 实验室仍然会选择最简单的 Memory 实现方式,比如 Claude 的 Auto-Memory,包括 Codex 的 Memory 记忆等等。大家的理念就是:Simple is effective。
那么我想提出的另一个角度是,Agent Memory 不是必须静态的。在真实的用户体验中,我觉得 Memory 可以分成两个部分。第一个部分是长期记忆,比如用户的偏好、用户要注意的点。那么,这一部分记忆,我们有必要以 Markdown 形式把它们作为一种文件化也好,或者长期化也好,都是要把它保存下来的。那么另外一部分记忆则是短期记忆。比如我们想实现一个目标,列了一个 todo list,它到了哪一步了?传统的实现方式是,这一部分记忆会直接留在 AI 的 Context 里面。我想提出另外一个观点:Agent as Memory。什么叫做 Agent as Memory 呢?就是由一个主对话来控制我们整个项目的进展,以及用户的一些需求。最直观的例子就是 Claude 最新推出的 Projects 功能,以及 Monocode 的 Mono 功能。用户只需要跟主 Agent 进行对话。当我们需要实现一个具体事情的时候,我们 spawn 出一个 Session 去做这件事,然后由主 Agent 控制和协调这些子 Session,再去和用户进行交流。这样的话,我们实际上是使用了一个 Agent,也就是这个主 Agent 来做这么一个 Memory。这么做的好处可能不太直观,但我想说的是,对于用户来说,用户的心智是有限的。一个用户当然可以自己手动打开多个 Session,然后同时做多件事情。但是人在这么频繁的 Session 级切换下,精力会很快被消耗掉。一个好用的 Harness,我觉得要从用户角度去考虑。那么,以这种 Agent as Memory 的方式,用户只需要和主 Agent 对接;当我们需要确认细节时,再进入子 Session 做进一步对话。那么,从这一块也可以进一步演化出现在比较火的 Personal Agent 等等。其实我觉得,用这种 Agent as Memory 的实现思路可能会更简单一点。
然后聊完了上述这些方面之后,我还想聊的一个点是 Search。这一块,我一开始并没有觉得它很重要。但随着使用越来越多,我会发现,很多时候我需要的并不是 Agent 去做一个事情,而是需要它 search 出一个足够成熟的解决方案。因为从信息壁垒的角度来说,由 Agent 本身去思考的一个解决方案,大概率是没法打破信息壁垒的。而通过 Search,我们搜索社交平台,搜索各种各样的信息源,才有可能打破这些信息壁垒。另外一方面是,很多时候用户的需求并不是非常清楚,用户可能只是需要一些额外的信息输入。比如我们想在一些社交平台上搜索一些信息,那它会比 Agent 自己去做回复要好得多。
现在一些 Search 的方案其实都很 naive。比如 Claude 可能就是 Web Search 和 Web Fetch;包括其他一些 Agent,可能就是通过百度或者 Google 这些搜索引擎去搜索。这些搜索引擎当然可以搜索,但是它们没法做到用户想要的那种搜索。比如,我想让 Agent 去小红书帮我搜索一下某家公司的信息,或者某家公司的一些社会评论;我想让 Agent 去 Linux.do 搜索一些技术帖;我想让 Agent 去知乎搜索一些大 V 的评论。这些都是很难做到的事情。
所以这一块我觉得可以分为两种:一种是有事实标准答案的 search,一种是偏主观性的 search。我觉得,有标准答案的 search 我们要走 API;对于偏主观性、讨论性的 search,我们要走类似 OpenCLI 这种复用登录态的方案。我最近也在看一些搜索 API,然后搭配本地的一些实验方案。大致思路是通过类似 DeepSeek Web Search / Fetch、Exa 这些 API,然后搭配本地的 OpenCLI,实现一些复用浏览器登录态的搜索,从而满足我的搜索需求。而这也恰恰是个人本地工具相比大厂更有优势的地方。
最后一个点是关于 Mobile App 和 Remote Control 的一些体验。这一块,国外用户可能没有足够的体验;但对国内用户来说,很多时候 remote control 和 mobile App 是非常重要的事情。这里种种原因我就不细说了。
其实我最近也在手搓一些自己的 Harness,上面写的这些东西,我基本上都已经实现了,觉得自己手搓一个 Harness 真的很好玩。但我也深刻地意识到,小作坊是永远打不过大公司的。我自己手搓的 Harness 更新速度,不用说跟大公司比,光是跟一些开源仓库比,都远远落后。所以我还是比较希望,我的一些思想能够被大公司采纳。这样我也可以得到更优秀的使用体验,也不用付出更多的维护成本。
我自己的一些经验吧:我觉得现在多模型协作不只是为了更低的成本,也是为了更好的效果。比如说我觉得 Claude 的审美,包括它对整个进度的一个把控、任务的一个分配,然后一些洞察和思考都是无可替代的。而在给定计划书和具体指导的情况下,GPT 的实现能力以及测试的完善度,都是 Claude 无法媲美的。而 Gemini 在文字方面的一些能力更是 Claude 和 GPT 望尘莫及的。包括如果为了平衡一些速度和成本,我也会引入 DeepSeek。目前对我来说,我是在自己搭建的这么一个 Harness 上,由 Claude 作为主 Agent,去协调不同的 Claude、GPT、Gemini、DeepSeek 子 Session,完成我的任务。那么,这一块就是我对 Harness 部分的一些理解,发出来和大家讨论一下。后续可能也会分享一些自己对 Agent 使用的经验。

 Butangchen 10-22 01:481楼
 apparition 10-22 02:012楼