[!quote]+
NVIDIA 旗下已推出一段时间的 GeForce RTX 30 系列(代号 Ampere)GPU,显然仍蕴藏着相当可观且尚未被充分挖掘的计算潜力。一个名为 “GPU Unlock” 的开源项目(由 GitHub 用户 Zagitta 开发)能够让 Ampere 架构 GPU 突破某些人为设定的性能限制;在特定工作负载下,其 Tensor Core 的计算吞吐量几乎可提升至原来的两倍 —— 且无需修改 NVIDIA 驱动程序,也无需永久刷写 VBIOS。
该项目专门针对影响 FP16/BF16 Tensor Core 运算(采用 FP32 累加)的 “指令发射速率限制” 进行了优化。在消费级 Ampere 显卡上,此类运算的执行速率相较于专业级产品受到了人为限制。通过移除这一限制,该工具能够有效释放 GPU 本身已具备、但此前被封锁的额外计算性能。
值得一提的是,GPU Unlock 的实现基于此前针对 NVIDIA CMP(加密货币挖矿专用)系列 GPU 的研究成果。它将 CMP 项目中的固件解锁技术与一种 “早期初始化” 机制相结合,通过一个在 NVIDIA GPU 驱动程序加载前便已执行的 Linux 内核模块来实现。该模块会修改相关的硬件速度选择器,执行 “功能级重置”(Function Level Reset,简称 FLR),随后允许未经修改的驱动程序正常完成 GPU 的初始化流程。
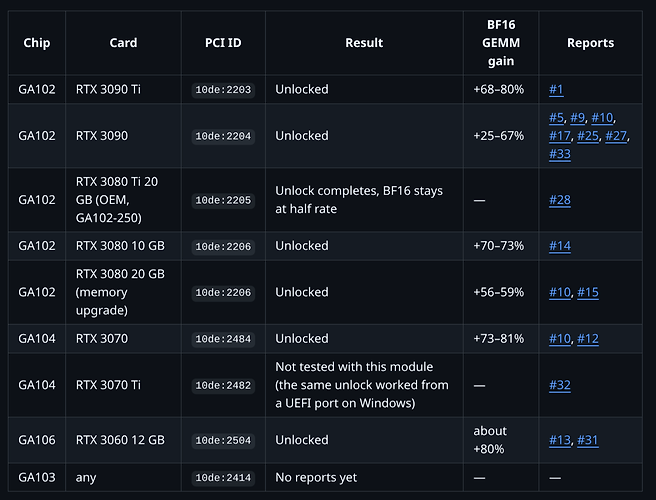
这意味着用户无需在每次 NVIDIA 驱动程序发布新版本时都进行重新打补丁。目前,该项目支持 GA102、GA103、GA104 和 GA106 等型号的 GPU,涵盖了 GeForce RTX 30 系列中的大部分产品;不过,并非所有显卡都能获得同样的兼容性或性能提升。
其性能提升效果十分显著。根据该项目 GitHub 仓库中公布的基准测试数据,在功耗限制为 450W 的情况下,RTX 3090 Ti 在采用 FP32 累加的稠密矩阵乘法(GEMM)测试中,表现如下:
Precision |
Stock |
GPU Unlock |
Improvement |
|---|
FP16 |
87.46 TFLOPS |
118.39 TFLOPS |
+35% |
BF16 |
87.50 TFLOPS |
157.41 TFLOPS |
+80% |
TF32 |
42.58 TFLOPS |
82.61 TFLOPS |
+94% |
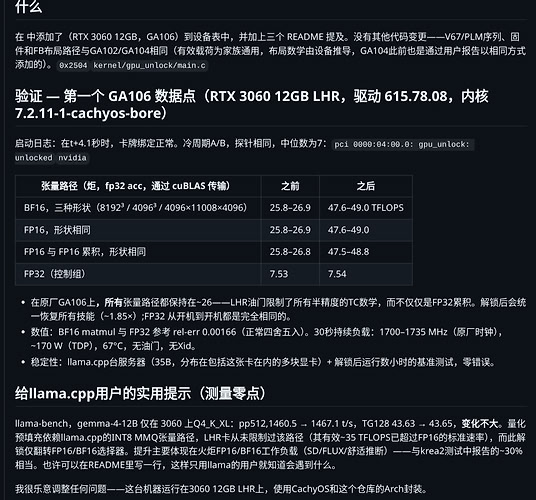
这些结果并非仅限于 RTX 3090 Ti。一位 RTX 3080 Ti 用户反馈称,在将 GPU 功耗限制在 315W 的情况下,BF16 吞吐量从 71.59 TFLOPS 提升至 113.98 TFLOPS,TF32 性能则从 35.65 TFLOPS 提升至 65.28 TFLOPS。另一份关于 RTX 3080 10GB 的兼容性报告显示,在该显卡原始 320W 功耗限制下,其 FP16/BF16 性能从约 65 TFLOPS 提升至 110–113 TFLOPS。这些性能提升也在 X 平台上得到了关注。
那么,在实际应用中的性能表现如何呢?幸运的是,社区成员已经开始在真实的 AI 工作负载中对这一 “解锁” 方案进行测试,初步结果令人振奋。
一位 Reddit 上的 RTX 3090 Ti 用户在 ComfyUI 中对该解锁方案进行了基准测试。结果显示,在运行 MOSS-Image SFT BF16 模型时,吞吐量提升了 58.6%;运行 Qwen-Image 2.1 Turbo BF16 时提升了 57.2%;运行 Z-Image Turbo BF16 时则提升了 56.1%。相比之下,在 INT8 配置下,性能提升幅度要小得多 —— 例如,MOSS-Image SFT INT8 的性能仅提升了 0.3%。此外,该测试者还指出,在 “解锁” 前后,模型解码输出的图像完全一致。
大语言模型(LLM)推理是另一个潜在的受益领域,尽管性能提升的幅度在很大程度上取决于具体的工作负载。例如,一份针对 RTX 3090 的兼容性报告显示,在使用 vLLM 时,提示词处理(prompt processing)和推理吞吐量提升了 33%,而 Token 生成速度则几乎没有变化。这不难理解,因为 LLM 的解码过程往往受限于内存带宽,而非 Tensor Core 的原始计算吞吐量。
另一个值得关注的进展是针对 Windows 系统的实验性实现方案;它采用了一种基于 UEFI 的方法,而非原有的 Linux 内核模块。开发者已成功在 RTX 3090 上实现了这一方案,使 BF16 计算吞吐量提升了约 82.5%。不过,这目前仍属于实验性质且针对特定硬件的解决方案,而非通用的 Windows 版本。
此外,该方案也存在显著局限性。GPU 解锁(GPU Unlock)并不能增加内存带宽,也无法启用额外的 CUDA 核心,更不能自动提升所有类型工作负载的性能。曾有用户在 RTX 3080 Ti 20GB 上成功执行了解锁操作,但并未获得预期的 BF16 性能提升,这表明解锁效果并非在所有情况下都一致。
在游戏方面,NVIDIA 的 DLSS 技术同样依赖 Tensor Core,但目前尚无确凿证据表明 GPU 解锁能提升游戏性能或缩短 DLSS 的执行时间。只有当实际工作负载确实调用了那些被解锁的指令集或累加模式时,性能提升才可能显现。因此,不应将亮眼的计算基准测试结果直接等同于游戏帧率(FPS)的提升。
尽管如此,对于 GeForce RTX 30 系列显卡的用户 —— 尤其是那些将显卡用于本地 AI 推理、图像生成及其他计算密集型应用的用户而言 ——“GPU 解锁” 仍是一项颇具吸引力的进展。虽然该项目目前仍处于实验阶段,但它提供了一种无需对硬件进行永久性改造,即可挖掘现有硬件潜能、显著提升性能的可能性,这无疑极具吸引力。

 ubert 10-25 09:193楼
 HeriX 10-25 09:204楼
 HLiny 10-25 09:536楼
 CodeAtlantis 10-25 10:317楼