Kimi K3.1 Pro 猫老板评测文章出炉 - “月之暗面还是愿意肩负探索的责任,把超大规模训练需要踩的坑都踩一遍”

Eeevan 2026-10-25 12:13 1

短的结论:皎皎空中孤月轮


基本情况:

就国内目前算力情况而言,训练超大尺寸模型在各方面都是巨大挑战,但月之暗面还是愿意肩负探索的责任,把超大规模训练需要踩的坑都踩一遍,把极限往前推进。K3 曾经是打破天花板的大作,独占国内最强至今,K3.1 则接着 SOTA 大旗,继续行程。

K3.1 在多方面都进行了有效改进,大幅提升服务能力的同时降价,新模型的综合任务成本也都优于前代。而且如果对速度有更高要求,还提供了高速版,其可用性将更高。


但月之暗面还是愿意肩负探索的责任,把超大规模训练需要踩的坑都踩一遍 ^-^


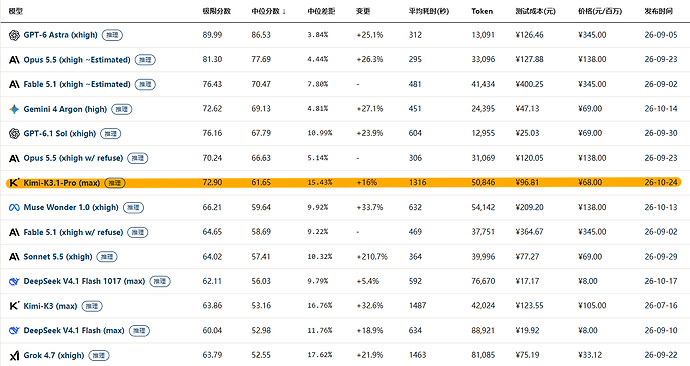
逻辑成绩:

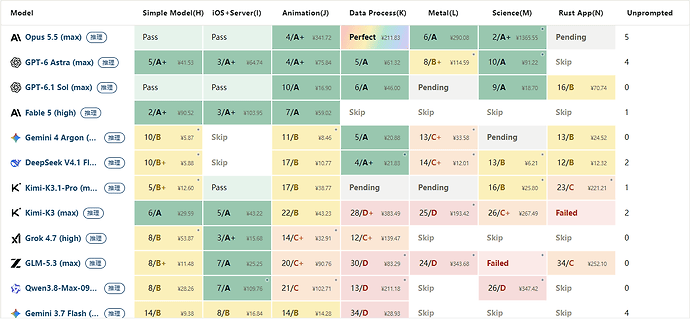
表格的排序切换为按中位分数降序。


*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。

*2 题目及测试方式,参见:大语言模型-能力横评 26-09 月榜,增加#79、#80、#81。

*3 完整榜单更新在 大语言模型-能力横评 26-09 月榜


Agent 成绩:


  • **编程任务:**考虑到之前 K3 对 Claude Code 版本很挑剔,旧版本的表现好于新版本,会导致测试结果不够理想,所以本次测试开始使用 Kimi Code 2.3.1 版本进行。K3.1 编程能力整体明显优于前代 K3,并且在多个能力项上达到国产 SOTA。但能力分化也较大。

  • 前端任务,尤其偏静态 UI 呈现的任务上,K3.1 表现出碾压级的实力,UI 细节丰富,精致,交互动画细腻,直出即达到生产级。不过 K3.1 喜欢在 UI 上用小号字体,以便在有限空间里塞入更多说明性文本,让整体看起来更精致,但这提升了阅读难度。部分 SVG icon 绘制存在少量问题,外形正常,但比例失调,看起来古怪。K3.1 在没有特别说明的情况下默认使用墨绿和金色搭配,审美高级。

  • K3.1 偶尔会忽略提示词中的微小细节要求,比如用简短术语来要求完成一个核心功能。项目 H 正是因为这种疏忽导致评级掉到 B 档,项目 M 中也存在这种情况。而 GPT、Opus 则几乎不会有这种情况(这里 GPT 指 Astra,Opus 指 Opus 5.5,下同)。不过如果将要求换一种表述,引起模型重视,则 K3.1 也可以妥善处理。可见并不是模型不会。

  • K3.1 在不使用工具情况下建模能力显著强于 K3,属于国内最强,但离全球 SOTA 还有极大差距。这方面最强的 Opus 5.5 可以在同样条件下“徒手”创建精度极高,且符合逻辑的各类模型,而 K3.1 首先是达不到相同的精度,其次对模型的逻辑功能处理不好,形似而神不似。当然,如果接上工具,K3.1 能力得到放大,这类问题也不存在了。

  • 任务效率上,K3.1 的呈现出两种截然不同的表现。前端任务通常有不错的直觉,H 项目上也能实现代码文件一次性输出,测试一遍过,不涂改。稍微复杂的前端也可以在有限步骤内完成,效率处于国内 Top,优于前代 K3,基本持平 GPT-6/6.1。但到 N 项目这类略微冷门的技术栈,K3.1 则需要不断现查文档才能逐步推进,并且验证阶段也会很不自信地多次打包,多次跑全程自检,期间也会验出真正问题,但更多时候是在反复改文案和尺寸,意义不大。

  • **幻觉:**K3.1 较前代极大幅改善,跃升至仅次于 GPT/Opus 的位置,高于 Gemini。纯信息提取类任务上对 K3.1 已经没有难度,只是达不到和 GPT 一样的稳定性。如果是带逻辑的信息提取,则 K3.1 表现稍弱,数据直觉不如 GPT。DeepSeek Flash 在这类任务上反而表现更好。

  • **复杂求解:**复杂任务,K3.1 能花比 K3 更多的精力(Token)去详尽求解,在各类没有唯一解,需要探索上限的任务上,K3.1 能拿到更接近 GPT(当前最高)的结果,超过 DeepSeek Flash,而且花费 Token 也仅有其一半,这正是 K3.1 作为大尺寸模型发挥优势的场景。


赛博史官曰:

某种意义上,月之暗面是一家孤独的公司,他们走在最前面,走最难的路,涉最险的境,跨最深的洋,探索前人未至,并在此过程中学习和反思。3 个月前也曾经以为 K3 开创的局面会迎来前赴后继的追随者,但事与愿违,最终接任的仍然是月之暗面自己。虽然前路多歧,但明月当空,想必也能照亮世间。


发布于 2026-10-24 23:59


逻辑成绩 Agentic 成绩

原文链接:https://mp.weixin.qq.com/s/mf6r5_z4M8Smt_STeCdlhw

知乎:https://www.zhihu.com/question/2096972346951198516/answer/2097477416973354782

最新回复 (15)
  • ANON 10-25 12:16
    1楼

    赛博史官日


    捉个虫,这个地方真的不是曰么?

  • ks 10-25 12:26
    2楼

    高情商回复 把大参数的坑都踩一遍

    低情商回复 做的和一坨一样 实在是没办法夸了 就拿来当反面例子吧

  • 卡里姆•汗 10-25 12:27
    3楼

    模型是不错,但是价格太高,kimi的问题就是模型成本下不来,订阅用不了多少额度,没有像6.1sol那种低价一点效果不错的模型,对个人生产力性价比不高

  • 果丹皮 10-25 12:27
    4楼

    所以高情商说法就是这次拉了

  • ℬ𝒶𝒾𝒲𝒶𝓃 10-25 12:30
    5楼

    模型确实练得不行,看老外也说没达到预期,不过能把3T的模型跑出来本身就是一件极大的难事

  • 竹屋 10-25 12:32
    6楼

    翻译:


    做的依托,勇气可嘉,起码努力了 ^-^

  • ks 10-25 12:32
    7楼

    跑大参数模型需要算力,但实在是没搞明白算力严重不足的情况下还搞这个是不是就是单纯没法子了,只能堆参数

    ps 算力不足是根据他那个套餐可用量说的

  • ℬ𝒶𝒾𝒲𝒶𝓃 10-25 12:36
    8楼

    不想和其他家抢同一赛道吧,都练flash模型意义不大,很难超过ds。


    1T以上模型国内真就 kimi 一家还算行,ds v4 pro 也就一般般,等ds41pro吧看看会不会好点。

  • ks 10-25 12:38
    9楼

    行在什么地方()除了前端之外,后端跟glm5.3 一个水平,连deepseek flash都不如

  • Quixotica11y 10-25 12:39
    10楼

    人话:Kimi3.1 Pro 这次做的不达预期,但是你们不许笑我,因为我在帮你们试错

  • 吃风筝的人 10-25 12:40
    11楼

    deepseek清楚自己的定位,没打算去死冲第一梯队,与SOTA保持1个月到3个月的差距,主打性价比,暂时也没指望靠模型盈利


    KIMI套餐价格可不便宜啊,性价比这块甚至不如外面的A和O

  • loyicnaup 10-25 13:00
    12楼

    省流:想搞个大新闻结果只有规模和刷分能力上去了

  • 白头翁 10-25 13:00
    13楼

    大肥鱼排名这么靠前吗?刷新我的认知了

  • 钟阮 10-25 13:03
    14楼

    我觉得不如KimiK3.1丢给智谱去疯狂后训练吧

  • lseraph 10-25 13:06
    15楼

    也算是非常隐晦了,感觉现在猫老板的评语都只能是这个风格

* 帖子来源Linux.do
返回