^-^ ruyiJS
新一代、专为 AI 驱动打造的极简浏览器。
原生的 Firefox JavaScript 引擎与网络栈,没有窗口、没有渲染器 ——
专为网页抓取、JS 逆向、数据采集与绕过人机验证而生。
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
^-^ 攻克的验证系统
每个示例都驱动站点自身的 JavaScript 生成其所需参数,再端到端完成流程。全部随包可运行:python -m ruyijs.examples <名称>。
系统 |
类型 |
示例 |
|---|
瑞数 Ruishu 5/6 |
动态 VM / 页面防护 |
fangdi · cebwm |
极验 Geetest |
滑块 / 一键通过 |
geetest |
腾讯天御 Tencent Captcha |
无感 + 滑块 |
tianyu |
数美 Shumei |
滑块 |
shumei |
网易易盾 NetEase Yidun |
智能验证 |
yidun |
Arkose Labs + iovation |
企业风控 / 设备指纹 |
expedia-taap |
CreepJS |
指纹审计 —— 全部项目通过 |
creepjs |
完整的生产级数据采集流程:BOSS 直聘、今日头条、抖音、小红书、Google、Expedia TAAP。
^-^ 严禁用于任何非法用途,仅用于研究新时代 AI 浏览器。 线上结果取决于当前网络状况与各站点的实时响应。
^-^ 运行示例
示例随包安装,无需下载仓库:
python -m ruyijs.examples                      # 列出全部示例及其安装路径

python -m ruyijs.examples google --query python --pages 1

python -m ruyijs.examples boss --query ai --city 101210100

python -m ruyijs.examples fangdi               # 网上房地产(瑞数 6)

python -m ruyijs.examples cebwm --pages 3      # 光大理财(瑞数定制)

python -m ruyijs.examples toutiao --pages 3    # 今日头条

python -m ruyijs.examples xhs --pages 3        # 小红书 rednote 推荐流

python -m ruyijs.examples geetest              # 极验一键通过

python -m ruyijs.examples yidun                # 网易易盾

python -m ruyijs.examples shumei               # 数美滑块

python -m ruyijs.examples tianyu               # 腾讯天御
示例均支持 --direct(直连)和 --proxy http://127.0.0.1:7890,在名称后加 --help 查看全部参数,--output result.json 可保存结果。各示例目录内附 README。
ruyiJS 适合你吗?
Headless Chrome 和 Playwright 给你的是一整个浏览器:一个负责 GPU 渲染、管理窗口、吃内存的进程,而反爬厂商已经花了多年时间学习如何识别它。ruyiJS 走的是相反的路 —— 只嵌入与自动化真正相关的 Firefox 内核,其余一概不要:
- 原生引擎,而非模仿。 货真价实的 SpiderMonkey(Firefox 158)与 Necko 网络栈,会像 Firefox 一样原样执行站点的 JavaScript、challenge、签名与指纹。
- 真正无头。 没有窗口、没有布局、没有渲染器。纯 JavaScript + Web API 环境,启动快、占用低。
- 隔离且可复现。 每个
Context 都是独立进程,拥有持续保存的 JavaScript 世界与自己的代理,会话之间互不干扰。
- 需要时可离线。 自己提供脚本与响应,无网络也能复跑整条已捕获的流程。
如果你做网页抓取、逆向 Web JavaScript,或采集 challenge 背后的数据,它就适合你。如果普通 HTTP 客户端已经能拿到页面,那就不需要它。
运行于 Windows x64,需要 Python 3.10+(已在 Python 3.14 下验证)。wheel 内置锁定版原生运行时,无需再下载任何东西。
^-^ 快速开始
1 · 安装。
python -m pip install ruyijs
wheel 内置 SHA256 锁定的 SpiderMonkey + Necko 运行时;安装后本地脚本可离线运行,无需下载浏览器。
2 · 打开上下文,执行 JavaScript。 同一上下文内,变量和函数在多次 eval 之间保留。
from ruyijs import Context


with Context() as context:

    context.eval("let count = 40")

    print(context.eval("count += 2"))        # 42

    print(context.eval("navigator.userAgent"))
3 · 对准真实目标。 配置环境、加载页面,让站点自身的 JavaScript 去生成它所需的 token。
with Context(proxy="http://127.0.0.1:7890") as context:

    context.configure_fingerprint({

        "navigator": {"language": "zh-CN", "hardwareConcurrency": 8},

        "locale": {"timezone": "Asia/Shanghai"},

    })

    context.load_page("https://target.example/", html)

    token = context.eval("window.__sign(payload)")   # 调用页面自己的签名函数

    print(token)
^-^ 整体结构
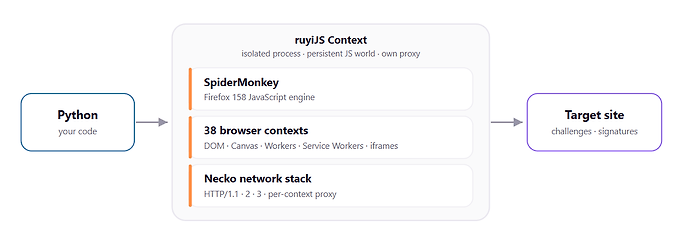
Python  ──►  ruyiJS Context(独立进程)  ──►  目标站点

                 ├─ SpiderMonkey —— Firefox 158 JS 引擎

                 ├─ 38 个浏览器上下文 —— DOM · Canvas · Worker · iframe · …

                 └─ Necko —— HTTP/1.1 · 2 · 3,按上下文独立代理
你的 Python 代码驱动一个 Context。在其中,原生 SpiderMonkey 引擎针对真实 DOM 与 38 个受限浏览器子系统运行页面脚本,页面内的 fetch/XHR 走 Necko 传输。实现代码位于 src/(领域层、应用层与各浏览器子系统)与 python/ruyijs/(Python 绑定)。
^-^ 功能
运行站点的 JavaScript
在持续保存的上下文中执行脚本,加载含 iframe 与经典脚本的真实 HTML,并查询生成的 DOM。对存活 JS 对象的引用会作为可从 Python 调用的 JSObject / JSFunction 返回。
功能 |
用法 |
|---|
执行 JS 并保留状态 |
context.eval(src) —— 变量和函数持续保留 |
取回可调用对象 |
context.eval(src, to_py=False) → JSFunction |
加载页面 |
context.load_page(url, html) —— 相对地址按 url 解析 |
顶层导航 |
context.navigate(url) —— 无 Referer,Sec-Fetch-Site: none |
查询 DOM |
context.eval("document.querySelector('#x').textContent") |
with Context() as context:

    context.set("config", {"offset": 2})

    add = context.eval("(value) => value + config.offset", to_py=False)

    print(add(40))  # 42
配置浏览器环境
通过一套带校验的 profile 接口设置 Navigator、Screen、视口、时区与区域。请在首个页面脚本运行前提交。
with Context() as context:

    context.configure_fingerprint({

        "navigator": {"language": "zh-CN", "hardwareConcurrency": 8},

        "screen": {"width": 1920, "height": 1080},

        "viewport": {"width": 1280, "height": 720},

        "locale": {"timezone": "Asia/Shanghai"},

    })

    print(context.eval("[navigator.language, screen.width]"))  # ['zh-CN', 1920]
基于 Necko 的原生网络
页面内 fetch 与 XHR 走真实 HTTP/1.1、2、3,并通过按上下文隔离的代理。用 put_resource() 自行提供响应即可离线复跑整条已捕获的流程。用 net_log() 查看每一次请求。
with Context(proxy="http://127.0.0.1:7890", timeout=30) as context:

    context.load_page("https://example.com/", "")

    context.eval("globalThis.r = null; fetch('/api').then(x => x.json()).then(v => r = v)")

    context.advance(25)               # 推进事件循环直到稳定

    print(context.eval("r"))
Python ↔ JavaScript 互通
用 set() 传入数据,取回可调用的 JS 函数,并把 Python 函数暴露给运行中的脚本。含 Worker、Service Worker 与 iframe。
with Context() as context:

    context.expose(lambda a, b: a + b, "add")

    print(context.eval("add(20, 22)"))  # 42
确定性时钟
用逻辑时钟驱动定时器以获得完全可复现的运行,或用系统时钟进行实时作业。时间由宿主显式推进。
with Context() as context:

    context.configure_clock("logical", epoch_ms=1700000000000)

    context.eval("globalThis.result = 0; setTimeout(() => { result = 42 }, 10)")

    context.advance(10)

    print(context.eval("result"))  # 42
错误与日志
JavaScript 异常会作为带 name、message、stack 的 JSError 抛出。console_log() 与 net_log() 返回已捕获的 console 和网络记录。
from ruyijs import Context, JSError


with Context(timeout=10) as context:

    try:

        context.eval("throw new TypeError('bad input')", filename="demo.js")

    except JSError as error:

        print(error.name, error.message)  # TypeError bad input

        print(error.stack)

 往事随风k 10-26 22:521楼
 shawny 10-26 22:532楼
 Yawanaika 10-26 22:533楼
 suchasplus 10-26 23:294楼
 潜水艇 10-26 23:305楼