artificialanalysis.ai 更新了Index v5,并更新了排名

软糖静 2026-10-28 10:52 1
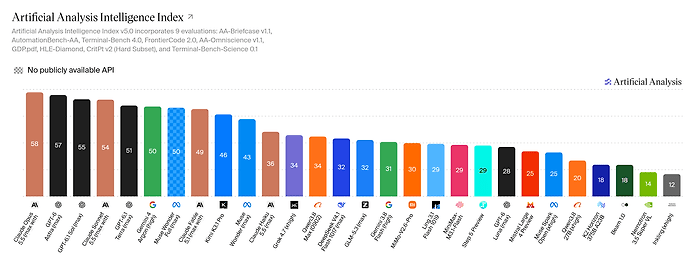


来源:X 上的 Artificial Analysis:“Announcing Artificial Analysis Intelligence Index v5, featuring 2 new benchmarks and 3 upgrades. For the first time, the majority of the Index is built on private datasets The Artificial Analysis Intelligence Index is our composite measure of model capabilities across tas… / X

最新回复 (13)
  • anbuzhidao 10-28 10:55
    1楼

    参考看看就行了,国模也确实有较大差距,但是这个榜单应该有一定的赛博黑社会性质。。。。

  • linlin 10-28 10:58
    2楼

    自从astra出来那会评分比calude的opus5还是其他型号低,就成了野榜了 ^-^

  • kinda66 10-28 10:59
    3楼

    又变成了oa争霸,刷的分都吐回去了。

  • Hardship2495 10-28 10:59
    4楼

    虽然是野榜,但是 MiMo 这次更新马上就掉了这么多排名,难绷 ^-^

  • 艾尔 10-28 11:03
    5楼

    榜单能一直更新就挺好,Astra 之前还不如 muse wonder 呢,现在已经多了16 分了,差不多 3 代的差距了。。


    挺好的,人家还是有追求,不像国内某些榜单就是纯商单。

  • Oaki Doki 10-28 11:04
    6楼

    比之前更符合体感 比如mimo 2.6 pro的意图识别都差,做出东西也一般,其实没比 glm 5.3 好太多。之前的榜单里这些模型都刷到比 glm 5.3 好很多的分数了。现在 glm 5.3 ds 4.1 flash 都接近了。


    K3.1 pro 本来也比不了 gpt 6.1 sol, 现在差距出来了。6.1 sol 同时存在有它自己的优化目标的问题,但是它能反思到自己哪里错了,几乎是不太思考用直觉就能反思到,做事也比k3.1严谨。k3.1的前端优势也不大了,在 low下的前端能力和ds 4.1 flash 1017也差不多了。


    确实暴露了国模的 eval 和训练数据的问题。

  • LIFE001400 10-28 11:07
    7楼

    那要问问,这个更新到底是哪个模型口碑好,就针对性的更新,让那个模型的分数高?还是真的在自主迭代呢?哪个模型口碑好,就专门更新,让哪个模型分数高。那这所谓的排行榜还有权威性和独立性?更别提所谓的追求。

  • alan.x 10-28 11:08
    8楼

    新基准没法针对性练习,排行看起来也比较符合体感。

    前10国模就kimi排第九,现在就看glm、v4.1pro憋完气能不能往前10挺一下了

  • 艾尔 10-28 11:19
    9楼

    之前 deepswe 基本上是 l 站的指导榜,后面被刷爆了就没有。如果能一直更新就挺好。


    其实你说的 2 者可能是并行的,目前 oa 就是断档的强,是那种瞎眼可见的断档,随便哪个私有题库,只要是新的,基本上就是碾压。

    而那些公开的榜,只要哪个榜排低了就会被人称为野榜。


    人家oa也根本不在意榜单的数据,而且人家内部榜肯定远超第三方的。


    所以自主迭代的同时往前沿模型的标准去靠难道是错误的吗?


    至于口碑,人家不会为 DeepSeek 的口碑更新吧。。起码。。这次国模第一还是 kimi ,第二换成了千问,这 2 个都是超大尺寸模型。。

    DeepSeek 和 glm 同分了,这个难道没有参考性吗。

  • Oaki Doki 10-28 11:19
    10楼

    当时 astra 的一些能力应该是 oai 内部数据和eval 塑造出来的,而当时aa的eval根本测不出这些能力,反而给一些饱和的能力权重。


    Eval要不断纳入新的能力提升的方向的。假如1年后有个面向fde优化的模型特别擅长理解各种公司组织的人际关系,实际决策方式,各种文件和会议哪些是表演,什么时候找谁问问题,哪些是真的信号,这是非常聪明的模型。假如让这个模型测试今天的榜单,这个能力也很难给它加分。

  • 木原金 10-28 11:33
    11楼

    能不能把单任务token多价格高的扣个分啊,这榜单还在鼓励雷霆思考

  • LIFE001400 10-28 12:02
    12楼

    我从来没有说过自主迭代是错误的,我已经指明了。自主迭代还是向前沿模型靠近?这两者可不是像你说的那样可以同时并行的。


    还要我把话说的更清楚吗?GPT 的 Astra 出来之后和 5.6 Sol 同分,Claude 模型在之前的 AA 榜上简直是外星科技,全部都是前几。


    然后这次更新之后,就把 Claude、GPT 均匀的分布了。针对模型口碑进行更新,不可笑吗?


    向前沿模型的标准靠近是指什么?模型好,所以你是前沿的,那我就要以你为准去更改我的排行榜?


    要自主迭代就自主迭代,要以别人的模型为标准,那就是以别人的模型为标准,就是一个垃圾榜单。不要扯自主迭代的同时是以前沿模型为标准。

  • kinda66 10-28 12:07
    13楼

    口碑才是真的,刷分都是虚的。大家异口同声叫好叫衰的测试反映不出去,那就失去测试的意义了。

* 帖子来源Linux.do
返回