各位佬们是如何看aa这个网站的

xiaofeifeiovo 2026-10-29 23:45 1
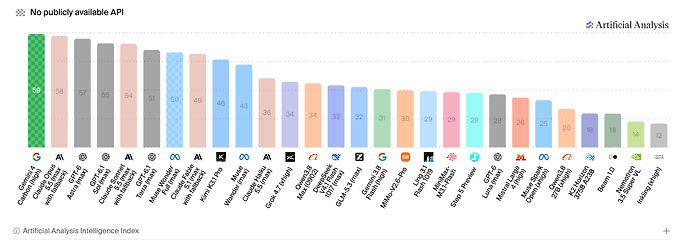
artifical analysis最近又更新榜单的计算方式了,最新排名如下:


更新之前chatgpt 和 claude 的前沿模型是有巨大分差的,更新之后只差了一分了。


模型本身的能力没有多大改变,但是aa改变了评价模型的方式,计算出来的分值就出现了巨大的变化。并且aa很常做这种更新。还记得astra刚出的那会和fable差距很大,aa连着更新了几次计算方式,把astra 和 fable的分数拉到了近似的水平。。


aa这种’不稳定‘的榜单很难让人比较信服。


另外到现在aa的官网上还挂着一点参考价值都没有的end-to-end response time。我们都知道像是chatgpt,claude是不输出思维链详细内容的,于是aa就把思考的时间计算到了ttft时间内;同时像deepseek这样的模型是输出思维链的,但是它没有计算真实的思考时间,而是给出了一个较小的预期思考token数量,直接把这个token数目除以tps来得到思考时间。。。就很,草台班子,懂吗


但是aa是通过对于多个榜单进行加权平均来打分的,这种天然比别的榜单高一个层次的综合性让我一直将aa作为一个相对重要的参考。同时aa还提供了token use 和 cost per task 这种很有用的数据。


这就让我对于aa的看法很矛盾,佬们是怎么看的呢?

最新回复 (7)
  • 女巫在说谎~啊~ 10-29 23:49
    1楼

    本身测试集就是公开的,很容易被刷榜,这次更新又莫名其妙加了科研能力的权重,导致一众小模型的排名倒退

    这么说吧,和国内野榜的区别是 这是国外的野榜

  • mi tu 10-29 23:51
    2楼

    我觉得aa的榜就更新那几天之前的模型是准的(还有没人刷的写作榜也很准)

  • maximo 10-29 23:52
    3楼

    虽然大家都说野榜,但是替代品是什么呢?

    还有刷榜本身也是知识本身,我把知识都吃完了

    从机器学习深度学习的test set来看是泄漏和作弊

    从大模型角度看,是食用,不刷怎么上去

  • blacksein 10-30 00:03
    4楼

    感觉只能大致参考用 不能太当真

    具体模型还是要在自己项目里尝试一下再看看是否合适

  • jones_melton 10-30 00:08
    5楼

    就我用这几个模型的体感来说,这个榜单确实偏袒闭源大厂。Muse wonder 和 gemini flash 在榜上跟排名挨着它们的那些模型比,差得不是一点半点。


    再加上榜里还挂着一个没发布的模型,看着就让人心里没底。我很清楚有些模型根本没这张图标的那么强,而最强的那个偏偏是我自己没法验证的?这个我没法信。


    (本文由 deepseek v4.1 flash 机器翻译)

  • astrostar 10-30 00:21
    6楼

    方法论公开的,测试了大量模型的,各个领域都有涉及的综合性榜单,除了aa还有谁吗?它确实是独此一家。

  • sandiferresner 10-30 00:23
    7楼

    他收 AI 模型厂商的钱,又出评测榜单, 利益纠缠不清的。这本来就做不到公正客观, 所以看看就好。

* 帖子来源Linux.do
返回