glm5.2也是降智?而且远不如deepseek

anycallzhf 2026-06-22 18:06 1
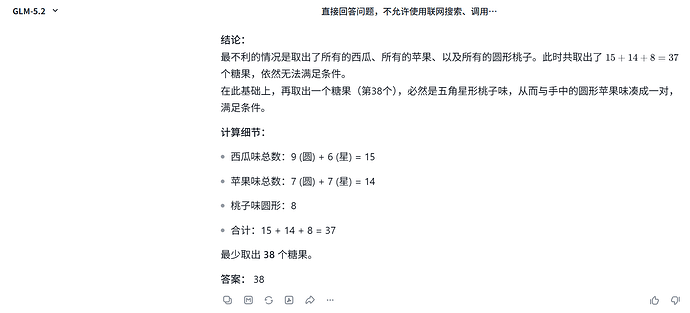
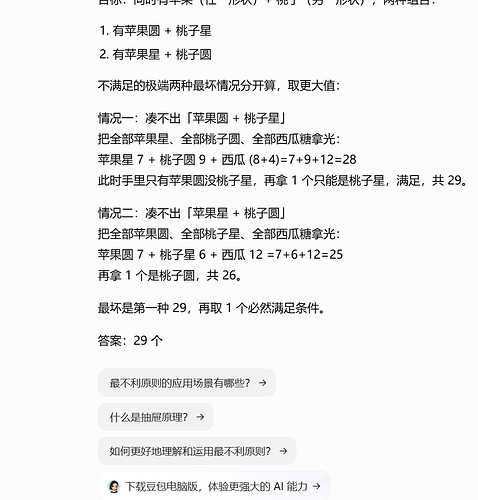
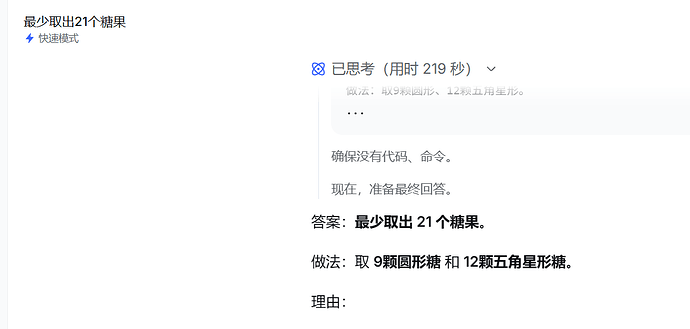
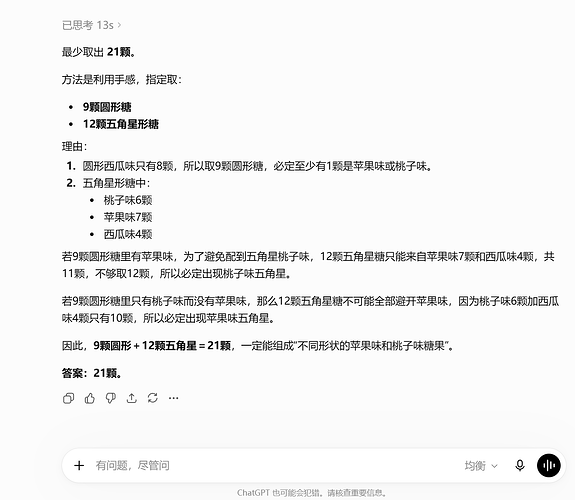
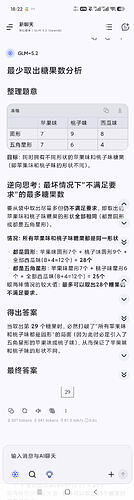
用了佬友一个测试GPT 5.5测试降智的题目来测试GLM 5.2,结果错的离谱,甚至还不如豆包,只有deepseek和不降智的gpt 5.5做对了。

题目:

直接回答问题,不允许使用联网搜索、调用命令、代码文件:在一个黑色的袋子里放有三种口味的糖果,每种糖果有两种不同的形状(圆形和五角星形,不同的形状靠手感可以分辨)。现已知不同口味的糖和不同形状的数量统计如下表。参赛者需要在活动前决定摸出的糖果数目,那么,最少取出多少个糖果才能保证手中同时拥有不同形状的苹果味和桃子味的糖?(同时手中有圆形苹果味匹配五角星桃子味糖果,或者有圆形桃子味匹配五角星苹果味糖果都满足要求)苹果味 桃子味 西瓜味圆形798五角星形764


答案:


最新回复 (11)
  • peop 06-22 18:09
    1

    glm是coding特化的模型 不能和这些全能模型比 ds的数学能力很强的(v4flash新版这么强吗居然能做对 之前可不行

  • 凉橙 06-22 18:10
    2

    这又不是什么通用方法,你用在glm里干嘛,原理你都搞不懂,瞎用

  • anycallzhf 楼主 06-22 18:11
    3

    管它通用不通用,至少codex可以测试降智。而且豆包也错了,还有gpt5.5网页版非家宽节点也是错误的,只有家庭宽带节点回答正确。不过gemini是什么节点都正确

  • miya 06-22 18:11
    4

    有没有可能 glm 是编程特化模型?推理拉的一坨,不然凭什么这么小参数量能把代码能力做到可用地步?有得必有失

  • anycallzhf 楼主 06-22 18:13
    5

    补充一个,grok也错了,当然使用的垃圾节点。

    另外测试codex是Plus就正确,gpt 5.5网页版如果是垃圾节点就错误,家宽节点正确。gemini无论什么节点也正确。证明ai之间的能力还是有差距,和降智有关也和模型能力有关

  • 凉橙 06-22 18:13
    6

    你用没降智的glm-5.2去测试一下看看回答多少,不是29等于降智是吧

  • anycallzhf 楼主 06-22 18:14
    7

    我直接用的智谱清言官网回答的,官网应该不会降智吧?

  • AmeowCAT 06-22 18:17
    8

    感觉是不是有点理解错了降智 不是指之前做得出来 后面又测试做不出来了吗

    glm-5.2之前做得出来么

  • gezidd 06-22 18:23
    9


    因为电脑不在身边 所以拿rikkahub跑了一遍 给出的答案是29

  • emiyaLinux 06-22 18:27
    10

    不是,楼主到底懂不懂什么叫编程特化、针对长程任务调优的模型?

    智谱在很大程度上是放弃了toc的,字节都烧不动toc,更别说智谱了。

    所以智谱另辟蹊径,选择了coding这一条路。

    拿一个模型干它不擅长的事情,干不好就说是降智,这是否有点过分了?

  • admin 06-22 18:36
    11

    gpt5.5 现在恢复智力了吗?

* 帖子来源Linux.do
返回