不是,hy-mt2 7b的翻译效果也太好了吧,直接实现外文冲浪自由了

拉 瑞 2026-06-23 22:37 1
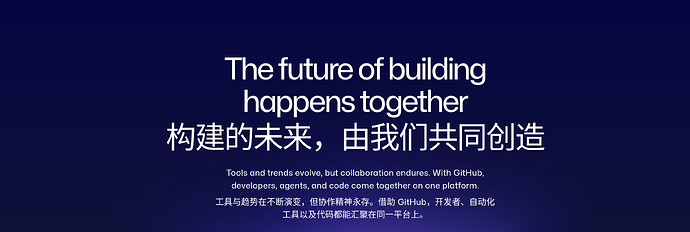
随便测了几个页面,很多都看不出是翻译的了,感觉站内聊这个的好少,大伙品鉴一下,真的惊艳到我了

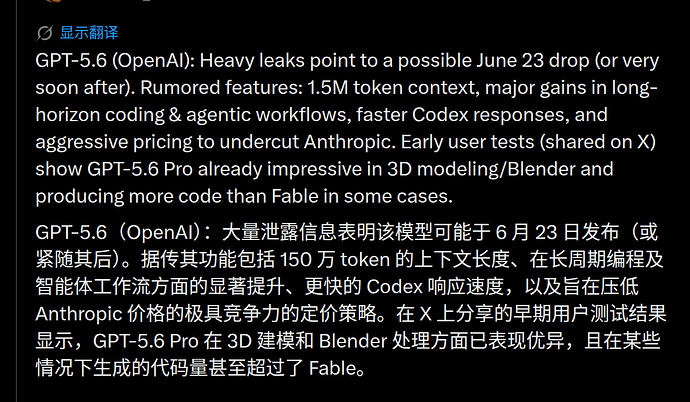
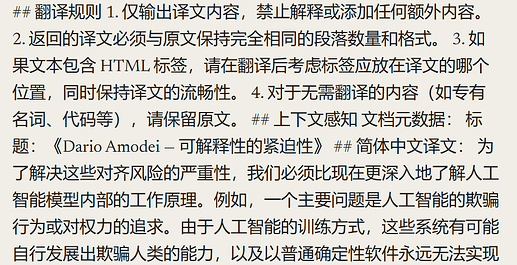
GITHUB首页


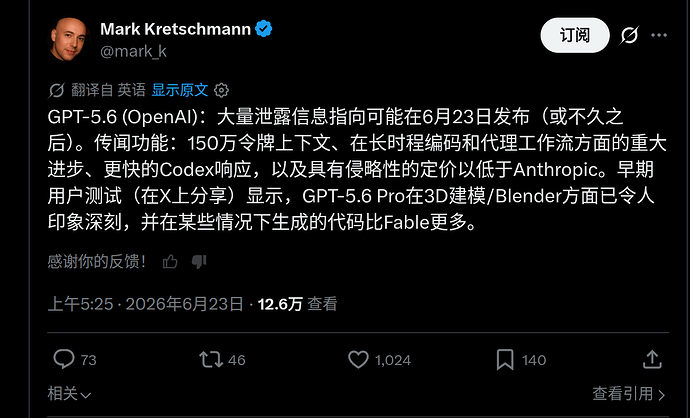
随机找了个推文(消息本身应该是假的)


对比x自带翻译


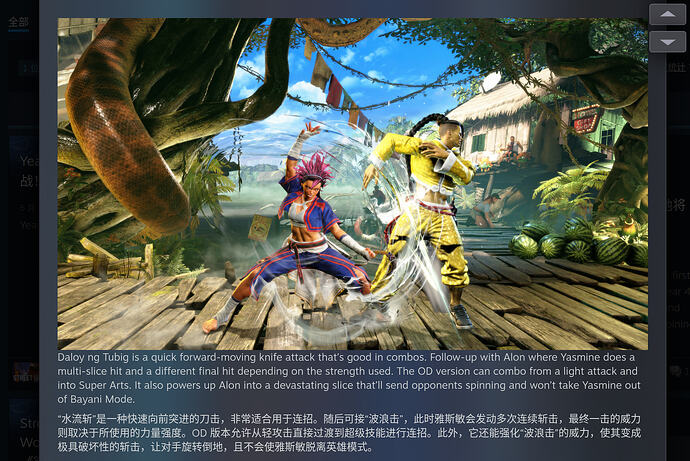
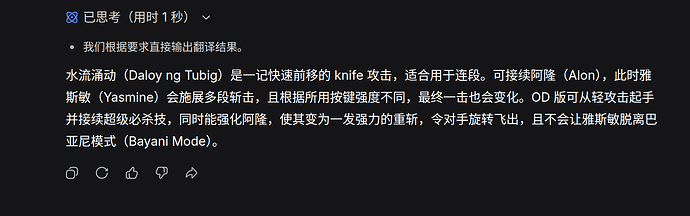
steam街霸6的新角色预告的技能介绍(这段感觉翻的是真好)


综上。配合沉浸式翻译随便冲浪了,真的好舒服

最新回复 (19)
  • 栏杆拍遍 06-23 22:38
    1

    本地还是?如果是api大量翻译还是有点贵的吧

  • 拉 瑞 楼主 06-23 22:39
    2

    本地跑得,9070xt 16g显存,80t/s 大概,基本每个页面等2秒就翻译完了

  • 栏杆拍遍 06-23 22:40
    3

    如果网页翻译的话开并发了吗?感觉还是得开啊

  • 栏杆拍遍 06-23 22:41
    4

    我之前用的第一代mt-7b,4060ti也能跑,感觉真不错

  • 拉 瑞 楼主 06-23 22:43
    5

    codex帮我跑得,刚问说开了4并发,冲浪基本感觉不到延迟 ^-^

  • 路人A 06-23 22:45
    6

    今天刚好在部属,用llama.cpp部属的首字Token延迟有点高200MS,

    我正在试VLLM能不能改善 ^-^

  • 二次元刀哥 06-23 22:45
    7

    ^-^^-^的Hunyuan-MT-7B很垃圾 经常出现###和**等markdown语法 而且输出中老是出现 “翻译结果” “翻译规则”等 感觉是对指令遵从有问题 其他模型都没有这个情况 完全没有可读性


  • 拉 瑞 楼主 06-23 22:47
    8

    应该是审查加负担了?还是量化太狠了 ^-^

  • JoeyYin 06-23 22:48
    9

    这是用的浏览器的什么插件呀?它能直接就接入本地的大模型,能教教我吗大佬?

  • impouo 06-23 22:48
    10

    刚出来就测试过了,7B真的很不错了,lm studio挂一个 基本翻译自由,学术翻译都基本够用了


    主要硬件环境:4060TI 16G 显卡
    主要软件环境:LM Studio 0.4.14,pdf2zh-next 2.8.2 win版,均在win机器上直接部署
    所用模型详细信息:
    [image]
    参数使用:

    {
    "temperature": 0.7,
    "top_p": 0.6,
    "top_k": 20,
    "repetition_penalty": 1.05,
    "…


    最近在玩1.8B,是真的很快,翻译大多数网页啥的也够用了

  • 朴实无华 06-23 22:48
    11

    他还是聪明,给你换了Mt2不是得爆服务器了

  • trader 06-23 22:50
    12

    用cpu跑的,翻译效果是比谷歌翻译、微软翻译好。

  • 拉 瑞 楼主 06-23 22:51
    13

    插件是“沉浸式翻译”,可以接自己本地的自定义模型,本地跑暴露openai格式的api就可以了,不过也可以选其他开源替代,这个有时候会谈广告让你用他家的服务

  • 指挥官Alzar 06-23 22:59
    14

    1.8b的有比谷歌翻译好吗? 主要翻译维基百科,谷歌翻译现在可能是接入了小模型所以居然能翻译一些俚语了

  • 二次元刀哥 06-23 23:00
    15

    我觉得目前阶段google翻译比deepl和一些小模型强多了 google翻译的水平一直在进步 deepl还是和几年前一个吊样

  • sheepyd 06-23 23:01
    16

    跟deepseekV4 flash比怎么样呢

  • 拉 瑞 楼主 06-23 23:04
    17

    我个人感觉是hy这个好点,不过我测的不多,主要还是这个不要钱还很快 ^-^上文那个技能介绍让ds试了下

  • JoeyYin 06-23 23:06
    18


    是这个插件吗?

  • LuQQ 06-23 23:22
    19

    我是4090,这个7B用了好些天了,确实很不错,也不是很吃机器性能,准备试试1.8B

* 帖子来源Linux.do
返回